AstolfoMix (Baseline / Extended / Reinforced / 21b)
- Preview here are powered by the top session of
README.mdand converting SDXL model from A1111 standalone file into diffuers via convert_original_stable_diffusion_to_diffusers.py. Settings may not being optimal (no CFG / PAG / FreeU etc). I'll replace the preview diffuser as soon as I upload the main model file.
"21b"
- Special case of "Add difference". Merge of "Extended" and "Reinforced".
- See simplified description in CivitAI and full article in Github
- CivitAI model page.
- The image below is 3584x1536 without upscaler. With upscaler, browser will break lol.

parameters

(aesthetic:0), (quality:0), (solo:0.98), (boy:0), (wide_shot:0), [astolfo], [[[[astrophotography]]]]
Negative prompt: (worst:0), (low:0), (bad:0), (exceptional:0), (masterpiece:0), (comic:0), (extra:0), (lowres:0), (breasts:0.5)
Steps: 256, Sampler: Euler, CFG scale: 4.5, Seed: 1921923808, Size: 1792x768, Model hash: 28adb7ba78, Model: 21b-AstolfoMix-2020b, VAE hash: 551eac7037, VAE: vae-ft-mse-840000-ema-pruned.ckpt, Denoising strength: 0.7, Clip skip: 2, FreeU Stages: "[{\"backbone_factor\": 1.2, \"skip_factor\": 0.9}, {\"backbone_factor\": 1.4, \"skip_factor\": 0.2}]", FreeU Schedule: "0.0, 1.0, 0.0", FreeU Version: 2, Hires upscale: 2, Hires steps: 64, Hires upscaler: Latent, Dynamic thresholding enabled: True, Mimic scale: 1, Separate Feature Channels: False, Scaling Startpoint: MEAN, Variability Measure: AD, Interpolate Phi: 0.5, Threshold percentile: 100, Version: v1.6.1
- Current version:
21b-AstolfoMix-2020b.safetensors(merge of 20 + 1 models) - Recommended version: "21b"
- Recommended CFG: 4.0
Reinforced
- Using AutoMBW (bayesian merger but less powerful) for the same set of 20 models.
- BayesianOptimizer with ImageReward.
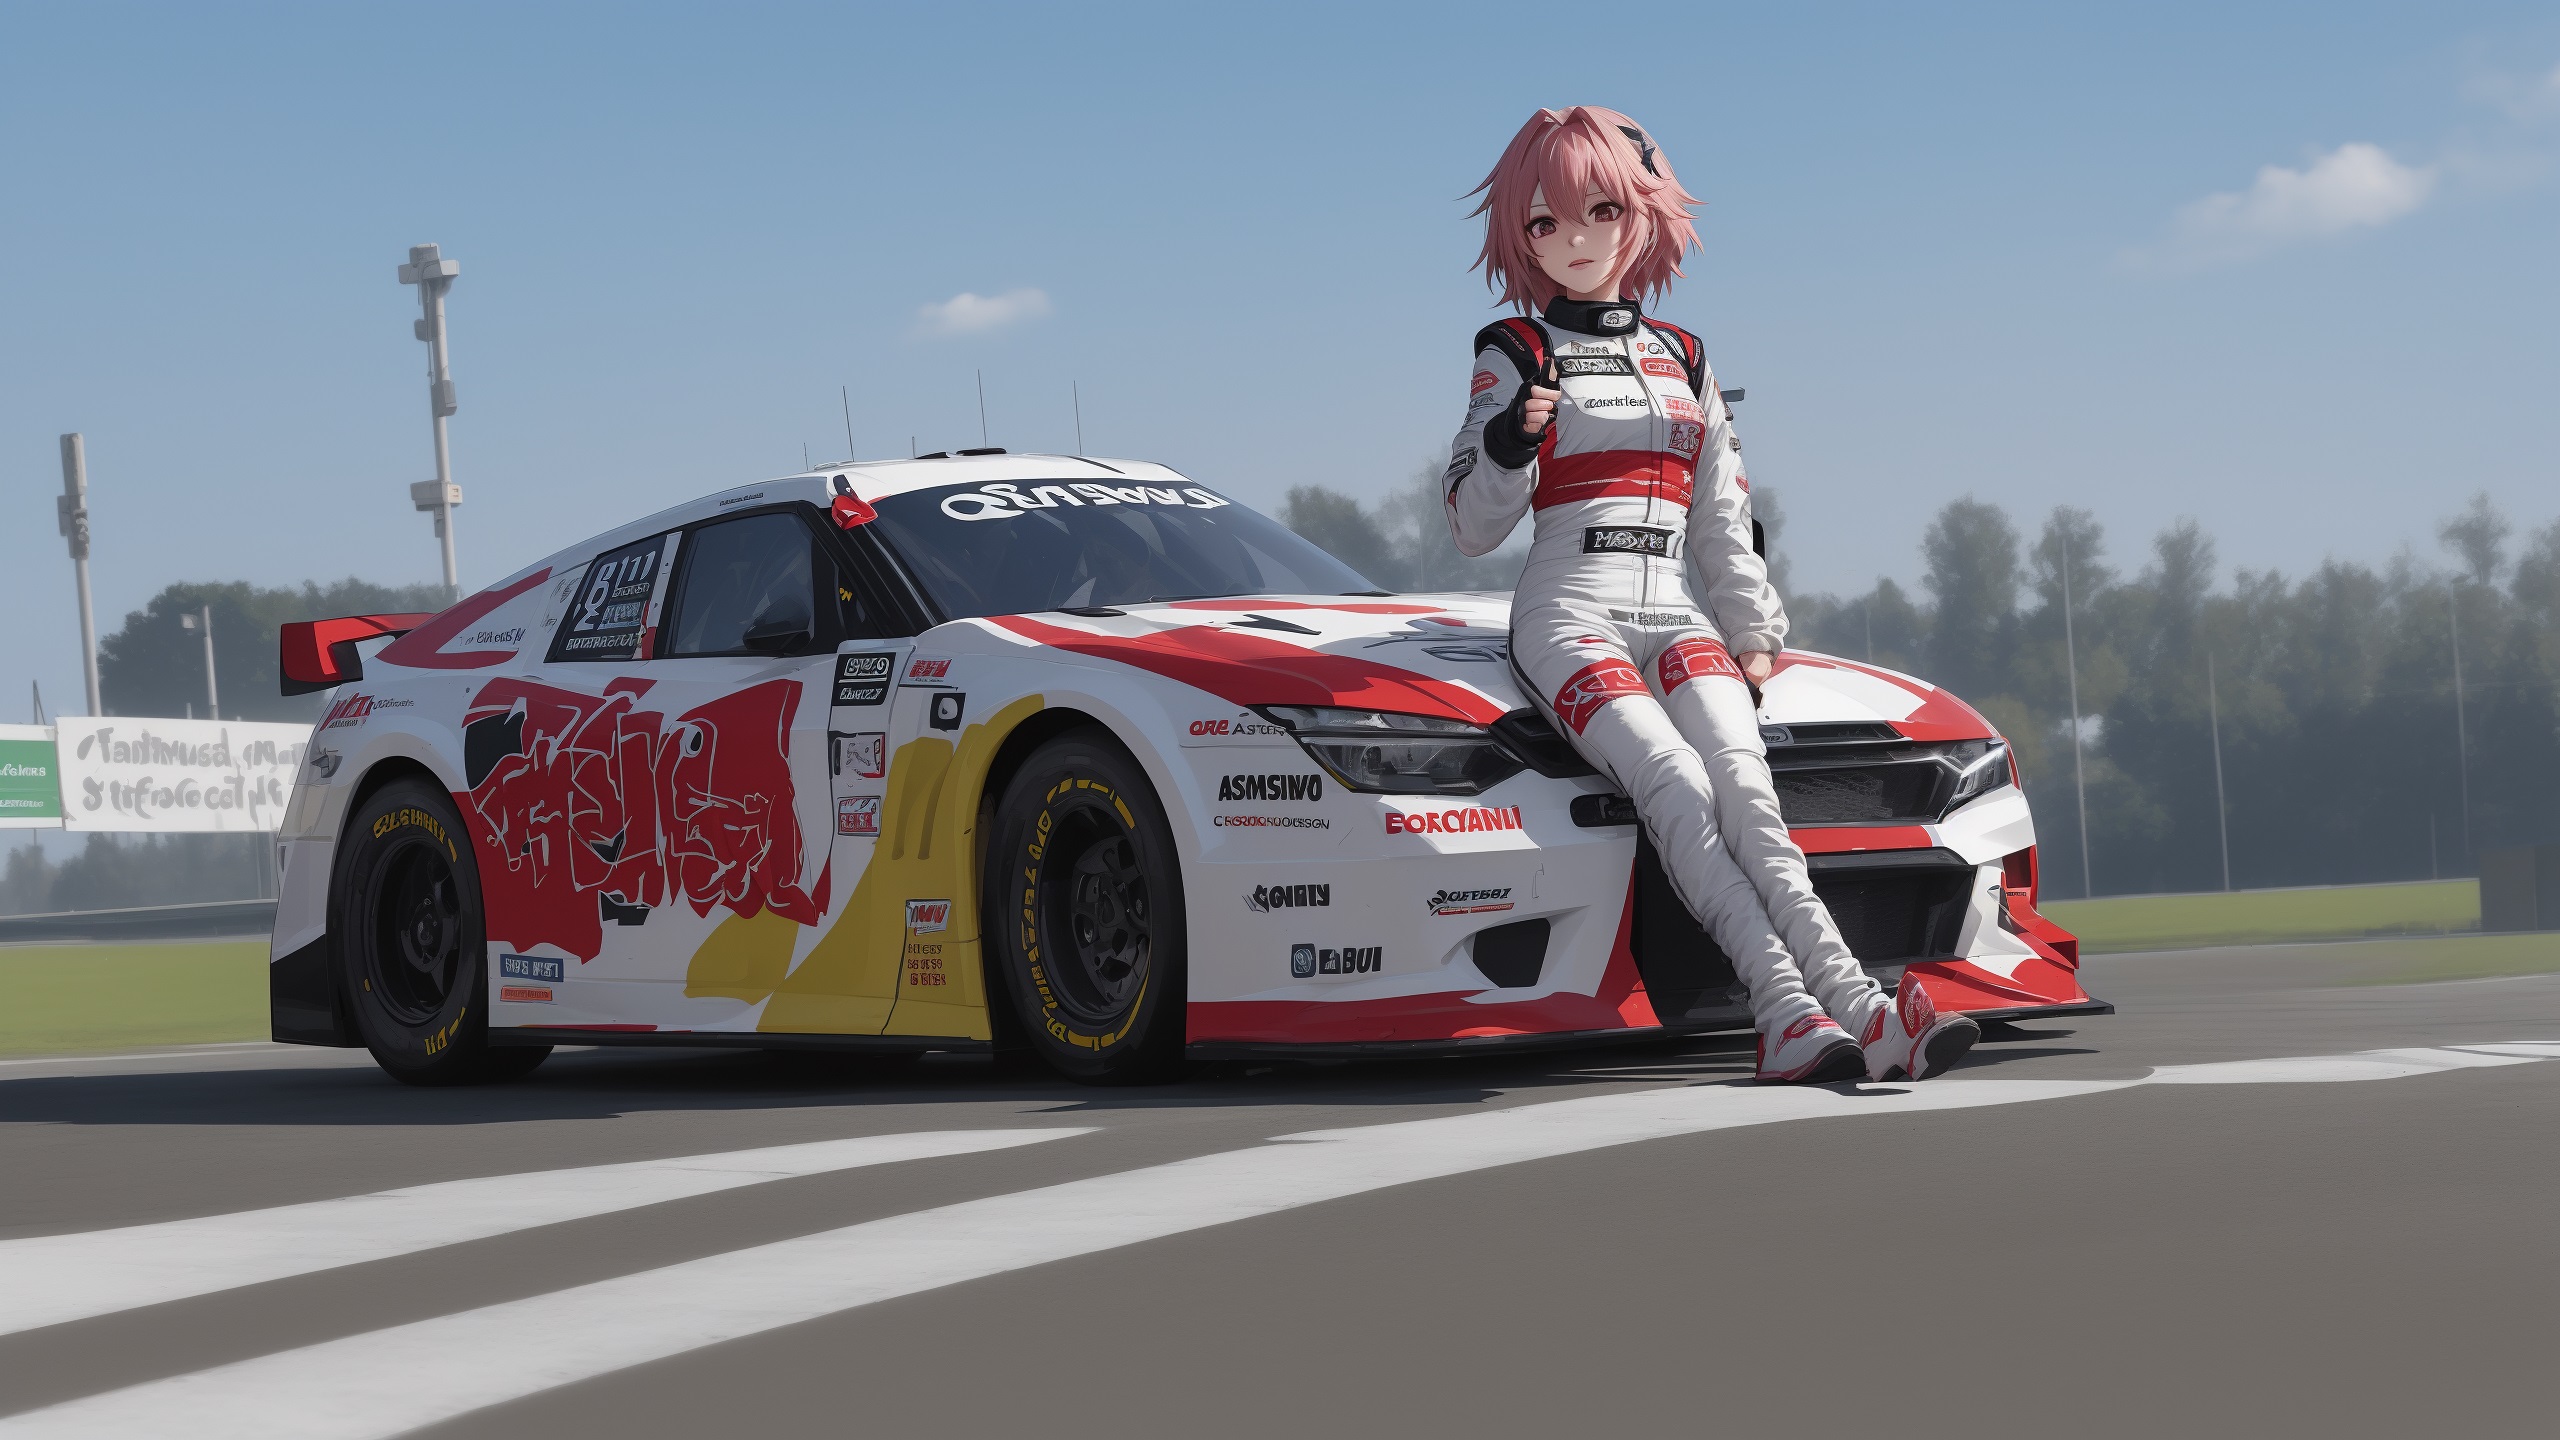
parameters

(aesthetic:0), (quality:0), (race queen:0.98), [[braid]], [astolfo], [[[[nascar, nurburgring]]]]
Negative prompt: (worst:0), (low:0), (bad:0), (exceptional:0), (masterpiece:0), (comic:0), (extra:0), (lowres:0), (breasts:0.5)
Steps: 256, Sampler: Euler, CFG scale: 4, Seed: 142097205, Size: 1024x576, Model hash: aab8357cdc, Model: 20b-AstolfoMix-18b19b, VAE hash: 551eac7037, VAE: vae-ft-mse-840000-ema-pruned.ckpt, Denoising strength: 0.7, Clip skip: 2, FreeU Stages: "[{\"backbone_factor\": 1.2, \"skip_factor\": 0.9}, {\"backbone_factor\": 1.4, \"skip_factor\": 0.2}]", FreeU Schedule: "0.0, 1.0, 0.0", FreeU Version: 2, Hires upscale: 2.5, Hires steps: 64, Hires upscaler: Latent, Dynamic thresholding enabled: True, Mimic scale: 1, Separate Feature Channels: False, Scaling Startpoint: MEAN, Variability Measure: AD, Interpolate Phi: 0.5, Threshold percentile: 100, Version: v1.6.0-2-g4afaaf8a
- Current version:
20b-AstolfoMix-18b19b(merge of 20 models) - Recommended version: "20b"
- Recommended CFG: 4.0
Extended
- Is 10 model ensemble robust enough? How about 20, with 10 more radical models?
- For EMB / LoRAs, best fit will be models trained from NAI.
Just use them, most of them will work.
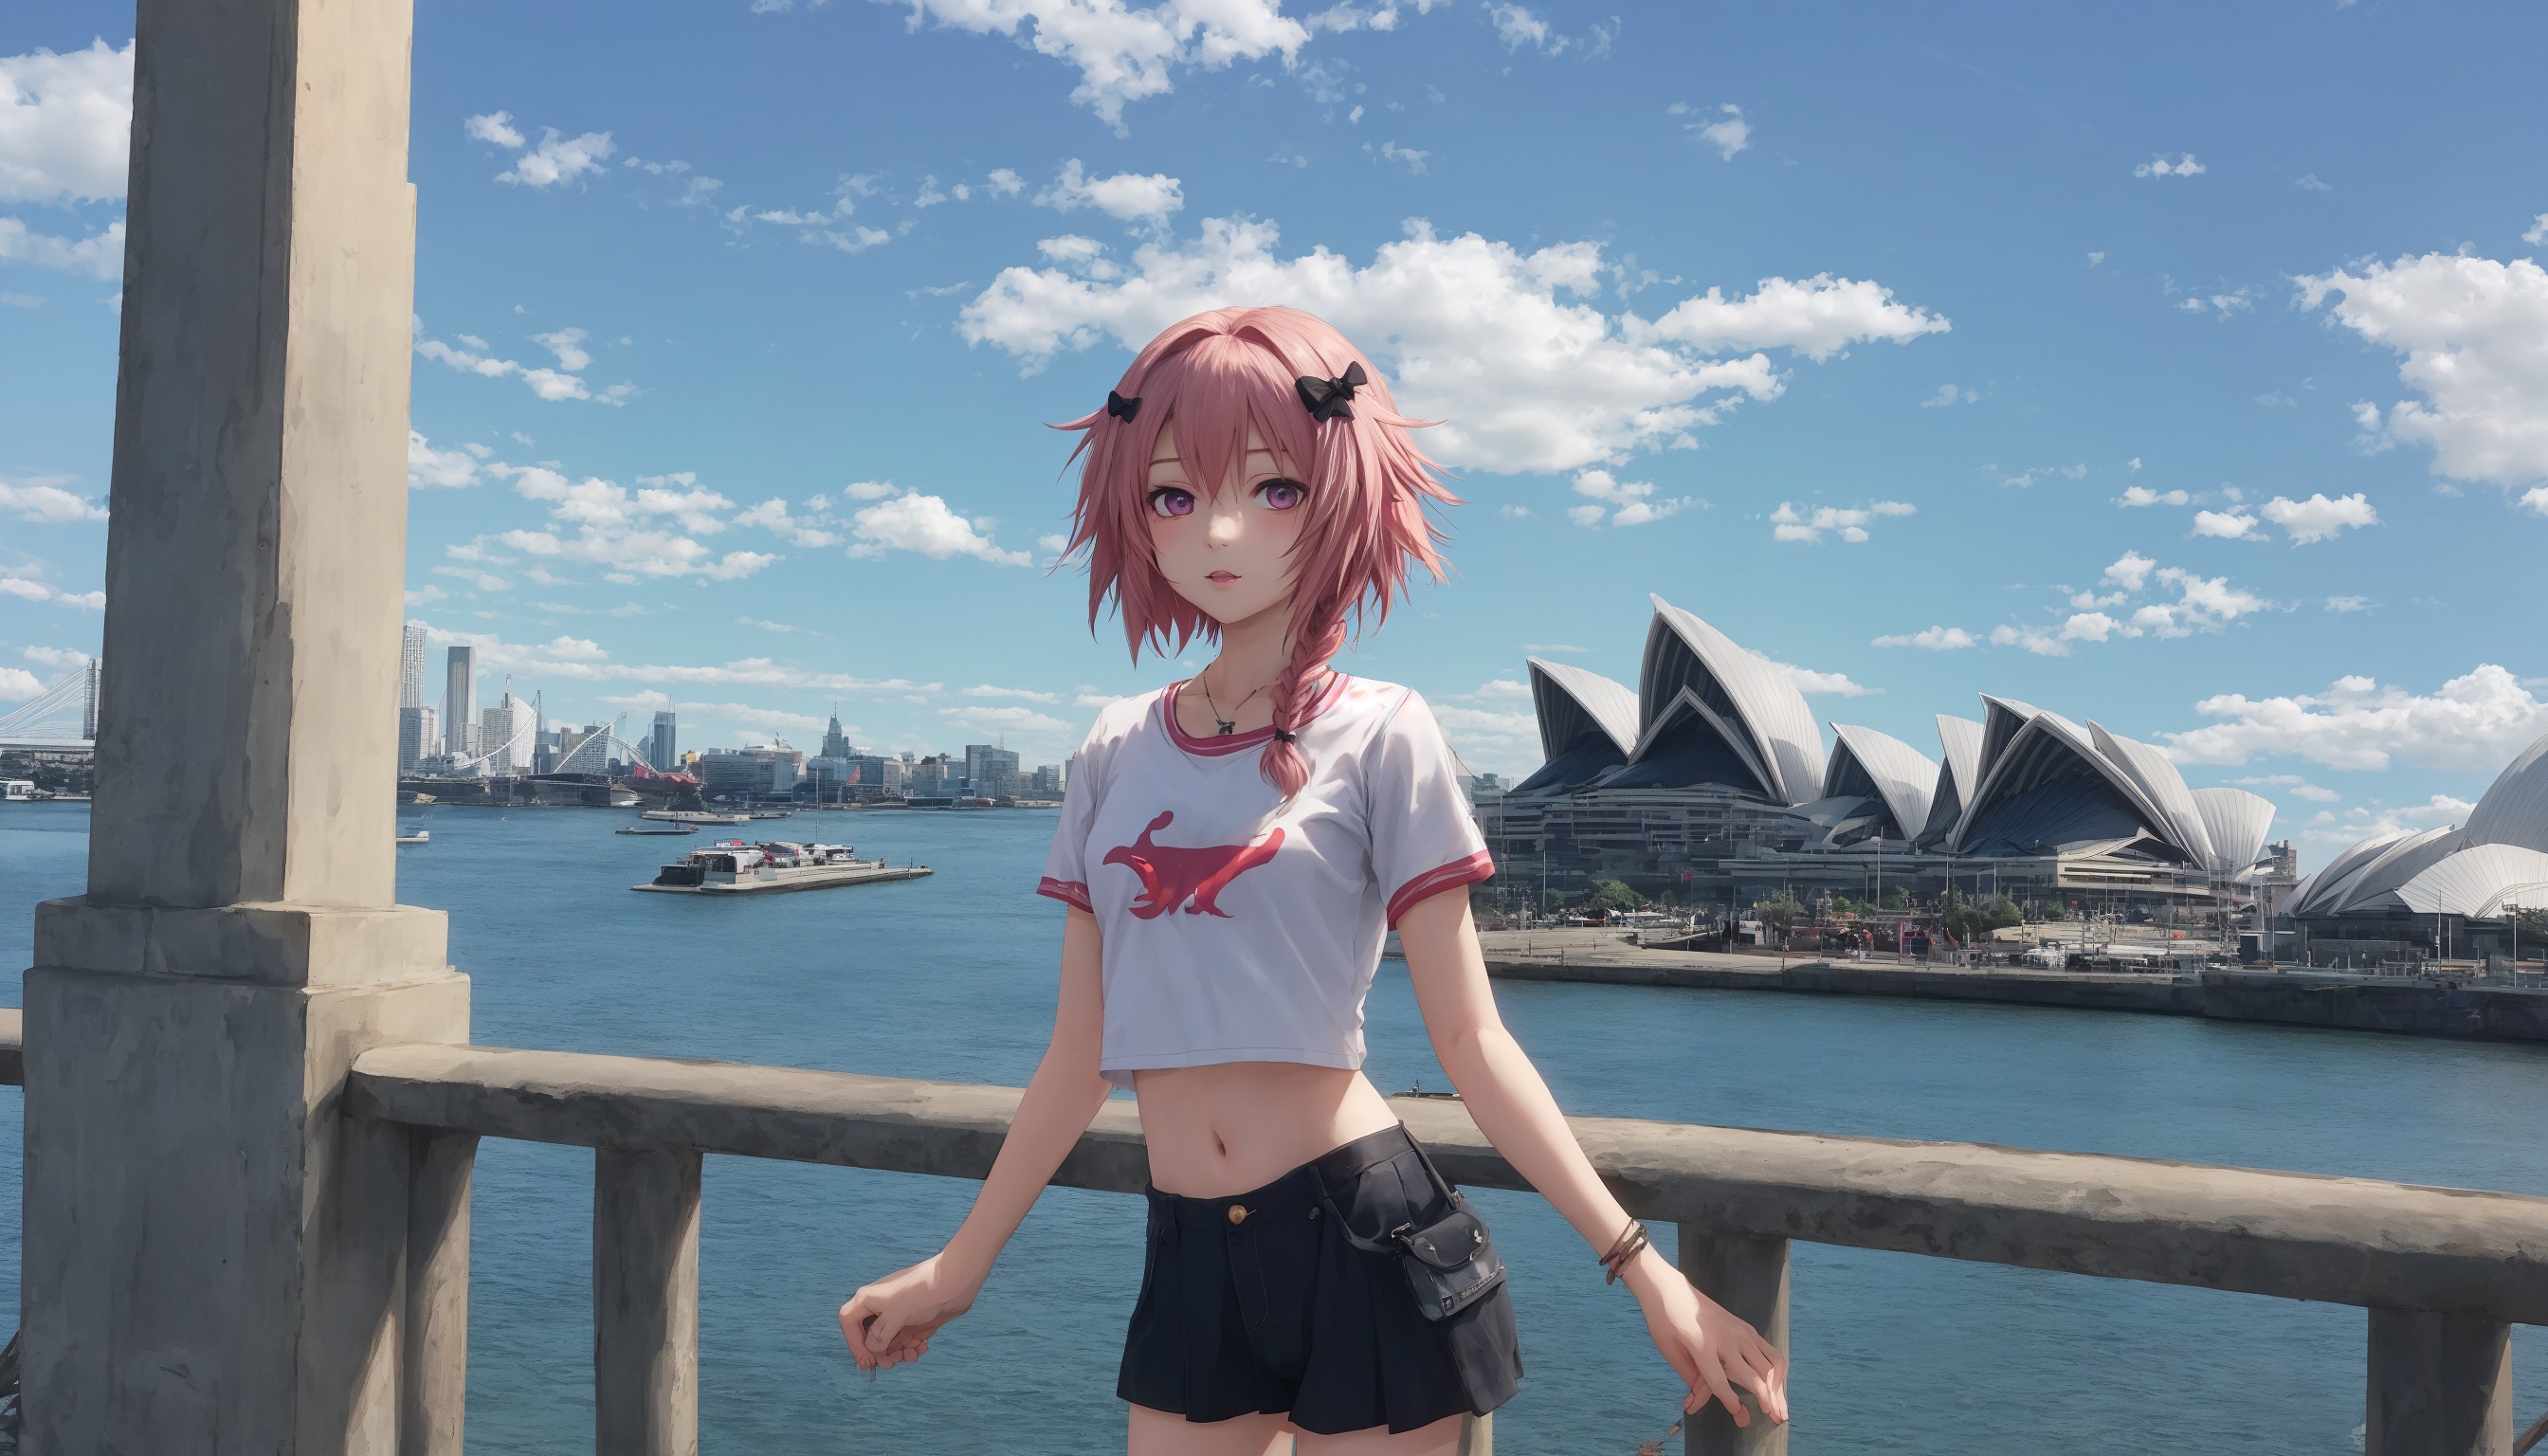
parameters
(aesthetic:0), (quality:0), (1girl:0), (boy:0), [[shirt]], [[midriff]], [[braid]], [astolfo], [[[[sydney opera house]]]]
Negative prompt: (worst:0), (low:0), (bad:0), (exceptional:0), (masterpiece:0), (comic:0), (extra:0), (lowres:0), (breasts:0.5)
Steps: 256, Sampler: Euler, CFG scale: 4, Seed: 341693176, Size: 1344x768, Model hash: 41429fdee1, Model: 20-bpcga9-lracrc2oh-b11i75pvc-gf34ym34-sd, VAE hash: 551eac7037, VAE: vae-ft-mse-840000-ema-pruned.ckpt, Denoising strength: 0.7, Clip skip: 2, FreeU Stages: "[{\"backbone_factor\": 1.2, \"skip_factor\": 0.9}, {\"backbone_factor\": 1.4, \"skip_factor\": 0.2}]", FreeU Schedule: "0.0, 1.0, 0.0", Hires upscale: 2, Hires steps: 64, Hires upscaler: Latent, Dynamic thresholding enabled: True, Mimic scale: 1, Separate Feature Channels: False, Scaling Startpoint: MEAN, Variability Measure: AD, Interpolate Phi: 0.7, Threshold percentile: 100, Version: v1.6.0
- Current version:
20-bpcga9-lracrc2oh-b11i75pvc-gf34ym34-sd.safetensors(merge of 20 models) - Recommended version: "20"
- Recommended CFG:
4.54.0
Baseline
- A (baseline) merge model focusing on absurdres, and let me wait for a big anime SDXL finetune.
- Behind the "absurdres", the model should be very robust and capable for most LoRAs / embeddings / addons you can imagine.
- The image below is 2688x1536 without upscaler. With upscaler, it reaches 8K already.
The image below is 10752x6143, and it is a 3.25MB JPEG. "upscaler 4x". See PNG info below. Removed because some it failed to preview on some browsers.
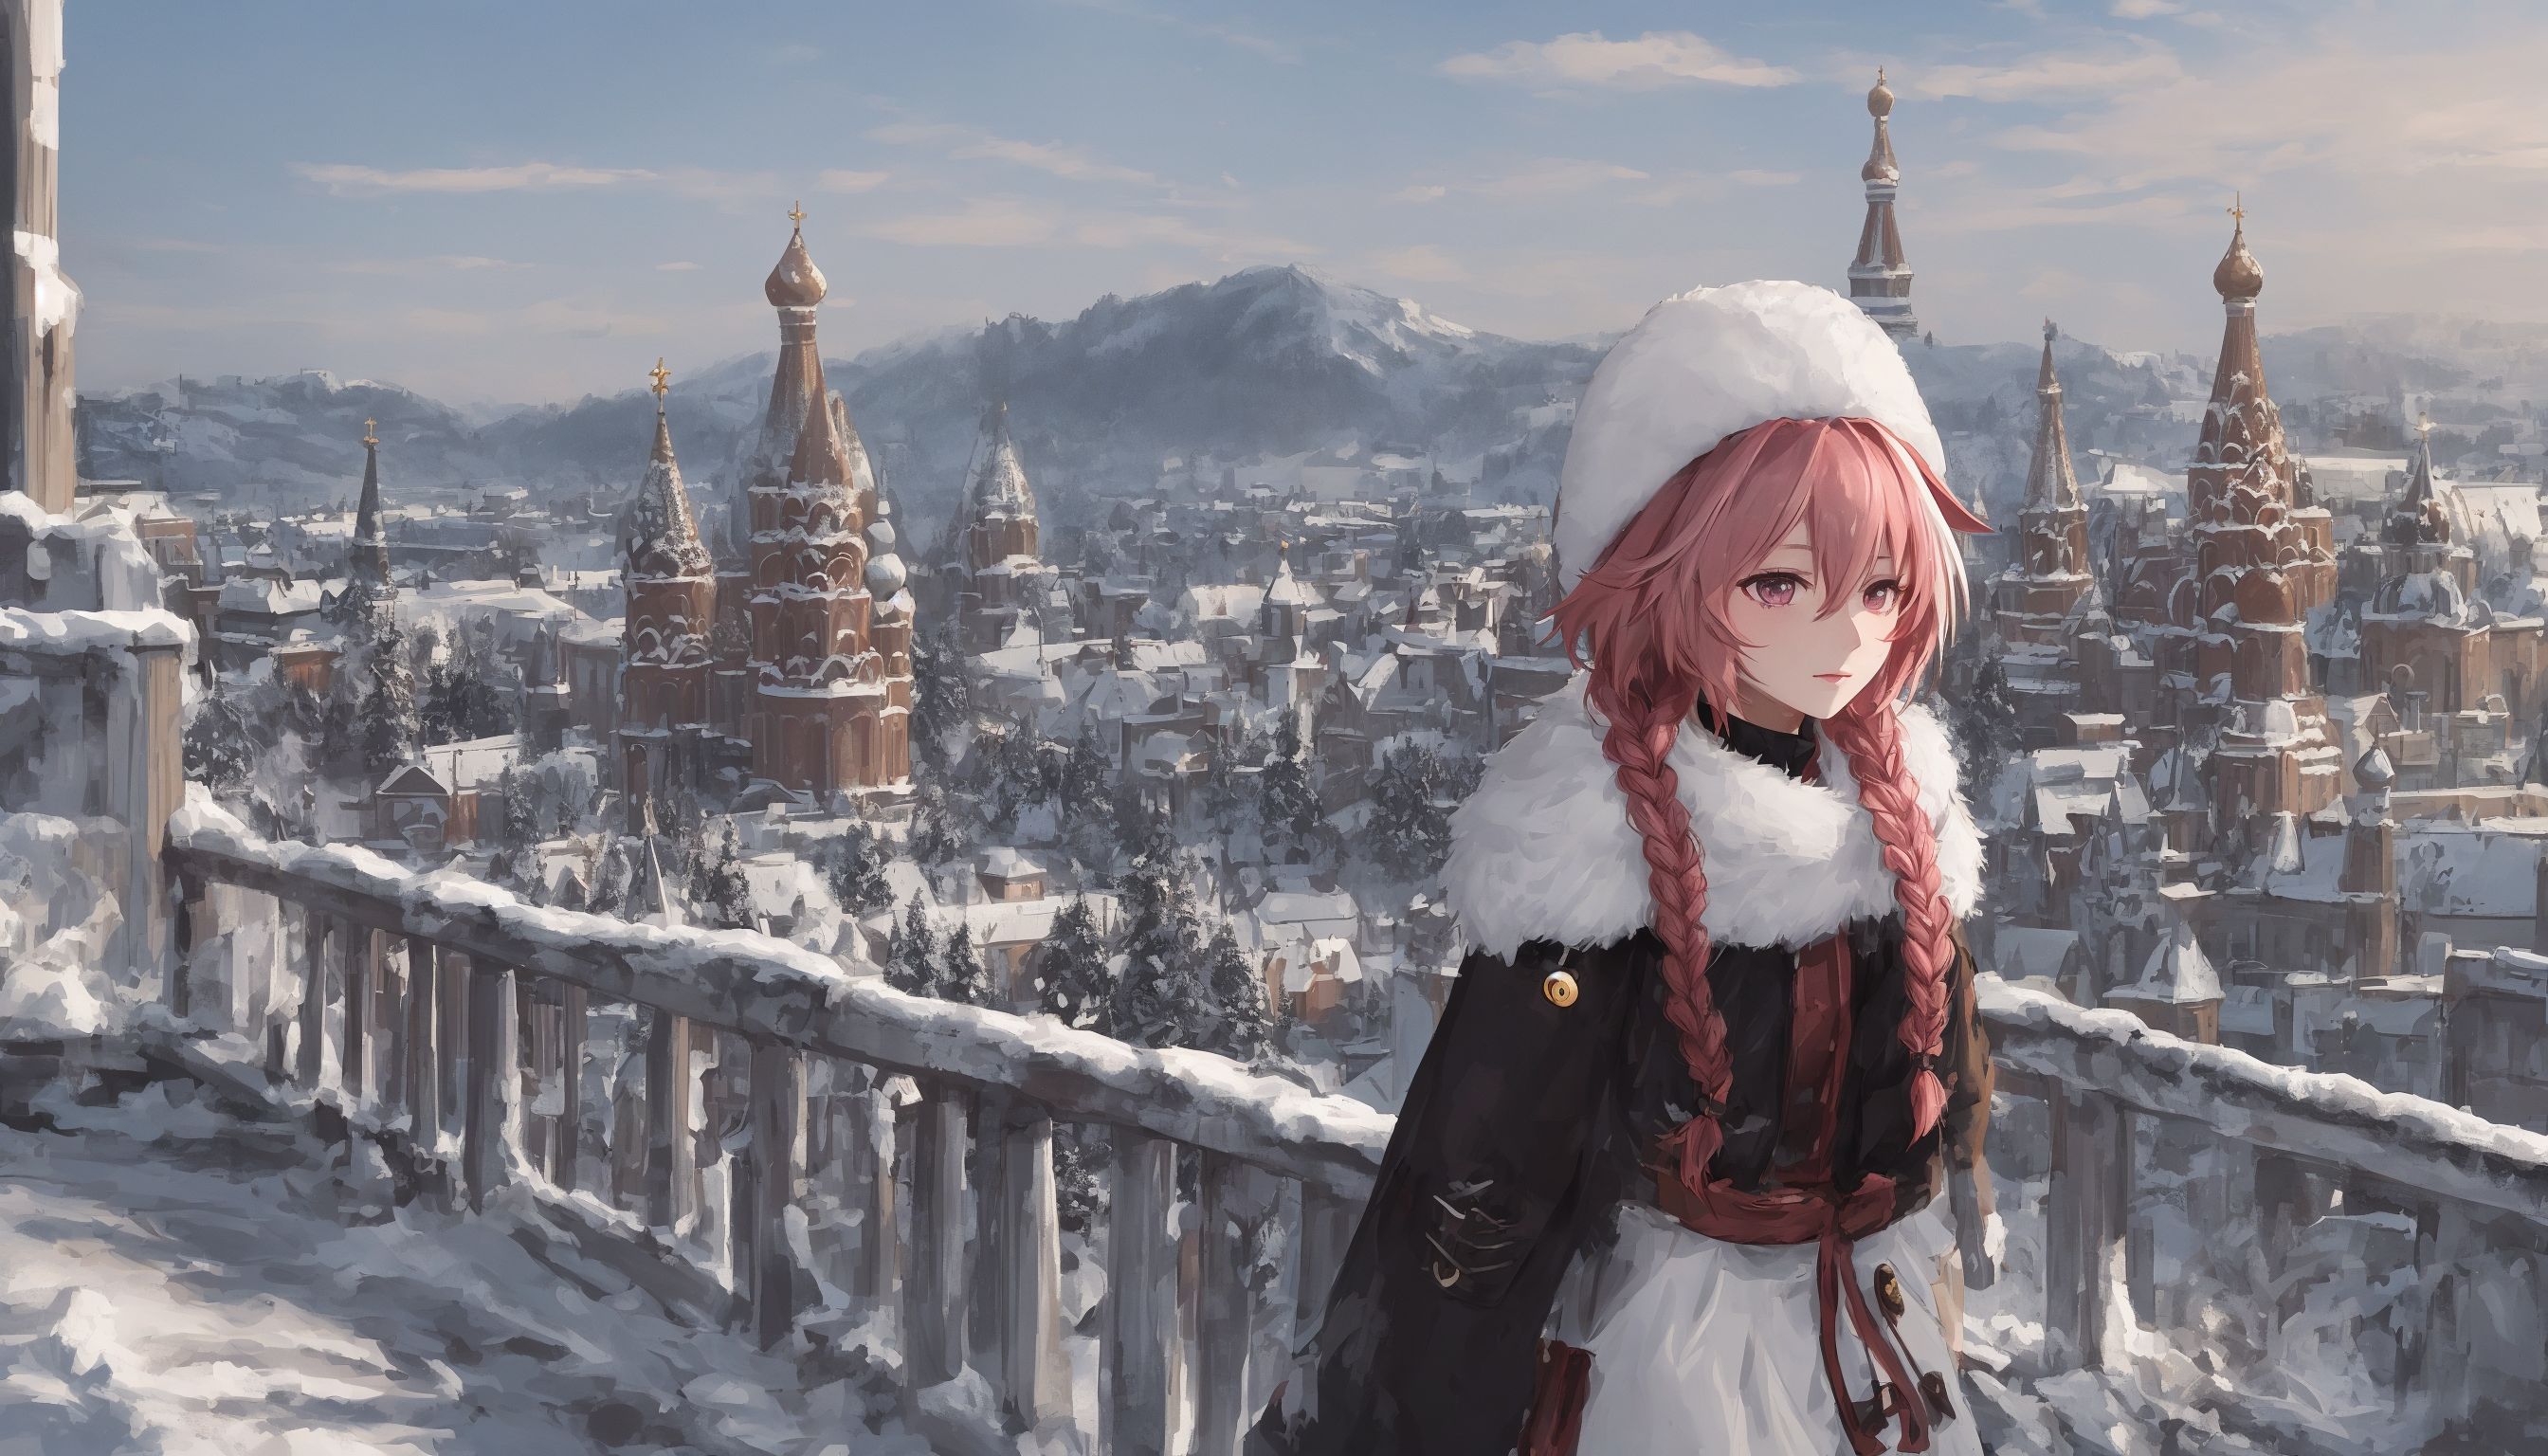
parameters
(aesthetic:0), (quality:0), (solo:0), (boy:0), (ushanka:0.98), [[braid]], [astolfo], [[moscow, russia]]
Negative prompt: (worst:0), (low:0), (bad:0), (exceptional:0), (masterpiece:0), (comic:0), (extra:0), (lowres:0), (breasts:0.5)
Steps: 256, Sampler: Euler, CFG scale: 4.5, Seed: 132385090, Size: 1344x768, Model hash: 6ffdb39acd, Model: 10-vcbpmtd8_cwlbdaw_eb5ms29-sd, VAE hash: 551eac7037, VAE: vae-ft-mse-840000-ema-pruned.ckpt, Denoising strength: 0.7, Clip skip: 2, FreeU Stages: "[{\"backbone_factor\": 1.2, \"skip_factor\": 0.9}, {\"backbone_factor\": 1.4, \"skip_factor\": 0.2}]", FreeU Schedule: "0.0, 1.0, 0.0", Hires upscale: 2, Hires steps: 64, Hires upscaler: Latent, Dynamic thresholding enabled: True, Mimic scale: 1, Separate Feature Channels: False, Scaling Startpoint: MEAN, Variability Measure: AD, Interpolate Phi: 0.7, Threshold percentile: 100, Version: v1.6.0
- Current version:
10-vcbpmtd8_cwlbdaw_eb5ms29-sd.safetensors(merge of 10 models) - Recommended version: "06a" or "10"
- Receipe Models: Merging UNETs into SD V1.4
- "Roadmap" / "Theory" in my Github.
- Recommended prompt: "SD 1.4's Text Encoder"
- Recommended resolution: 1024x1024 (native T2I), HiRes 1.75x (RTX 2080Ti 11GB)
- It can generate images up to 1280x1280 with HiRes 2.0x (Tesla M40 24GB), but the yield will be very low and time consuming to generate a nice image.
- Recommended CFG: 4.5 (also tested on all base models), 6.0 (1280 mode)
Receipe
-
Uniform merge. M = 1 / "number of models in total".
| Index | M | Filename |
|---|---|---|
| 02 | 0.5 | 02-vbp23-cbp2-sd |
| 03 | 0.33 | 03-vcbp-mzpikas_tmnd-sd |
| 04 | 0.25 | 04-vcbp_mzpt_d8-sd |
| 05 | 0.2 | 05-vcbp_mtd8_cwl-sd |
| 06 | 0.167 | 06-vcbp_mtd8cwl_bd-sd |
| 07 | 0.143 | 07-vcbp_mtd8cwl_bdaw-sd |
| 08 | 0.125 | 08-vcbpmt_d8cwlbd_aweb5-sd |
| 09 | 0.111 | 09-majicmixRealistic_v6-sd |
| 10 | 0.1 | 10-vcbpmtd8_cwlbdaw_eb5ms29-sd |
| 11 | 0.0909 | 11-bp-sd |
| 12 | 0.0833 | 12-bpcga9-sd |
| 13 | 0.0769 | 13-bpcga9-lra-sd |
| 14 | 0.0714 | 14-bpcga9-lracrc2-sd |
| 15 | 0.0667 | 15-bpcga9-lracrc2-oh-sd |
| 16 | 0.0625 | 16-bpcga9-lracrc2-ohb11 |
| 17 | 0.0588 | 17-bpcga9-lracrc2-ohb11i75-sd |
| 18 | 0.0555 | 18-bpcga9-lracrc2-ohb11i75-pvc-sd |
| 19 | 0.0526 | 19-bpcga9-lracrc2-ohb11i75-pvcgf34-sd |
| 20 | 0.05 | 20-bpcga9-lracrc2oh-b11i75pvc-gf34ym34-sd |
Extra: Comparing with merges with original Text Encoders
- Uniform merge. M = 1 / "number of models in total".
| Index | M | Filename |
|---|---|---|
| 02 | 0.5 | 02a-vbp23-cbp2 |
| 03 | 0.33 | 03a-vcbp-mzpikas_tmnd |
| 04 | 0.25 | 04a-vcbp_mzpt_d8 |
| 05 | 0.2 | 05a-vcbp_mtd8_cwl |
| 06 | 0.167 | 06a-vcbp_mtd8cwl_bd |
| 07 | 0.143 | 07a-vcbp_mtd8cwl_bdaw |
| 08 | 0.125 | 08a-vcbpmt_d8cwlbd_aweb5 |
| 09 | 0.111 | 09a-majicmixRealistic_v6 |
| 10 | 0.1 | 10a-vcbpmtd8_cwlbdaw_eb5ms29 |
| 11 | 0.0909 | 11a-bp |
| 12 | 0.0833 | 12a-bpcga9 |
| 13 | 0.0769 | 13a-bpcga9-lra |
| 14 | 0.0714 | 14a-bpcga9-lracrc2 |
| 15 | 0.0667 | 15a-bpcga9-lracrc2-oh |
| 16 | 0.0625 | 16a-bpcga9-lracrc2-ohb11 |
| 17 | 0.0588 | 17a-bpcga9-lracrc2-ohb11i75 |
| 18 | 0.0555 | 18a-bpcga9-lracrc2-ohb11i75-pvc |
| 19 | 0.0526 | 19a-bpcga9-lracrc2-ohb11i75-pvcgf34 |
| 20 | 0.05 | 20a-bpcga9-lracrc2oh-b11i75pvc-gf34ym34 |
- Suprisingly, they looks similar, with only minor difference in background and unnamed details (semantic relationships).








License
This model is open access and available to all, with a CreativeML OpenRAIL-M license further specifying rights and usage. The CreativeML OpenRAIL License specifies:
- You can't use the model to deliberately produce nor share illegal or harmful outputs or content
- The authors claims no rights on the outputs you generate, you are free to use them and are accountable for their use which must not go against the provisions set in the license
- You may re-distribute the weights and use the model commercially and/or as a service. If you do, please be aware you have to include the same use restrictions as the ones in the license and share a copy of the CreativeML OpenRAIL-M to all your users (please read the license entirely and carefully) Please read the full license here