AstolfoMix-SD2 (Baseline / Extended / Reinforced / 210b)
-
Based from SD2.1. I know SD2.1 is hopeless, but it is the best environment for a PoC and to improve my idea.
-
See simplified description in CivitAI and full article in Github
-
It won't look great, but at least you won't get Miku Hatsune when prompting Suzumiya Haruhi, or having a black hair boy when prompting Link.
-
Preview here are powered by the top session of
README.mdand converting SDXL model from A1111 standalone file into diffuers via convert_original_stable_diffusion_to_diffusers.py. Settings may not being optimal (no CFG / PAG / FreeU etc). I'll replace the preview diffuser as soon as I upload the main model file.
"210b"
-
Special case of "Add difference". Merge of "Extended" and "Reinforced".
-
12 UNETs with 4 CLIPs.
-
Current version:
210b-AstolfoMix-211209b.safetensors -
Recommended version: "210b"
-
Recommended CFG: 6.0
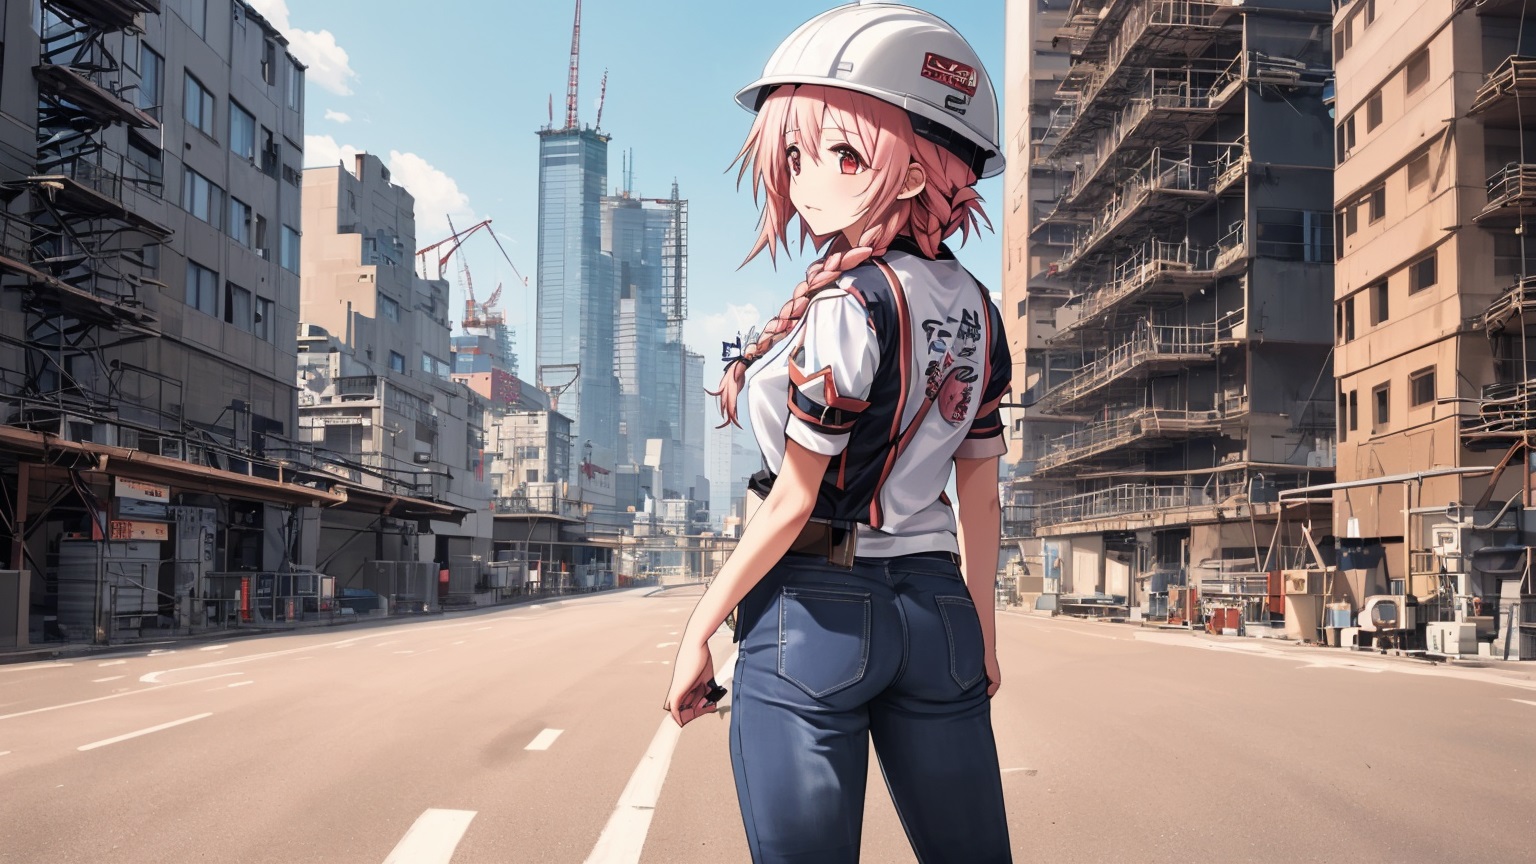
parameters
(aesthetic:0), (quality:0), (solo:0), (anime:0), (boy:0), (construction helmet:0.98), [[jeans]], [[braid]], [astolfo], [[new york]]
Negative prompt: (worst:0), (low:0), (bad:0), (exceptional:0), (masterpiece:0), (comic:0), (extra:0), (lowres:0), (photorealisitc:0)
Steps: 192, Sampler: Euler, CFG scale: 6, Seed: 802596570, Size: 1024x576, Model hash: 13696ee702, Model: 210b-AstolfoMix-211209b, VAE hash: df3c506e51, VAE: vae-ft-mse-840000-ema-pruned.ckpt, Denoising strength: 0.7, Clip skip: 2, FreeU Stages: "[{\"backbone_factor\": 1.1, \"skip_factor\": 0.9}, {\"backbone_factor\": 1.2, \"skip_factor\": 0.2}]", FreeU Schedule: "0.0, 1.0, 0.0", FreeU Version: 2, Hires upscale: 1.5, Hires upscaler: Latent, Dynamic thresholding enabled: True, Mimic scale: 1, Separate Feature Channels: False, Scaling Startpoint: MEAN, Variability Measure: AD, Interpolate Phi: 0.3, Threshold percentile: 100, Version: v1.7.0
Reinforced
-
Using AutoMBW (bayesian merger but less powerful) for 10 models.
-
Current version:
209b-AstolfoMix-207b_208b.safetensors -
Recommended version: "209b"
-
Recommended CFG: 6.0
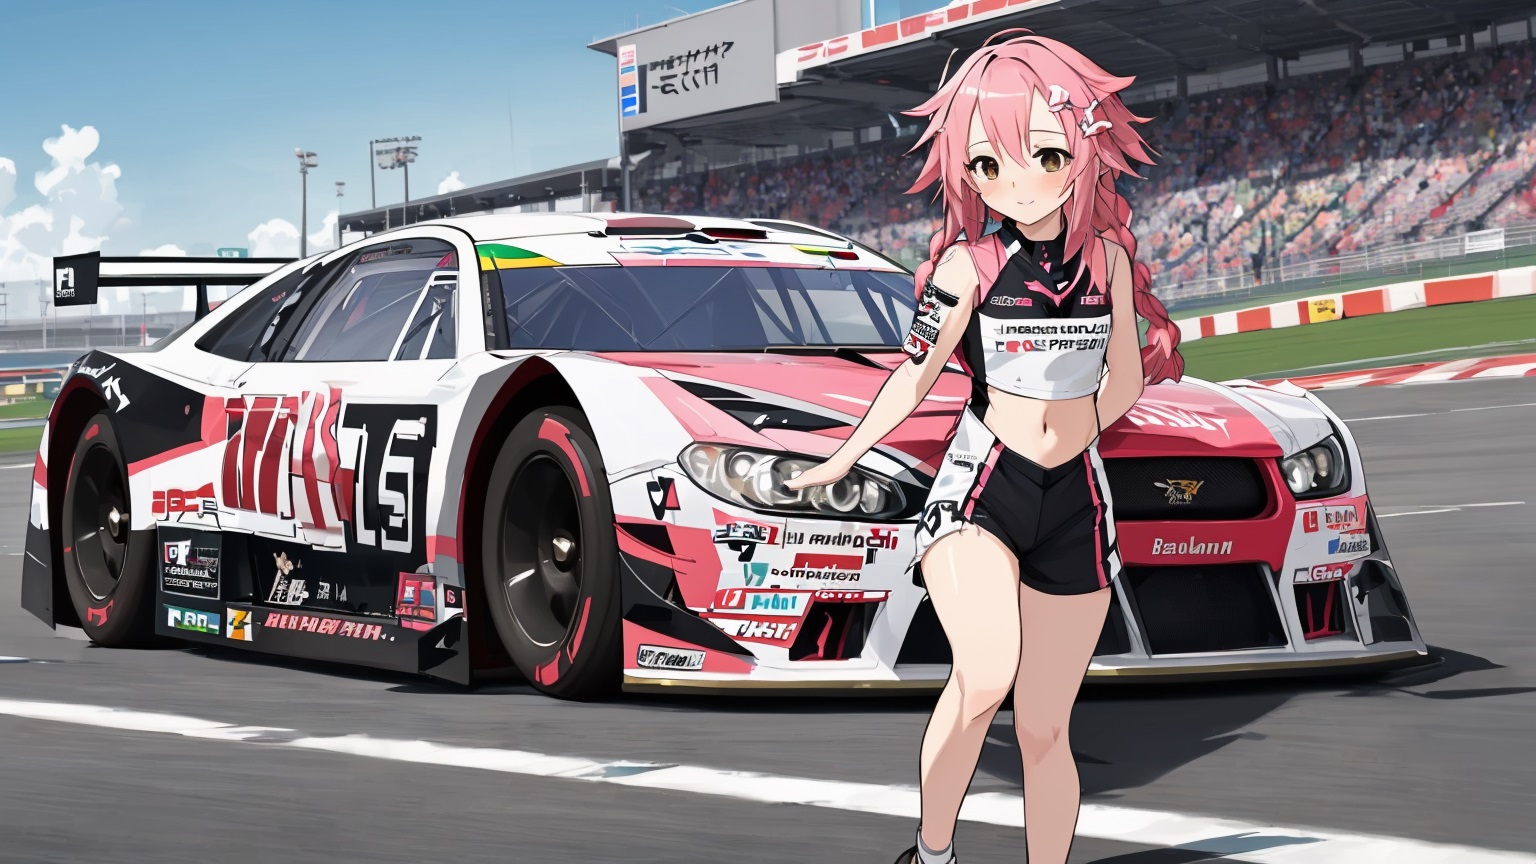
parameters
(aesthetic:0), (quality:0), (anime:0), (race queen:0.98), [[braid]], [[bulge]], [astolfo], [[[[nascar, nurburgring]]]]
Negative prompt: (worst:0), (low:0), (bad:0), (exceptional:0), (masterpiece:0), (comic:0), (extra:0), (lowres:0), (photorealisitc:0), (breasts:0.5)
Steps: 256, Sampler: Euler, CFG scale: 6, Seed: 372021954, Size: 1024x576, Model hash: 510ede6f03, Model: 209b-AstolfoMix-207b_208b, VAE hash: df3c506e51, VAE: vae-ft-mse-840000-ema-pruned.ckpt, Denoising strength: 0.7, Clip skip: 2, FreeU Stages: "[{\"backbone_factor\": 1.1, \"skip_factor\": 0.9}, {\"backbone_factor\": 1.2, \"skip_factor\": 0.2}]", FreeU Schedule: "0.0, 1.0, 0.0", FreeU Version: 2, Hires upscale: 1.5, Hires steps: 64, Hires upscaler: Latent, Dynamic thresholding enabled: True, Mimic scale: 1, Separate Feature Channels: False, Scaling Startpoint: MEAN, Variability Measure: AD, Interpolate Phi: 0.3, Threshold percentile: 100, Version: v1.7.0
Baseline
-
Uniform merge of 10 UNETs and 4 CLIPs.
-
Current version:
209-AstolfoMix-207208-203te.safetensors -
Recommended version: "209-203te"
-
Recommended CFG: 6.0
-
Prompt is slightly changed from SD1 (anime / photorealistic).
-
Intermediate models will be omitted. This time I'm not merged in sequence, therefore it is not meaningful to show the unuseable models.

parameters

(aesthetic:0), (quality:0), (anime:0), (solo:0), (boy:0), [niqab], [[hijab]], [astolfo], [[afghanistan]]
Negative prompt: (worst:0), (low:0), (bad:0), (exceptional:0), (masterpiece:0), (comic:0), (extra:0), (lowres:0), (photorealisitc:0)
Steps: 256, Sampler: Euler, CFG scale: 6, Seed: 802596511, Size: 1024x576, Model hash: a85153fd84, Model: 209-AstolfoMix-207208-203te, VAE hash: df3c506e51, VAE: vae-ft-mse-840000-ema-pruned.ckpt, Denoising strength: 0.7, Clip skip: 2, FreeU Stages: "[{\"backbone_factor\": 1.1, \"skip_factor\": 0.9}, {\"backbone_factor\": 1.2, \"skip_factor\": 0.2}]", FreeU Schedule: "0.0, 1.0, 0.0", FreeU Version: 2, Hires upscale: 1.5, Hires steps: 64, Hires upscaler: Latent, Dynamic thresholding enabled: True, Mimic scale: 1, Separate Feature Channels: False, Scaling Startpoint: MEAN, Variability Measure: AD, Interpolate Phi: 0.3, Threshold percentile: 100, Version: v1.7.0
Major difference of methodology
-
Model selection. NP Hard. Still 12 UNETs, but filtered from 24 models found. Most models are unuseable with its UNET / CLIP / VAE combo.
-
This time the CLIP is a merge of 4 CLIPS instead of the original SD CLIP. I thought the SD2.1's CLIP is bad in performance, but in fact it is still decent, but I found some more useful and merge them together.
-
Builtin VAE will be
kl-f8-anime2.ckpt. But I'm still usingvae-ft-mse-840000-ema-pruned.ckptfor WebUI. Choose what you want. -
Minimal idea will be "Replicant-V3 UNET + WD1.5B3 CLIP". The merge ratio made me find more SD2 models in a sophisticated way.
Receipe
| Index | Model name (with URL) | UNET used? | CLIP used? |
|---|---|---|---|
_201 | AllWorkForkRowk | ||
_202 | Artius V2.1 NSFW | Y | |
_203 | E621 Rising v2 | ||
_204 | hakoMayD | Y | |
_205 | Illuminati Diffusion v1.1 | ||
_206 | Mishi Anime | Y(a) | |
_207 | NijiDiffusion | ||
_208 | Plat Diffusion v1.3.1 | ||
_209 | PVC v4 | ||
_210 | Quattro4Merge+i | Y | |
_211 | Replicant-V3.0 | Y | |
_212 | Pony Diffusion | ||
_213 | Cool Japan Diffusion 2.1.2 | Y | |
_214 | WD 1.5 Beta 2 | ||
_215 | WD 1.5 Beta 3 | Y | |
_216 | YiffAI | ||
_217 | Stable Diffusion v2-1 | Y | |
_218 | RuminationDiffusion | Y | |
_219 | Scream-SemiRealistic | Y | |
_220 | Realgar-v2.1 | Y | Y |
_221 | RheaSilvia | Y | |
_222 | MuaccaMix | Y | |
_223 | hakoMayBoy | Y | |
_224 | Hurricane | Y(a) |