/ Модель

Характеристики

Контекст
512 токенов
Параметры
162 млн
Лицензия
Apache 2.0
Архитектура
bert · dense
Базовая модель
bert-base-arabertv02
Опубликована
22 янв 2025

AraRest-Arabic-Restaurant-Reviews-Sentiment-Analysis

Классификация текстаТекст → label3 профессии

Дообученная AraBERT определяет положительную или отрицательную тональность арабских отзывов о ресторанах.

273скачиваний за 30 дней8лайковвеса обновлены13 фев 2025

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

Abdu-GH/AraRest-Arabic-Restaurant-Reviews-Sentiment-Analysis — дообученная модель AraBERT для классификации арабских отзывов о ресторанах по тональности: положительная или отрицательная. Она основана на aubmindlab/bert-base-arabertv02 и обучена с помощью Hugging Face Transformers на датасете hadyelsahar/ar_res_reviews; архитектура — BERT с классификационной головой, размер — 162,4 млн параметров, максимальный контекст — 512 токенов.

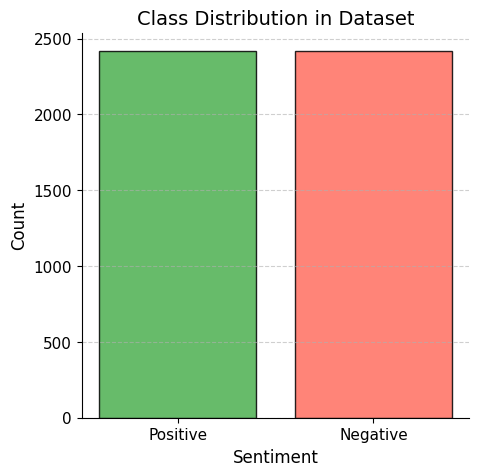
Модель предназначена для анализа отзывов о ресторанах на арабском языке, например для автоматической сортировки отзывов и подсчёта положительных и отрицательных оценок. В README указаны точность 87,40% и сбалансированный обучающий набор из 2418 примеров каждого класса; текст при подготовке очищали от неарабских символов и нормализовали арабские буквы. Модель распространяется по лицензии Apache-2.0.

Сценарии применения

  • Определение тональности арабского отзыва о ресторане
  • Разделение отзывов на положительные и отрицательные
  • Подсчёт доли положительных отзывов о ресторане
  • Автоматическая сортировка отзывов для дальнейшего анализа

Ограничения

Модель различает только положительную и отрицательную тональность; точность 87,40% указана для тестовой выборки из описанного набора данных и не гарантирует такого же качества на других текстах.

Для каких профессий подходит3

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

🍽️ Arabic Restaurant Review Sentiment Analysis 🚀

📌 Overview

This fine-tuned AraBERT model classifies Arabic restaurant reviews as Positive or Negative.
It is based on aubmindlab/bert-base-arabertv2 and fine-tuned using Hugging Face Transformers.

🔥 Why This Model?

✅ Trained on Real Restaurant Reviews from the Hugging Face Dataset.
✅ Fine-tuned with Full Training (not LoRA or Adapters).
✅ Balanced Dataset (2418 Positive vs. 2418 Negative Reviews).
✅ High Accuracy & Performance for Sentiment Analysis in Arabic.


🚀 Try the Model Now!

Run inference directly from the Hugging Face Space:


📥 Dataset & Preprocessing

  • Dataset Source: hadyelsahar/ar_res_reviews
  • Text Cleaning:
    • Removed non-Arabic text, special characters, and extra spaces.
    • Normalized Arabic characters (إ, أ, آ → ا, ة → ه).
    • Balanced Positive & Negative sentiment distribution.
  • Tokenization:
    • Used AraBERT tokenizer (aubmindlab/bert-base-arabertv2).
  • Train-Test Split:
    • 80% Training | 20% Testing.

🏋️ Training & Performance

The model was fine-tuned using Hugging Face Transformers with the following hyperparameters:

📊 Final Model Results

MetricScore
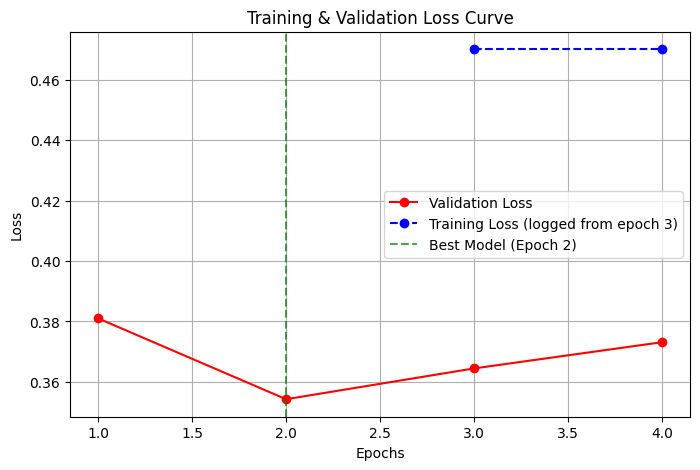
Eval Loss0.354245
Accuracy87.40%
Precision85.28%
Recall86.33%
F1-score85.81%

⚙️ Training Configuration

training_args = TrainingArguments(
    output_dir="./results",
    evaluation_strategy="epoch",
    save_strategy="epoch",
    per_device_train_batch_size=8,
    per_device_eval_batch_size=8,
    num_train_epochs=4,
    weight_decay=1,
    learning_rate=1e-5,
    lr_scheduler_type="cosine",
    warmup_ratio=0.1,
    fp16=True,
    save_total_limit=2,
    gradient_accumulation_steps=2,
    load_best_model_at_end=True,
    max_grad_norm=1.0,
    metric_for_best_model="eval_loss",
    greater_is_better=False,
)

💡 Usage

1️⃣ Quick Inference using pipeline()

from transformers import pipeline

model_name = "Abduuu/ArabReview-Sentiment"
sentiment_pipeline = pipeline("text-classification", model=model_name)

review = "الطعام كان رائعًا والخدمة ممتازة!"
result = sentiment_pipeline(review)
print(result)

✅ Example Output:

[{'label': 'Positive', 'score': 0.91551274061203}]

📉 Training & Validation Loss Curve

The model was trained for 4 epochs, and the best model was selected at Epoch 2 (lowest validation loss).
Loss Curve


📊 Dataset Class Distribution

Class Distribution


For questions or collaborations, feel free to reach out! 🚀


Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм · text-classification

Можно запустить

Подбираем GPU…

Класс архитектуры
BertForSequenceClassification
Ревизия весов
2e78e4b

0 моделей