/ Модель

Характеристики

Контекст
512 токенов
Параметры
137 млн
Архитектура
albert · dense
Опубликована
2 сен 2022

math_albert

ЭмбеддингиТекст → embedding3 профессии

Англоязычная модель ALBERT, дополнительно предобученная на Math StackExchange для извлечения признаков из математического текста и последующего дообучения.

120скачиваний за 30 дней3лайкавеса обновлены26 июл 2023

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Тесты пользователейпока нет

Никто ещё не опубликовал тест этой модели. Соберите бенчмарк из своих задач — результат появится здесь.

  1. Добавьте модель в бенчмарк

    Вместе с другими моделями категории «Эмбеддинги» — сравнение идёт внутри одной категории.

  2. Опишите свои задачи

    Напишите запросы, при необходимости приложите файлы и эталонные ответы.

  3. Запустите и опубликуйте

    Модели ответят на каждую задачу, судья оценит ответы. Опубликованный результат появится на этой странице.

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

AnReu/math_albert — базовая модель семейства ALBERT, подготовленная для работы с математическими текстами. Она инициализирована из ALBERT-base-v2 и дополнительно предобучена в три этапа на Math StackExchange; токенизатор расширен токенами LaTeX для представления математических формул. Модель содержит 136,7 млн параметров, использует архитектуру AlbertModel и принимает последовательности длиной до 512 токенов.

Модель предназначена для извлечения признаков из математического текста и как основа для дообучения под классификацию, ответы на вопросы и другие задачи в математической области. Это англоязычный чекпойнт, который не был дообучен под конкретную задачу; для ARQMath 3 авторы указывают отдельную версию AnReu/albert-for-arqmath-3. Файлы доступны в форматах PyTorch и safetensors. Условия лицензии в предоставленных источниках не приведены.

Сценарии применения

  • извлечение признаков из математических вопросов и ответов
  • дообучение классификатора математических текстов
  • подготовка основы для системы ответов на математические вопросы
  • обработка текстов с формулами LaTeX

Ограничения

Модель только предварительно обучена и не настроена для конкретной прикладной задачи, поэтому для целевого сценария может потребоваться дообучение. Максимальная длина входа — 512 токенов.

Для каких профессий подходит3

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

Math-aware ALBERT

This repository contains our best base model for ARQMath 3. It was initialised from ALBERT-base-v2 and further pre-trained on Math StackExchange in three different stages. We also added more LaTeX tokens to the tokenizer to enable a better tokenization of mathematical formulas. This model is not yet fine-tuned on a specific task. If you are looking for the fine-tuned model, please refer to this page: AnReu/albert-for-arqmath-3

If you are looking for a Math-pre-trained BERT model: Check out our AnReu/math_pretrained_bert which is trained in the same way as this model here.

Training Details

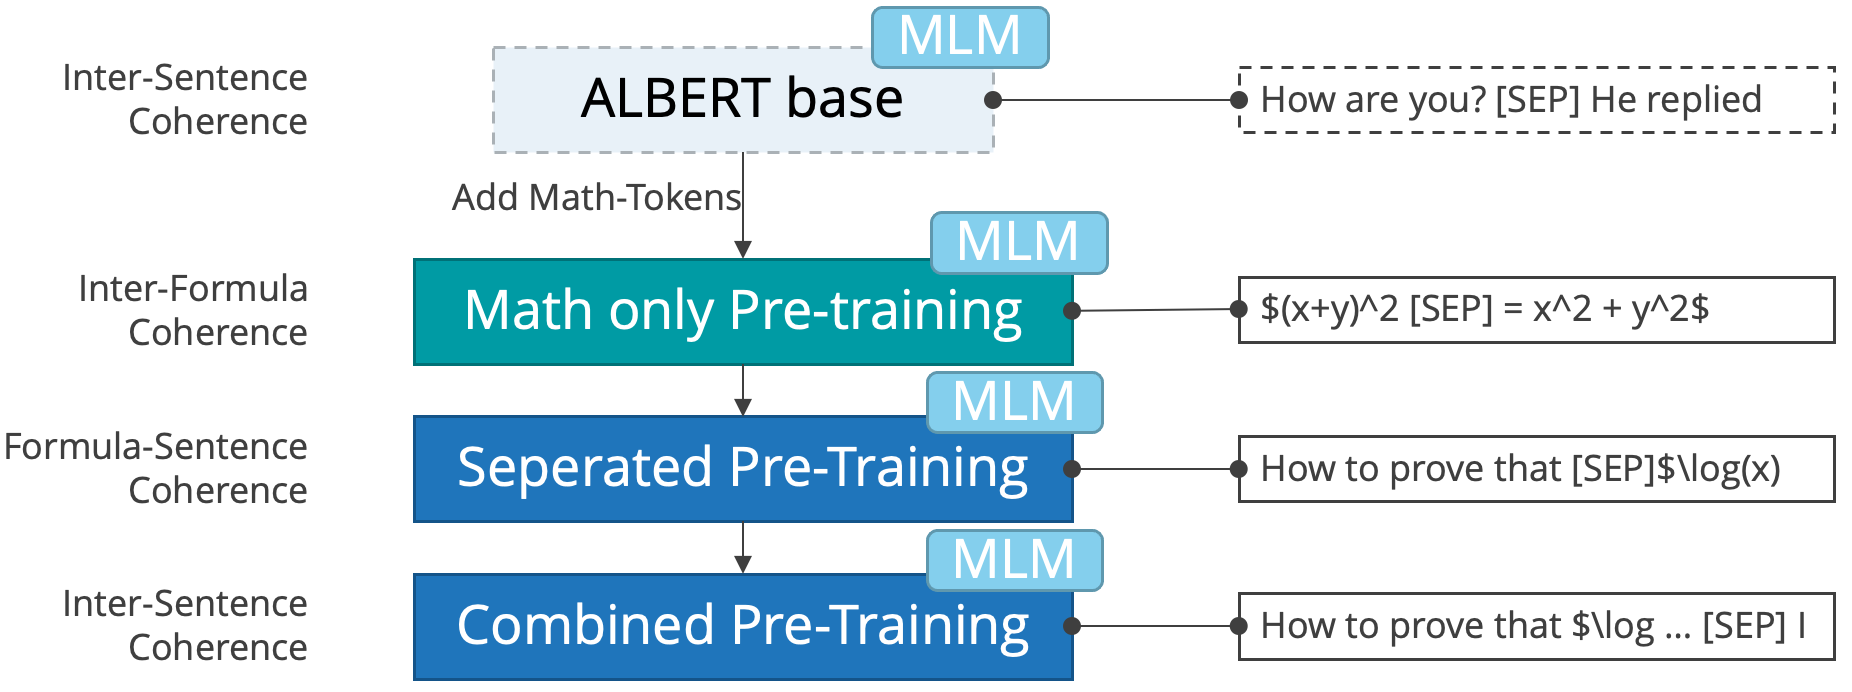
The model was instantiated from ALBERT-base-v2 weights and further pre-trained in three stages using different data for the sentence order prediction. During all three stages, the mask language modelling task was trained simultaneously. In addition, we added around 500 LaTeX tokens to the tokenizer to better cope with mathematical formulas.

The image illustrates the three pre-training stages: First, we train on mathematical formulas only. The SOP classifier predicts which segment contains the left hand side of the formula and which one contains the right hand side. This way we model inter-formula-coherence. The second stages models formula-sentence-coherence, i.e., whether the formula comes first in the original document or whether the natural language part comes first. Finally, we add the inter-sentence-coherence stage that is default for ALBERT. In this stage, sentences were split by a sentence separator.
Image

For further details, please read our paper: http://ceur-ws.org/Vol-3180/paper-07.pdf.

Usage

You can use this model to further fine-tune it on any math-aware task you have in mind, e.g., classification, question-answering, etc. . Please note, that the model in this repository is only pre-trained and not fine-tuned. If you are looking for the fine-tuned model, please refer to this page: AnReu/albert-for-arqmath-3

Citation

If you find this model useful, consider citing our paper:

@article{reusch2022transformer,
  title={Transformer-Encoder and Decoder Models for Questions on Math},
  author={Reusch, Anja and Thiele, Maik and Lehner, Wolfgang},
  year={2022},
  organization={CLEF}
}

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм

Можно запустить

Подбираем GPU…

Класс архитектуры
AlbertModel
Ревизия весов
61ca352

0 моделей