Model Card for Llama-3.1-8B-bonito-v1
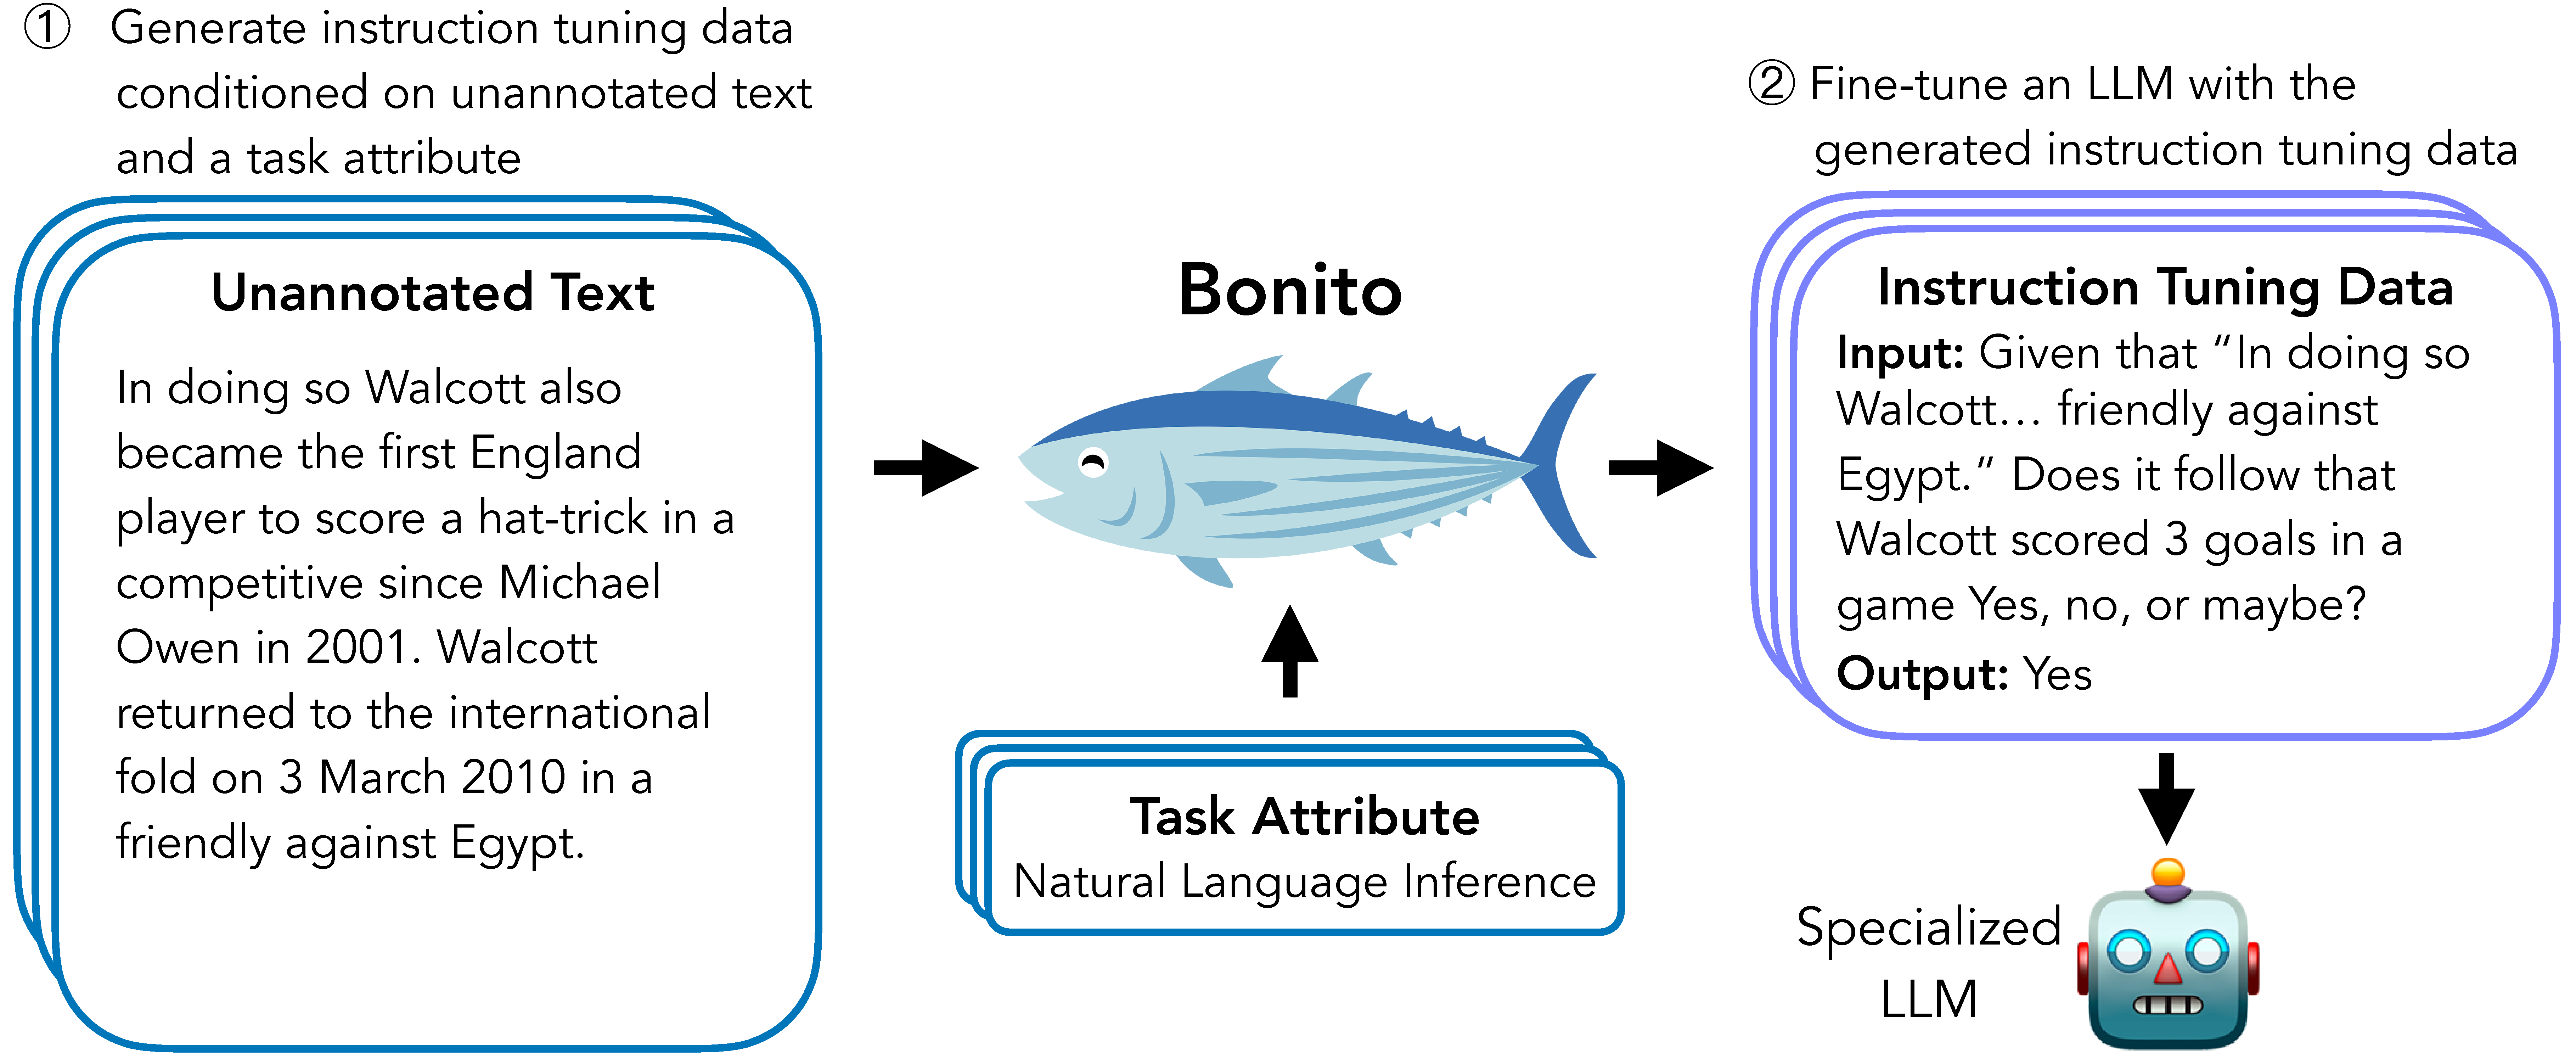
Bonito is an open-source model for conditional task generation: the task of converting unannotated text into task-specific training datasets for instruction tuning.
Model Details
Model Description
Bonito can be used to create synthetic instruction tuning datasets to adapt large language models on users' specialized, private data. In our paper, we show that Bonito can be used to adapt both pretrained and instruction tuned models to tasks without any annotations.
- Developed by: Nihal V. Nayak, Yiyang Nan, Avi Trost, and Stephen H. Bach
- Model type: LlamaForCausalLM
- Language(s) (NLP): English
- License: Llama 3.1 Community License
- Finetuned from model:
meta-llama/Meta-Llama-3.1-8B
Model Sources
- Repository: https://github.com/BatsResearch/bonito
- Paper: Learning to Generate Instruction Tuning Datasets for Zero-Shot Task Adaptation
Model Performance
Downstream performance of Mistral-7B-v0.1 after training with Llama-3.1-8B-bonito-v1 generated instructions.
| Model | PubMedQA | PrivacyQA | NYT | Amazon | ContractNLI | Vitamin C | Average | |
|---|---|---|---|---|---|---|---|---|
| Mistral-7B-v0.1 | 25.6 | 44.1 | 24.2 | 17.5 | 12.0 | 31.2 | 38.9 | 27.6 |
| Mistral-7B-v0.1 + Llama-3.1-8B-bonito-v1 | 44.5 | 53.7 | 80.7 | 72.9 | 70.1 | 69.7 | 73.3 | 66.4 |
Uses
Direct Use
To easily generate synthetic instruction tuning datasets, we recommend using the bonito package built using the transformers and the vllm libraries.
from bonito import Bonito
from vllm import SamplingParams
from datasets import load_dataset

# Initialize the Bonito model
bonito = Bonito("BatsResearch/Llama-3.1-8B-bonito-v1")

# load dataaset with unannotated text
unannotated_text = load_dataset(
    "BatsResearch/bonito-experiment",
    "unannotated_contract_nli"
)["train"].select(range(10))

# Generate synthetic instruction tuning dataset
sampling_params = SamplingParams(max_tokens=256, top_p=0.95, temperature=0.5, n=1)
synthetic_dataset = bonito.generate_tasks(
    unannotated_text,
    context_col="input",
    task_type="nli",
    sampling_params=sampling_params
)
Out-of-Scope Use
Our model is trained to generate the following task types: summarization, sentiment analysis, multiple-choice question answering, extractive question answering, topic classification, natural language inference, question generation, text generation, question answering without choices, paraphrase identification, sentence completion, yes-no question answering, word sense disambiguation, paraphrase generation, textual entailment, and coreference resolution. The model might not produce accurate synthetic tasks beyond these task types.
Bias, Risks, and Limitations
Limitations
Our work relies on the availability of large amounts of unannotated text. If only a small quantity of unannotated text is present, the target language model, after adaptation, may experience a drop in performance. While we demonstrate positive improvements on pretrained and instruction-tuned models, our observations are limited to the three task types (yes-no question answering, extractive question answering, and natural language inference) considered in our paper.
Risks
Bonito poses risks similar to those of any large language model. For example, our model could be used to generate factually incorrect datasets in specialized domains. Our model can exhibit the biases and stereotypes of the base model, Mistral-7B, even after extensive supervised fine-tuning. Finally, our model does not include safety training and can potentially generate harmful content.
Recommendations
We recommend users thoroughly inspect the generated tasks and benchmark performance on critical datasets before deploying the models trained with the synthetic tasks into the real world.
Training Details
Training Data
To train Bonito, we create a new dataset called conditional task generation with attributes by remixing existing instruction tuning datasets. See ctga-v1 for more details.
Training Procedure
Training Hyperparameters
- Training regime: We train the model using Q-LoRA by optimizing the cross entropy loss over the output tokens. The model is trained for 100,000 steps. The training takes about 1 day on eight A100 GPUs to complete.
We use the following hyperparameters:
- Q-LoRA rank (r): 64
- Q-LoRA scaling factor (alpha): 4
- Q-LoRA dropout: 0
- Optimizer: Paged AdamW
- Learning rate scheduler: linear
- Max. learning rate: 1e-04
- Min. learning rate: 0
- Weight decay: 0
- Dropout: 0
- Max. gradient norm: 0.3
- Effective batch size: 16
- Max. input length: 2,048
- Max. output length: 2,048
- Num. steps: 100,000
Citation
@inproceedings{bonito:aclfindings24,
  title = {Learning to Generate Instruction Tuning Datasets for Zero-Shot Task Adaptation},
  author = {Nayak, Nihal V. and Nan, Yiyang and Trost, Avi and Bach, Stephen H.},
  booktitle = {Findings of the Association for Computational Linguistics: ACL 2024},
  year = {2024}}