/ Модель

Характеристики

Контекст
1 024 токена
Параметры
153 млн
Лицензия
Apache 2.0
Архитектура
whisper · dense
Опубликована
15 дек 2022

whisper-small-uz

Распознавание речиАудио → текст7 профессий

Дообученная на узбекской речи модель Whisper для преобразования аудиозаписей в текст.

32скачиваний за 30 дней2лайкавеса обновлены19 дек 2022

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Тесты пользователейпока нет

Никто ещё не опубликовал тест этой модели. Соберите бенчмарк из своих задач — результат появится здесь.

  1. Добавьте модель в бенчмарк

    Вместе с другими моделями категории «Распознавание речи» — сравнение идёт внутри одной категории.

  2. Опишите свои задачи

    Напишите запросы, при необходимости приложите файлы и эталонные ответы.

  3. Запустите и опубликуйте

    Модели ответят на каждую задачу, судья оценит ответы. Опубликованный результат появится на этой странице.

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

BlueRaccoon/whisper-small-uz — модель автоматического распознавания речи, созданная участником мероприятия Whisper fine-tune sprint. Это дообученная версия openai/whisper-small с архитектурой Whisper и 153,1 млн параметров; она принимает аудио и преобразует речь в текст на узбекском языке. Обучение и оценка проводились на узбекских данных Mozilla Common Voice 11 и Google FLEURS.

В оценке указана частота ошибок слов (WER) 23,65 на тестовом наборе Common Voice 11 и 47,15 на FLEURS. Эти результаты относятся к указанным наборам и не гарантируют такое же качество на других записях. Модель распространяется по лицензии Apache-2.0.

Сценарии применения

  • расшифровка речи на узбекском языке
  • создание субтитров для узбекских аудио- и видеозаписей
  • транскрибирование узбекских записей для последующего поиска
  • подготовка текстовых расшифровок узбекской речи из голосовых сообщений

Ограничения

WER заметно различается между тестовыми наборами: 23,65 на Common Voice 11 и 47,15 на FLEURS. Карточка не описывает другие ограничения или условия записи, поэтому качество на иных аудио не установлено.

Для каких профессий подходит7

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Также подходит для

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

Whisper Small Uzbek

This model is a fine-tuned version of openai/whisper-small trained and evaluated on the mozilla-foundation/common_voice_11_0 uz and google/fleurs uz_uz datasets.

It achieves the following results on the common_voice_11_0 evaluation set:

  • Loss: 0.3872
  • Wer: 23.6509

It achieves the following results on the FLEURS evaluation set:

  • Wer: 47.15

Model description

This model was created as part of the Whisper fine-tune sprint event.

Based on eval, this model achieves a WER of 23.6509 against the Common Voice 11 dataset and 47.15 against the FLEURS dataset.

This is a significant improvement over the smallest reported WER of 90.2 for the Uzbek language recorded on the Whisper article:
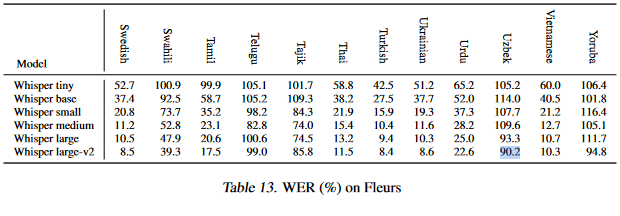
A part of Table 13 from the paper "Robust Speech Recognition via Large-Scale Weak Supervision", which shows the WER achieved by the Whisper model under the FLEURS dataset. Highlighted is the best score it achieved under for the Uzbek language, which was 90.2.

Intended uses & limitations

More information needed

Training and evaluation data

Training was performed using the train and evaluation splits from Mozilla's Common Voice 11 and Google's FLEURS datasets.

Testing was performed using the test splits from the same datasets.

Training procedure

Training and CV11 testing was performed using a modified version of Hugging Face's run_speech_recognition_seq2seq_streaming.py script by Michael Kamfonas.

FLEURS testing was performed using the standard run_eval_whisper_streaming.py script.

Training hyperparameters

The following hyperparameters were used during training:

  • learning_rate: 1e-05
  • train_batch_size: 64
  • eval_batch_size: 32
  • seed: 42
  • optimizer: Adam with betas=(0.9,0.999) and epsilon=1e-08
  • lr_scheduler_type: linear
  • lr_scheduler_warmup_steps: 400
  • training_steps: 5000
  • mixed_precision_training: Native AMP

Training results

Training LossEpochStepValidation LossWer
0.15420.210000.471130.8413
0.09760.420000.404026.6464
0.10881.030000.376524.4952
0.05271.2140000.387223.6509
0.05341.4150000.384323.6817

Framework versions

  • Transformers 4.26.0.dev0
  • Pytorch 1.13.0+cu117
  • Datasets 2.7.1.dev0
  • Tokenizers 0.13.2

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм

Можно запустить

Подбираем GPU…

Класс архитектуры
WhisperForConditionalGeneration
Ревизия весов
64ef1f7

0 моделей