AnimateDiff-Lightning
AnimateDiff-Lightning is a lightning-fast text-to-video generation model. It can generate videos more than ten times faster than the original AnimateDiff. For more information, please refer to our research paper: AnimateDiff-Lightning: Cross-Model Diffusion Distillation. We release the model as part of the research.
Our models are distilled from AnimateDiff SD1.5 v2. This repository contains checkpoints for 1-step, 2-step, 4-step, and 8-step distilled models. The generation quality of our 2-step, 4-step, and 8-step model is great. Our 1-step model is only provided for research purposes.
Demo
Try AnimateDiff-Lightning using our text-to-video generation demo.
Recommendation
AnimateDiff-Lightning produces the best results when used with stylized base models. We recommend using the following base models:
Realistic
Anime & Cartoon
Additionally, feel free to explore different settings. We find using 3 inference steps on the 2-step model produces great results. We find certain base models produces better results with CFG. We also recommend using Motion LoRAs as they produce stronger motion. We use Motion LoRAs with strength 0.7~0.8 to avoid watermark.
Diffusers Usage
import torch
from diffusers import AnimateDiffPipeline, MotionAdapter, EulerDiscreteScheduler
from diffusers.utils import export_to_gif
from huggingface_hub import hf_hub_download
from safetensors.torch import load_file

device = "cuda"
dtype = torch.float16

step = 4  # Options: [1,2,4,8]
repo = "ByteDance/AnimateDiff-Lightning"
ckpt = f"animatediff_lightning_{step}step_diffusers.safetensors"
base = "emilianJR/epiCRealism"  # Choose to your favorite base model.

adapter = MotionAdapter().to(device, dtype)
adapter.load_state_dict(load_file(hf_hub_download(repo ,ckpt), device=device))
pipe = AnimateDiffPipeline.from_pretrained(base, motion_adapter=adapter, torch_dtype=dtype).to(device)
pipe.scheduler = EulerDiscreteScheduler.from_config(pipe.scheduler.config, timestep_spacing="trailing", beta_schedule="linear")

output = pipe(prompt="A girl smiling", guidance_scale=1.0, num_inference_steps=step)
export_to_gif(output.frames[0], "animation.gif")
ComfyUI Usage
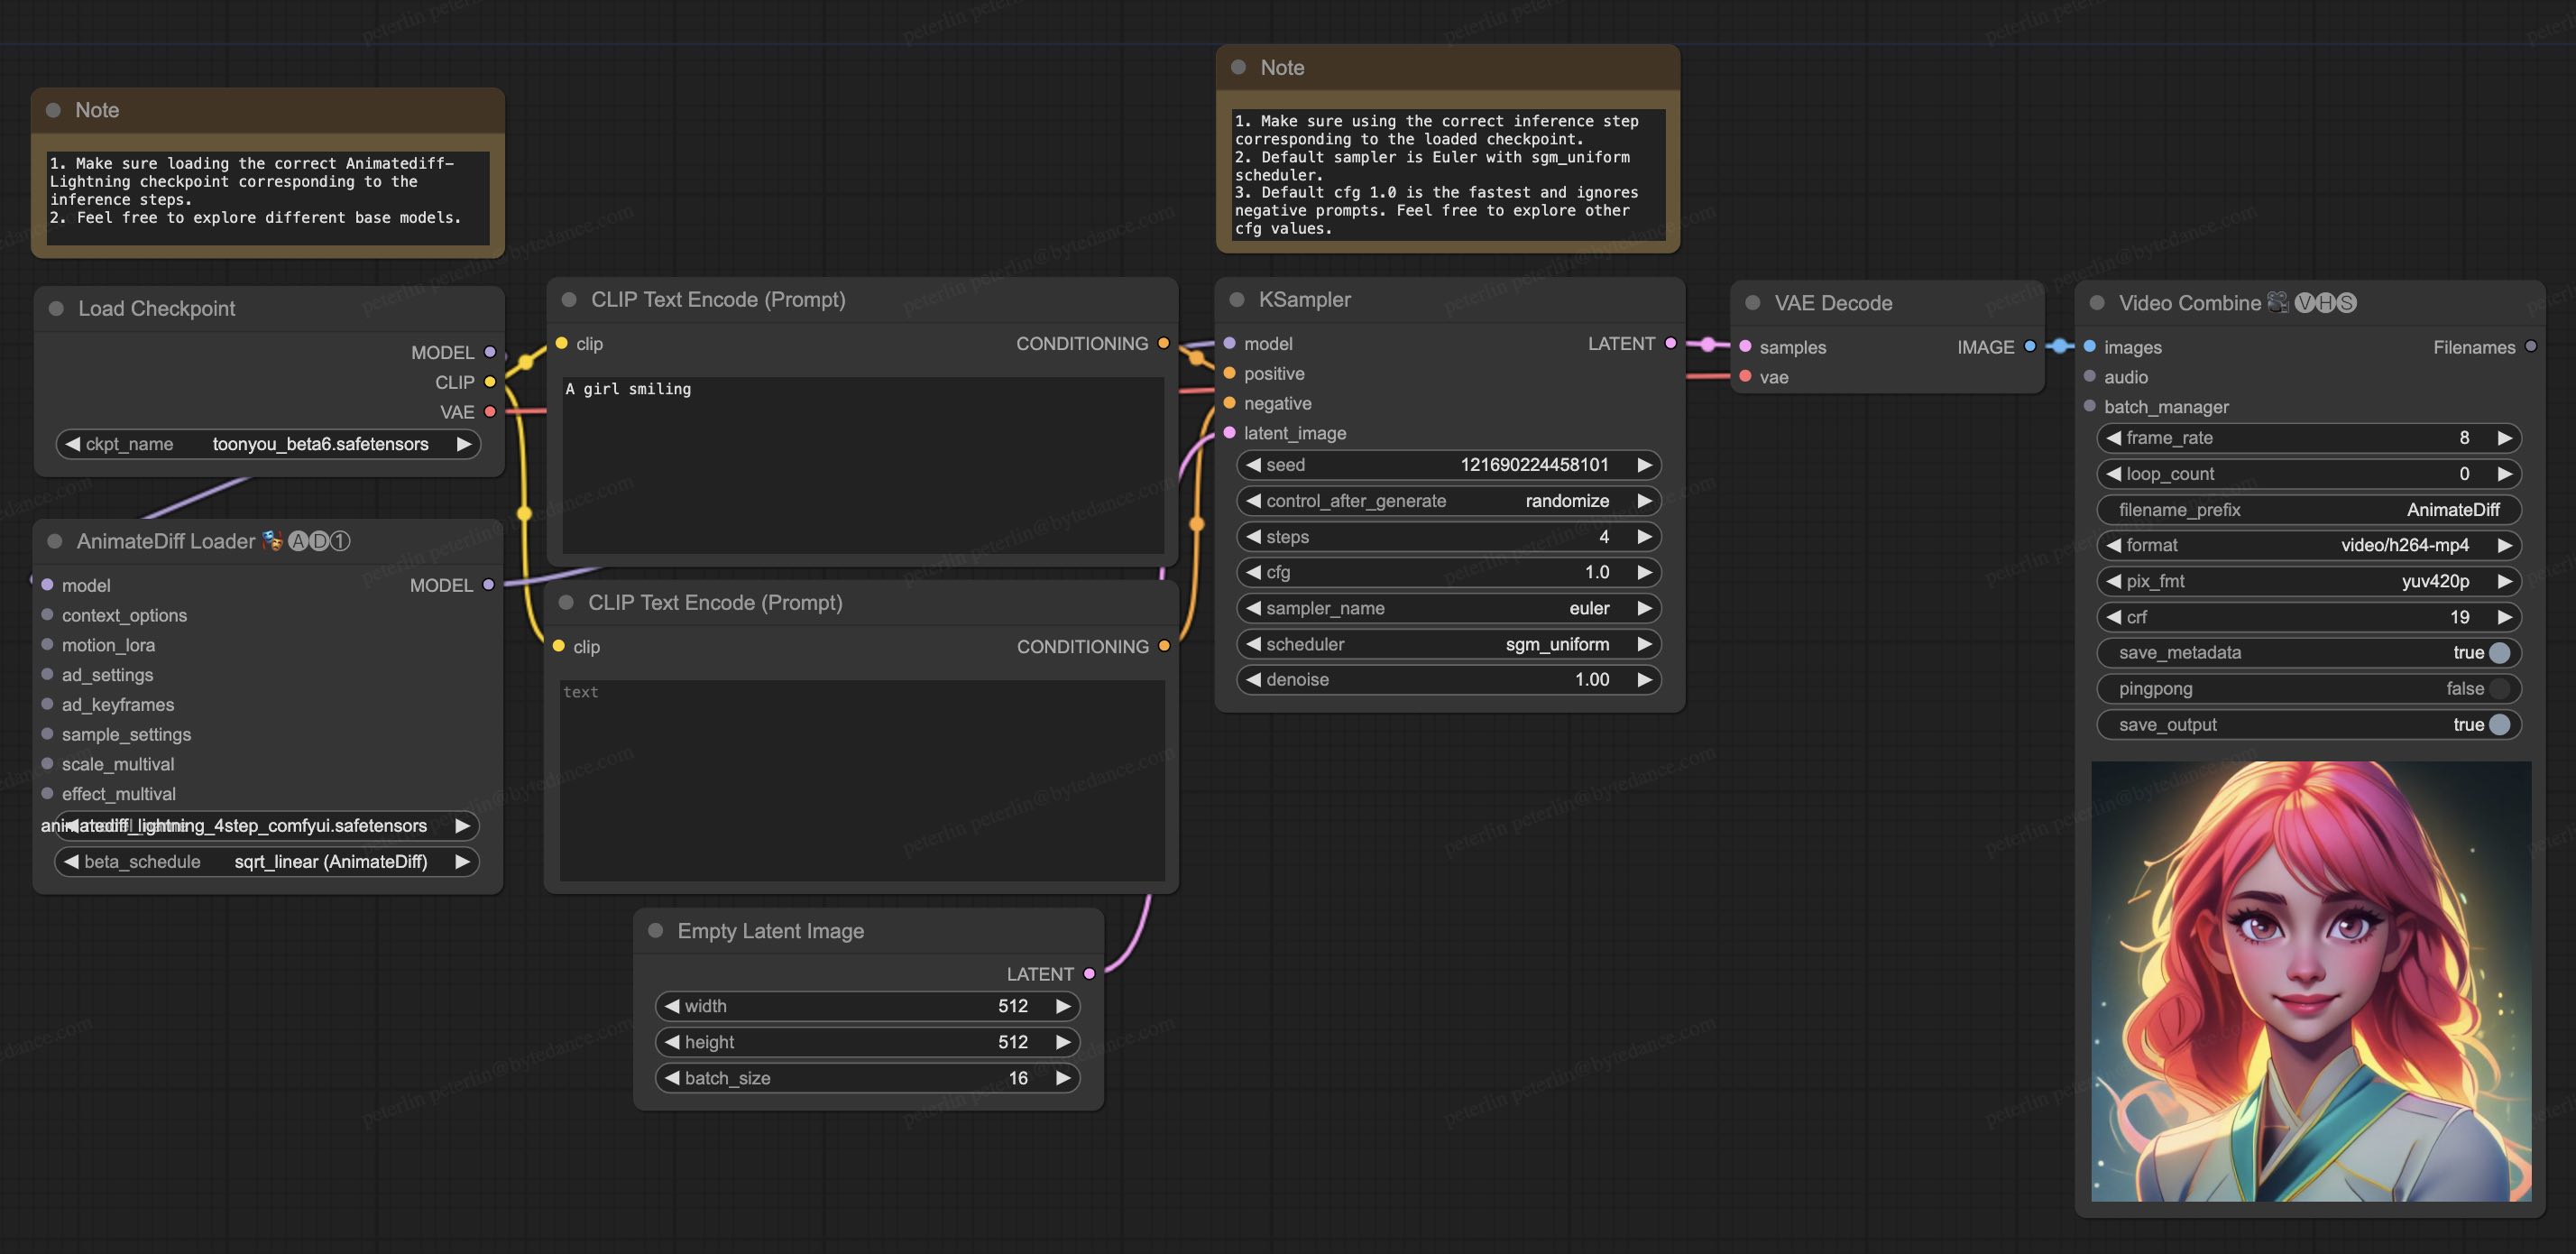
- Download animatediff_lightning_workflow.json and import it in ComfyUI.
- Install nodes. You can install them manually or use ComfyUI-Manager.
- Download your favorite base model checkpoint and put them under
/models/checkpoints/ - Download AnimateDiff-Lightning checkpoint
animatediff_lightning_Nstep_comfyui.safetensorsand put them under/custom_nodes/ComfyUI-AnimateDiff-Evolved/models/
Video-to-Video Generation
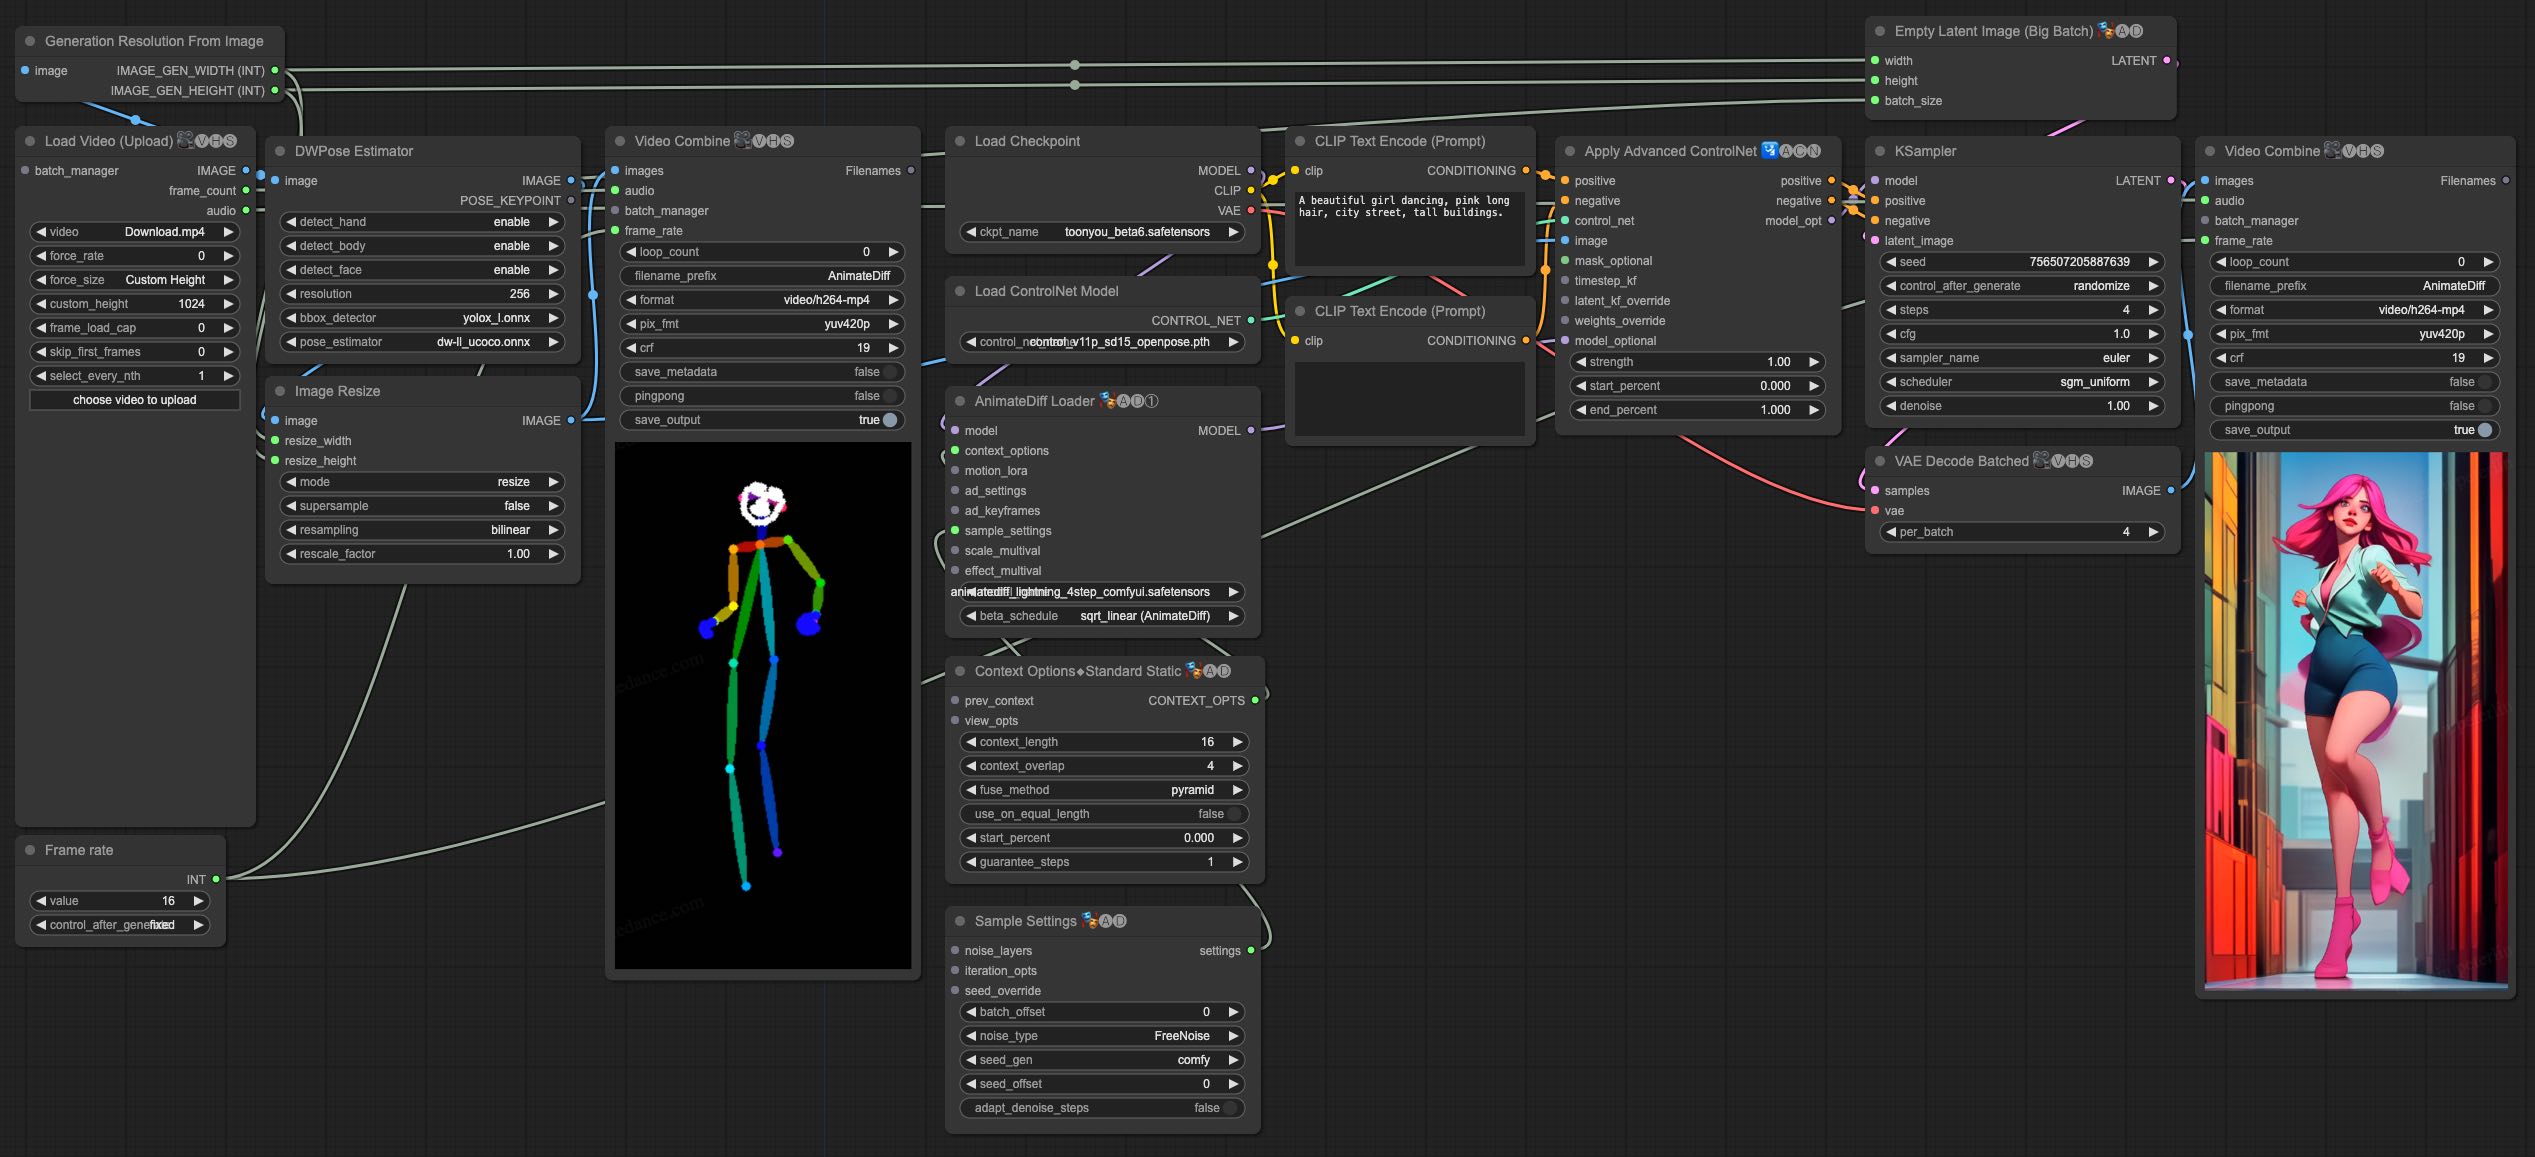
AnimateDiff-Lightning is great for video-to-video generation. We provide the simplist comfyui workflow using ControlNet.
- Download animatediff_lightning_v2v_openpose_workflow.json and import it in ComfyUI.
- Install nodes. You can install them manually or use ComfyUI-Manager.
- Download your favorite base model checkpoint and put them under
/models/checkpoints/ - Download AnimateDiff-Lightning checkpoint
animatediff_lightning_Nstep_comfyui.safetensorsand put them under/custom_nodes/ComfyUI-AnimateDiff-Evolved/models/ - Download ControlNet OpenPose
control_v11p_sd15_openpose.pthcheckpoint to/models/controlnet/ - Upload your video and run the pipeline.
Additional notes:
- Video shouldn't be too long or too high resolution. We used 576x1024 8 second 30fps videos for testing.
- Set the frame rate to match your input video. This allows audio to match with the output video.
- DWPose will download checkpoint itself on its first run.
- DWPose may get stuck in UI, but the pipeline is actually still running in the background. Check ComfyUI log and your output folder.
Cite Our Work
@misc{lin2024animatedifflightning,
      title={AnimateDiff-Lightning: Cross-Model Diffusion Distillation},
      author={Shanchuan Lin and Xiao Yang},
      year={2024},
      eprint={2403.12706},
      archivePrefix={arXiv},
      primaryClass={cs.CV}
}