Зрительная модель MLCD с 402,7 млн параметров для извлечения признаков и векторных представлений изображений.
52скачиваний за 30 дней11лайковвеса обновлены29 июл 2025
Бенчмарки
Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды
Публичные оценки
Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.
В подключённых источниках результатов для этой модели пока нет.
Что умеет модель
Описание составлено по карточке модели и метаданным Hugging Face
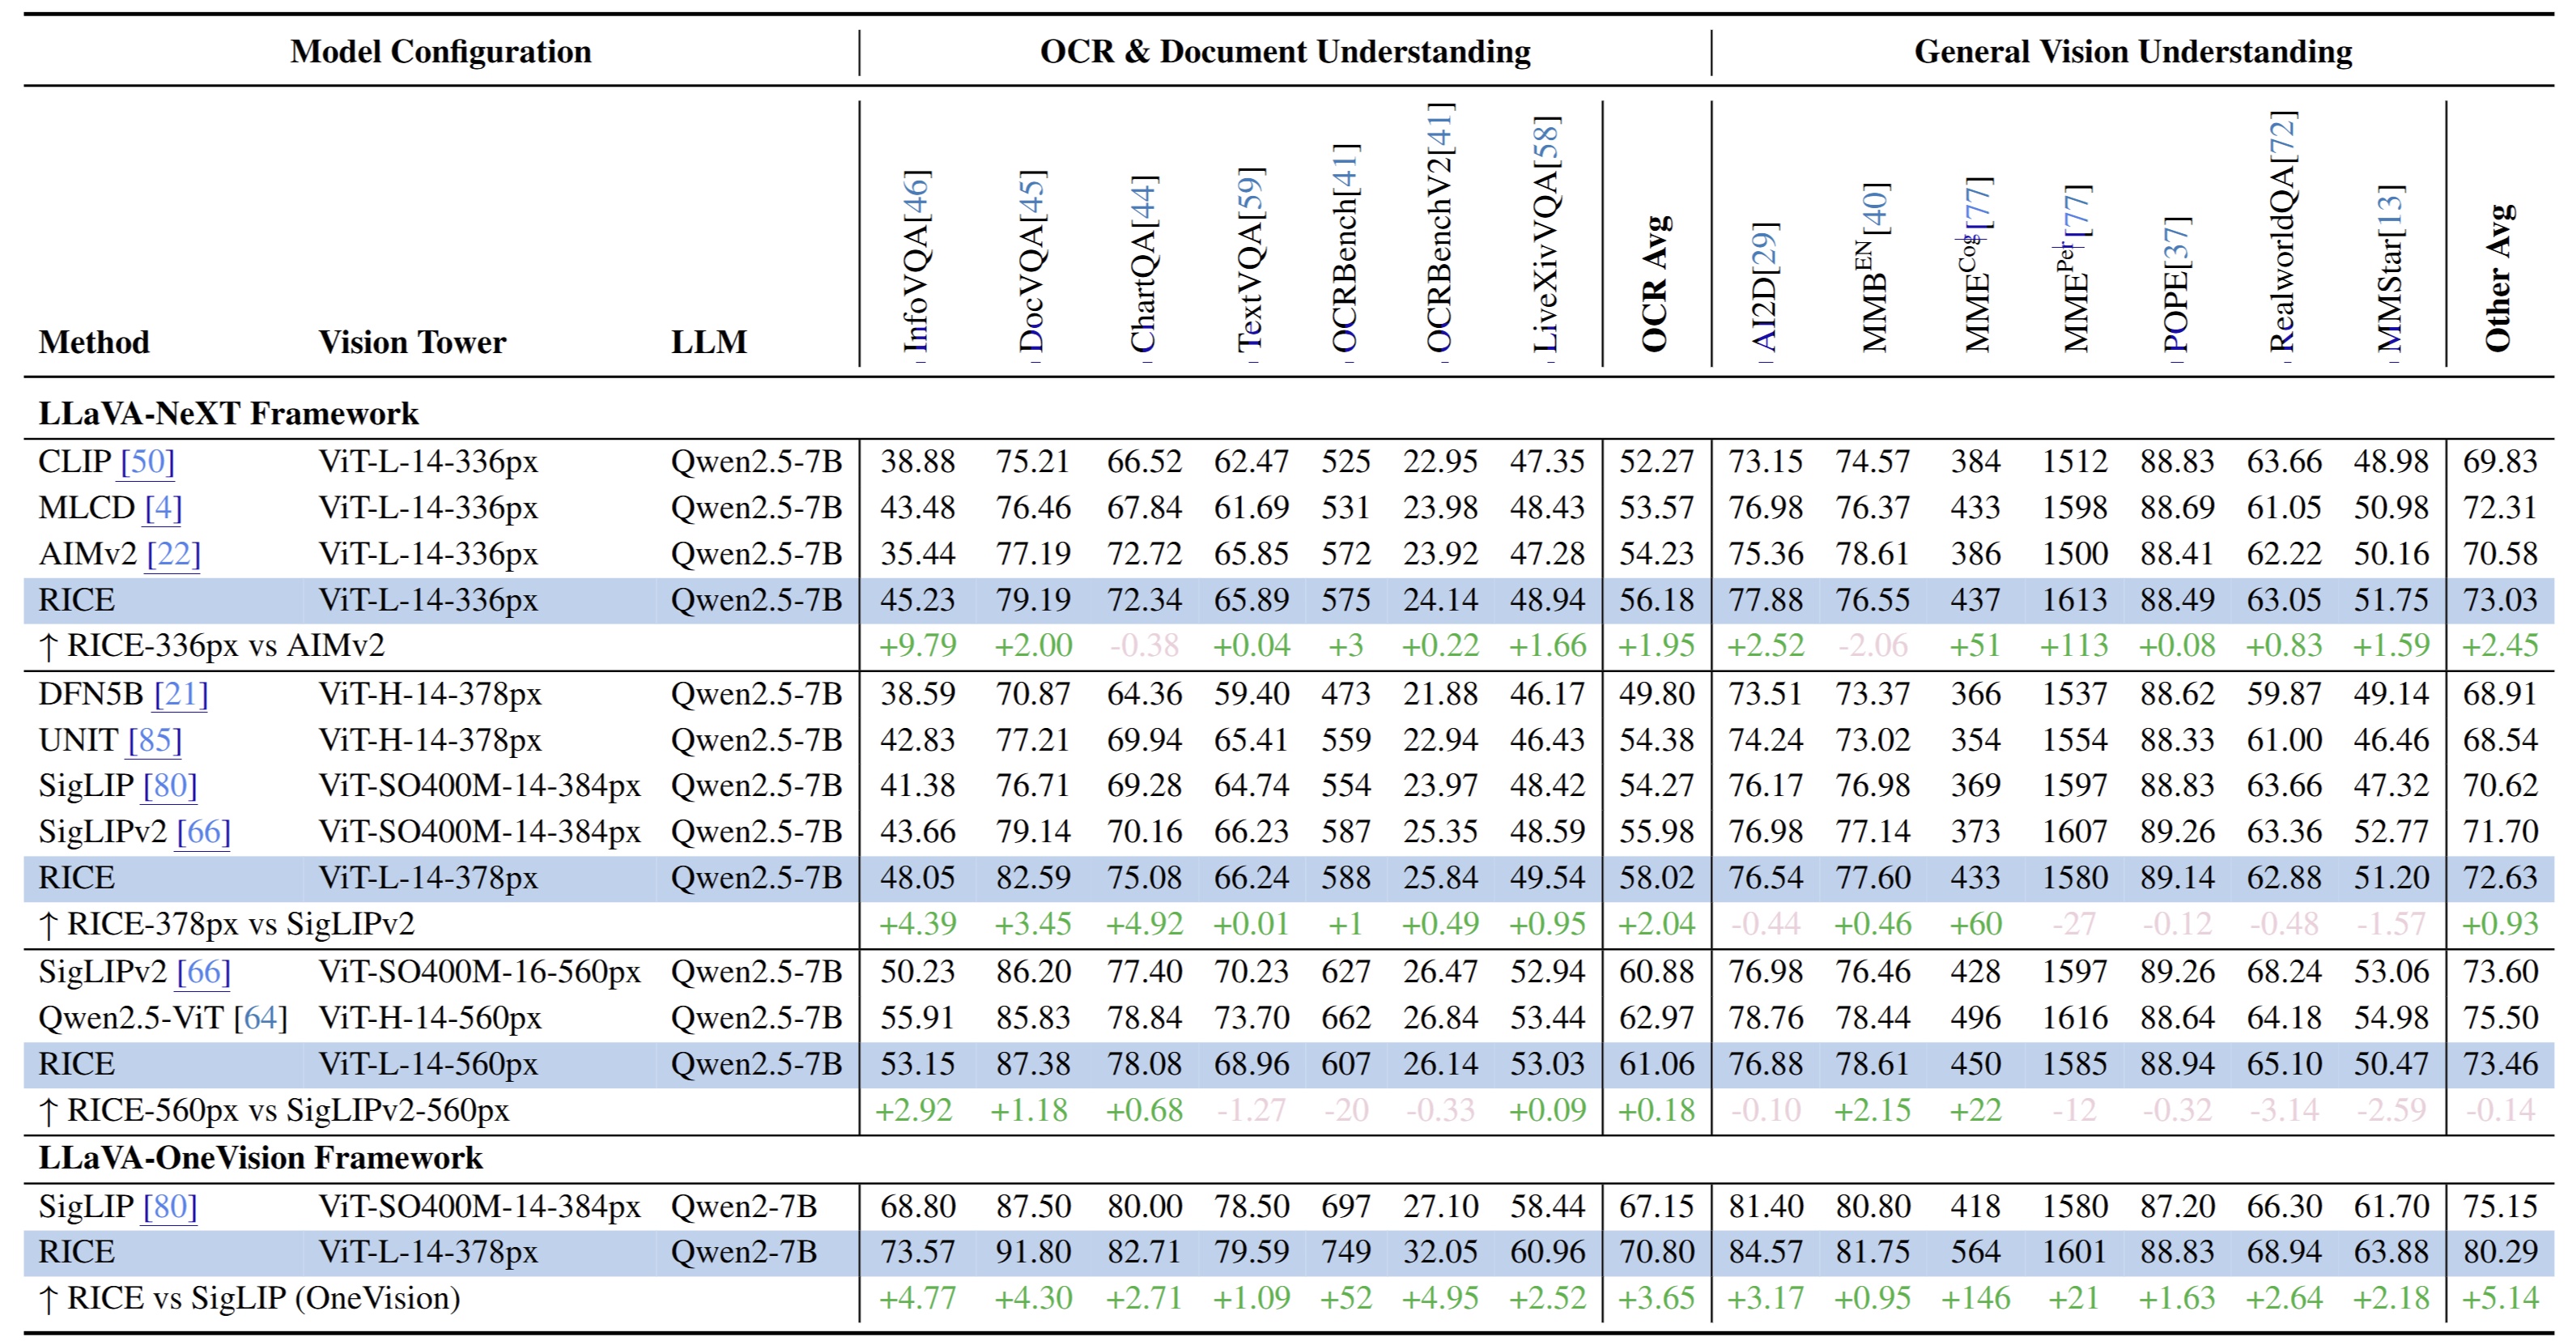
DeepGlint-AI/rice-vit-large-patch14-560 — модель извлечения признаков из изображений на архитектуре MLCDVisionModel. В репозитории указаны веса в формате safetensors; размер модели — 402,7 млн параметров. Модель предназначена для получения векторных представлений изображений, которые можно использовать в системах поиска и сопоставления изображений.
Модель разработана DeepGlint AI и распространяется по лицензии MIT. README называет её RICE-ViT-L, но не описывает обучение, целевые сценарии, поддерживаемые языки или показатели качества.
Сценарии применения
извлечение векторных признаков изображений
поиск похожих изображений по содержимому
сопоставление изображений в визуальной базе данных
Ограничения
README не приводит результатов оценки качества или подробностей обучения, поэтому пригодность для конкретных наборов данных и сценариев не подтверждена.
Для каких профессий подходит3
Разделы каталога профессий, в задачах которых используется эта модель
pip install torch transformers
git clone https://github.com/deepglint/unicom
cd unicom/mlcd
Usage
from vit_rope2d_hf import MLCDVisionModel
from transformers import CLIPImageProcessor
from PIL import Image
import requests
import torch

# Load model and processor
model = MLCDVisionModel.from_pretrained("DeepGlint-AI/rice-vit-large-patch14-560")
processor = CLIPImageProcessor.from_pretrained("DeepGlint-AI/rice-vit-large-patch14-560")

# Process single image
url = "http://images.cocodataset.org/val2017/000000039769.jpg"
image = Image.open(requests.get(url, stream=True).raw)
inputs = processor(images=image, return_tensors="pt")

# Get visual features
with torch.no_grad():
    outputs = model(**inputs)
features = outputs.last_hidden_state

print(f"Extracted features shape: {features.shape}")
Как запустить
На своей GPU в ailist. Цена — по текущим предложениям провайдеров