/ Модель

Характеристики

Лицензия
CreativeML OpenRAIL-M
Опубликована
25 янв 2023

ARTificialJourney-v1.0-768

Генерация изображенийТекст → изображение3 профессии

Модель Stable Diffusion для создания художественных крупных портретов и пейзажей по текстовым запросам.

41скачиваний за 30 дней15лайковвеса обновлены27 янв 2023

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Тесты пользователейпока нет

Никто ещё не опубликовал тест этой модели. Соберите бенчмарк из своих задач — результат появится здесь.

  1. Добавьте модель в бенчмарк

    Вместе с другими моделями категории «Изображения» — сравнение идёт внутри одной категории.

  2. Опишите свои задачи

    Напишите запросы, при необходимости приложите файлы и эталонные ответы.

  3. Запустите и опубликуйте

    Модели сгенерируют результат по каждой задаче. Опубликованный тест появится на этой странице.

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

ARTificialJourney-v1.0-768 — модель генерации изображений на основе Stable Diffusion, опубликованная Kaludi. Она обучена примерно на 100 вручную отобранных изображениях размером 768×768 и настроена на создание крупных портретов и пейзажей по текстовому описанию.

Для получения характерного результата автор рекомендует добавлять к запросу фразу «artificial-journey style» и подробно описывать сцену. Лучше всего подходят разрешения 768×768, 1024×768 и 768×1024. Модель доступна в форматах Diffusers, PyTorch и Safetensors; лицензия — CreativeML OpenRAIL-M.

Модель слабо подходит для полнофигурных портретов, поскольку обучающие изображения преимущественно показывают крупные планы. README не приводит оценки качества или подробностей о базовой версии Stable Diffusion.

Сценарии применения

  • создание крупных художественных портретов по описанию
  • генерация пейзажей в стиле ARTificialJourney
  • создание изображений с указанной композицией и деталями
  • подготовка иллюстраций в разрешении 768×768

Ограничения

Полнофигурные портреты получаются хуже крупных планов. Для характерного стиля автор рекомендует использовать фразу «artificial-journey style» и подробные текстовые запросы.

Для каких профессий подходит3

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

ARTificialJourney-1.0 768X768

This is an AI model trained on ~100 hand picked 768X768 images targeted to get the best close up portrait pictures, as well as amazing looking landscapes. This model does not handle full-body portraits well due to being trained on more close up images, but it will be improved in the next update of this model. Please use the keywords "artificial-journey style" before or after the prompt. Also be sure to add more detailed text to the prompt to get the best results. Resolutions 1024x768px, 768x1024px, and 768x768 work best for this model.

.safetensors file was generated using the new sd-webui-model-converter.

Examples (As is images, no upsclaing or face improvements were used)
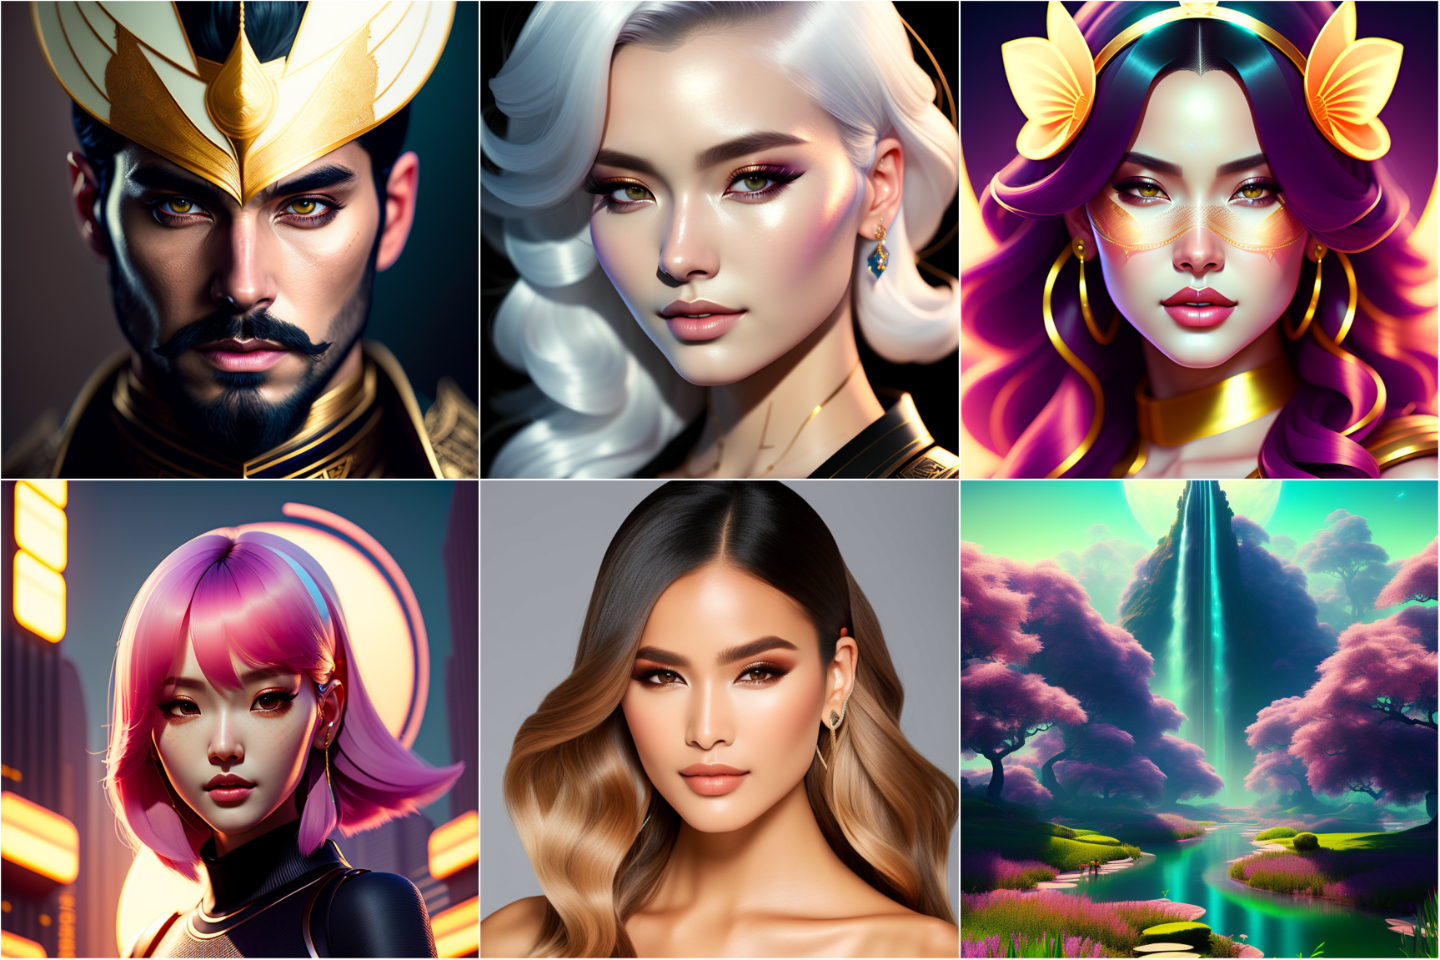
img

Have fun generating!

CKPT & Safetensors Download

Download ARTificialJourneyV1-768px.ckpt) (2.9GB)

Download ARTificialJourneyV1-768px.safetensors) (2.9GB)

🧨 Diffusers

This model can be used just like any other Stable Diffusion model. For more information, please have a look at the Stable Diffusion Pipeline.

from diffusers import StableDiffusionPipeline, DPMSolverMultistepScheduler
import torch

prompt = (
"artificial-journey style portrait of male dark magician, d & d, dark eyeliner, intricate, elegant, highly detailed, digital painting, artstation, concept art, matte, sharp focus, illustration")

model_id = "Kaludi/ARTificialJourney-v1.0-768"
pipe = StableDiffusionPipeline.from_pretrained(model_id, torch_dtype=torch.float16)
pipe.scheduler = DPMSolverMultistepScheduler.from_config(pipe.scheduler.config)
pipe = pipe.to("cuda")

image = pipe(prompt, num_inference_steps=30).images[0]

image.save("./result.jpg")
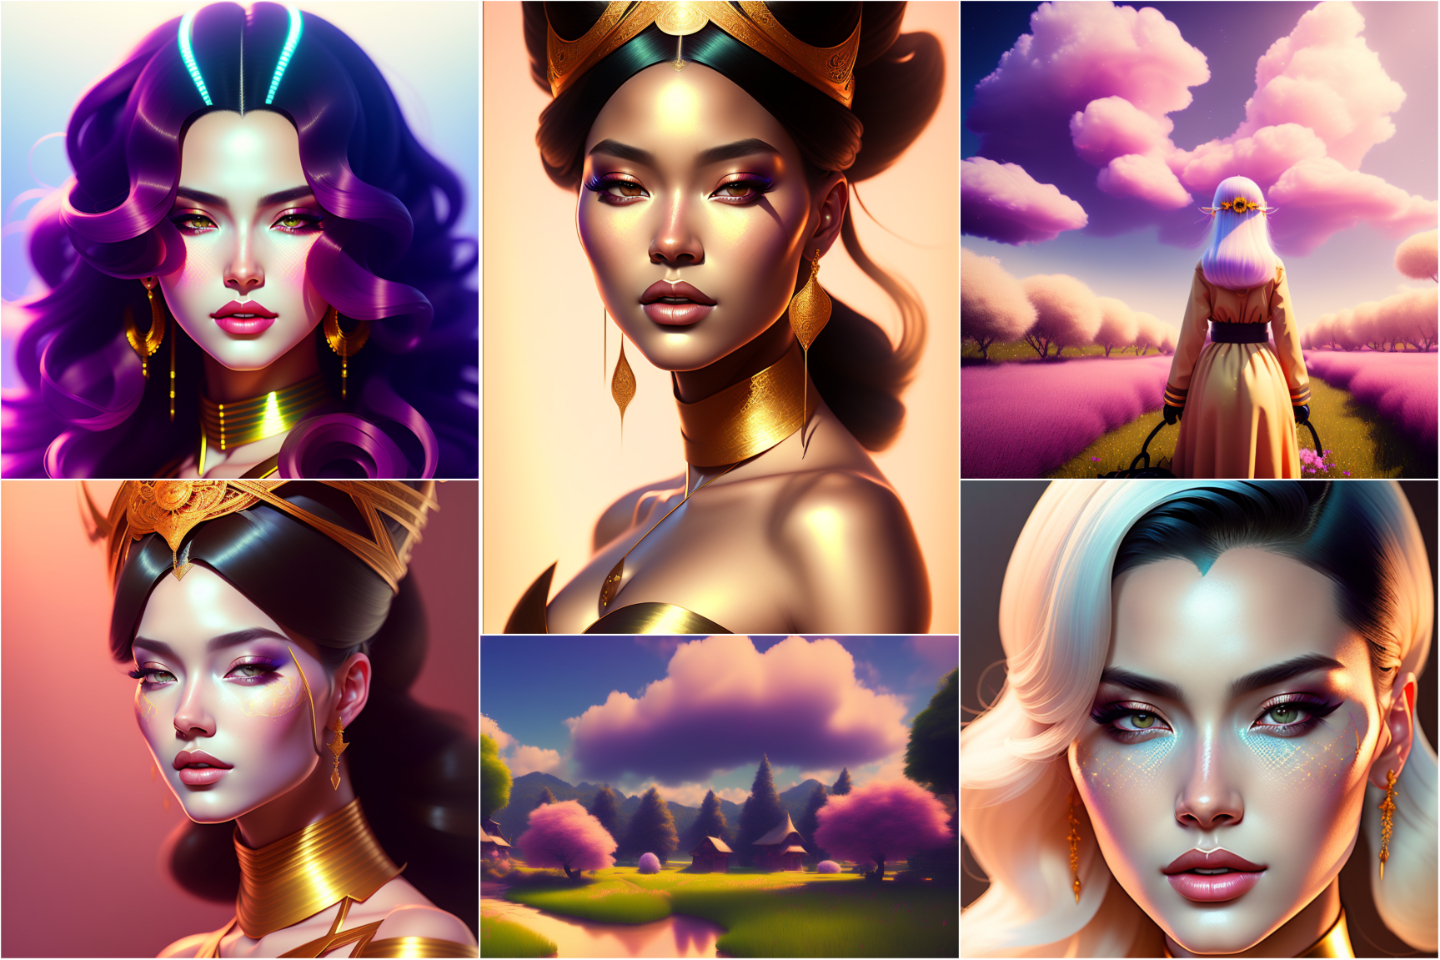
img

License

This model is open access and available to all, with a CreativeML OpenRAIL-M license further specifying rights and usage. The CreativeML OpenRAIL License specifies:

  1. You can't use the model to deliberately produce nor share illegal or harmful outputs or content
  2. The authors claims no rights on the outputs you generate, you are free to use them and are accountable for their use which must not go against the provisions set in the license
  3. You may re-distribute the weights and use the model commercially and/or as a service. If you do, please be aware you have to include the same use restrictions as the ones in the license and share a copy of the CreativeML OpenRAIL-M to all your users (please read the license entirely and carefully) Please read the full license here

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм

Можно запустить

Подбираем GPU…

Ревизия весов
c869b85

0 моделей