Bamboo 400M
This is a WIP foundational (aka base) model trained only on public domain (CC0) datasets, primarily in the English language.
Further training is planned & ongoing, but currently no multi-language datasets are in use or planned; though this may change in the future and the current datasets can contain languages other than English.
License
Though the training data of this model is CC0, the model itself is not. The model is released under the OpenRAIL license, as tagged.
Planned updates
As mentioned, a few updates are planned:
- Further training on more CC0 data, this model's weights will be updated as we pretrain on more of the listed datasets.
- Experiment with extending the context length using YaRN to 32k tokens.
- Fine-tuning the resulting model for instruct, code and storywriting. These will then be combined using MergeKit to create a MoE model.
- Release a GGUF version and an extended context version of the base model
Other model versions
- None yet
Model Performance Tracking
This table tracks the performance of our model on various tasks over time. The metric used is 'acc'.
| Date (YYYY-MM-DD) | arc_easy | hellaswag | sglue_rte | truthfulqa | Avg |
|---|---|---|---|---|---|
| 2024-07-30-2 | 28.91% ± 0.94% | 25.32% ± 0.43% | 50.54% ± 3.01% | 41.31% ± 1.16% | 36.52% |
| 2024-07-30 | 29.50% ± 0.94% | 25.36% ± 0.43% | 50.54% ± 3.01% | 41.07% ± 1.16% | 36.60% |
| 2024-07-29 | 32.24% ± 0.96% | 25.74% ± 0.44% | 47.29% ± 3.01% | 39.91% ± 1.11% | 36.30% |
| 2024-07-27 | 27.40% ± 0.92% | 25.52% ± 0.44% | 52.71% ± 3.01% | 39.52% ± 1.11% | 36.29% |
Legend
- Date: The date of the model that the evaluation was run on. Pretraining is ongoing and tests are re-run with that date's model.
- Metric: The evaluation metric used (acc = accuracy)
- Task columns: Results for each task in the format "Percentage ± Standard Error"
Notes
- All accuracy values are presented as percentages
- Empty cells indicate that the task was not evaluated on that date or for that metric
- Standard errors are also converted to percentages for consistency
Tokenizer
Our tokenizer was trained from scratch on 500,000 samples from the Openwebtext dataset. Like Mistral, we use the LlamaTokenizerFast as our tokenizer class; in legacy mode.
Tokenization Analysis
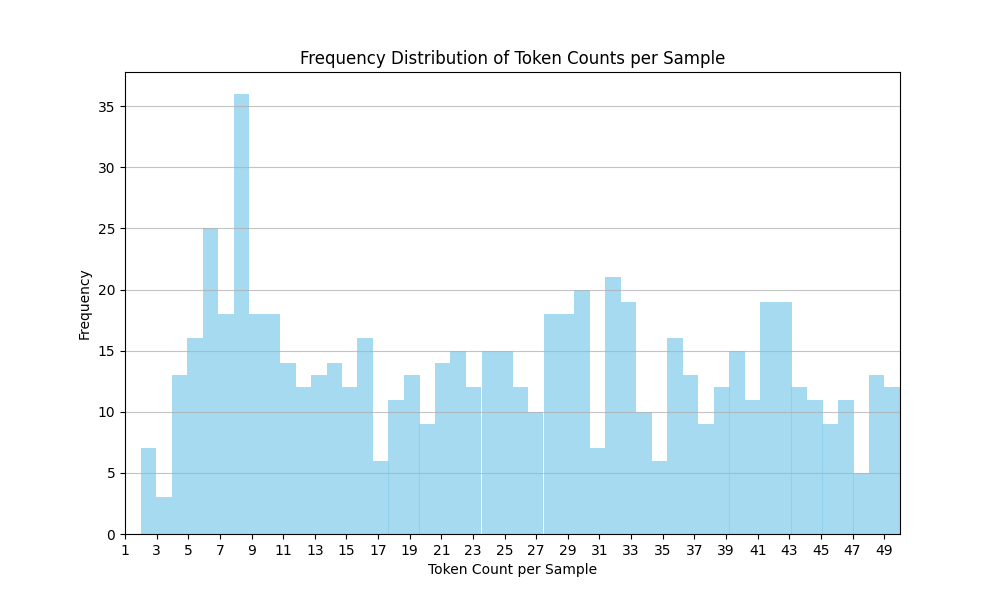
The histogram below illustrates the distribution of token counts per sample in our Mistral tokenizer, trained on 500,000 samples. This analysis provides insights into the tokenizer's behavior and its ability to handle various sentence lengths. The histogram was created using 10,000 samples of tokenization.
Key Observations:
- Broad Range: The tokenizer effectively handles a wide range of sentence lengths, with token counts spanning from 1 to over 50.
- Smooth Distribution: The distribution is relatively smooth, indicating consistent tokenization across different sentence lengths.
- Short Sequence Preference: Most sequences fall below 20 tokens, aligning with the efficiency goals of Mistral models.
- Peak at 7 Tokens: A peak around 7 tokens suggests the tokenizer might have a preference for splitting sentences at this length. This could be investigated further if preserving longer contexts is a priority.
Overall: The tokenizer demonstrates a balanced approach, predominantly producing shorter sequences while still accommodating longer and more complex sentences. This balance promotes both computational efficiency and the ability to capture meaningful context.
Further Analysis: While the tokenizer performs well overall, further analysis of the peak at 7 tokens and the lower frequency of very short sequences (1-3 tokens) could provide additional insights into its behavior and potential areas for refinement.
Theory On 7-token peak: Since English sentences have an average of 15-20 words, our tokenizer may be splitting them into 7-9 tokens, which would possibly explain this peak.