/ Модель

Характеристики

Контекст
2 048 токенов
Параметры
6,6 млрд
Размер весов
27 ГБ
Лицензия
Apache 2.0
Архитектура
llama · dense
Опубликована
29 июн 2024

FBI-LLM_7B

Генерация текстаТекст → текст3 профессии

FBI-LLM 7B — полностью бинарная языковая модель семейства Llama для исследования генерации текста и обучения LLM с нуля.

91скачиваний за 30 дней2лайкавеса обновлены10 июл 2024

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Тесты пользователейпока нет

Никто ещё не опубликовал тест этой модели. Соберите бенчмарк из своих задач — результат появится здесь.

  1. Добавьте модель в бенчмарк

    Вместе с другими моделями категории «Текст» — сравнение идёт внутри одной категории.

  2. Опишите свои задачи

    Напишите запросы, при необходимости приложите файлы и эталонные ответы.

  3. Запустите и опубликуйте

    Модели ответят на каждую задачу, судья оценит ответы. Опубликованный результат появится на этой странице.

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

FBI-LLM 7B — полностью бинарная авторегрессионная языковая модель, разработанная Liqun Ma и соавторами. Это исследовательская модель семейства Llama, обученная с нуля с использованием авторегрессионной дистилляции; в отличие от обычных моделей той же размерности, её веса представлены в бинарном виде. В репозитории доступны веса PyTorch с 6,6 млрд параметров, а для токенизации используется токенизатор Llama 2 7B.

Модель принимает текст и генерирует текст. Она предназначена для изучения обучения крупных бинарных языковых моделей с нуля и оценки их способности к авторегрессионной генерации; обучение проводилось на наборе данных Amber. В карточке заявлена конкурентоспособность по perplexity и отдельным задачам, однако конкретные сценарии практического применения подробно не описаны. Контекст составляет 2048 токенов, основной указанный язык — английский. Лицензия репозитория — Apache-2.0.

Сценарии применения

  • исследование полностью бинарных языковых моделей
  • эксперименты с авторегрессионной дистилляцией
  • оценка генерации текста бинарной LLM
  • сравнение бинарных и полноточных языковых моделей

Ограничения

Модель и её результаты представлены как исследовательская работа; карточка не приводит подробных оценок качества по конкретным пользовательским сценариям. Контекст ограничен 2048 токенами.

Для каких профессий подходит3

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

FBI-LLM-7B

Model Details

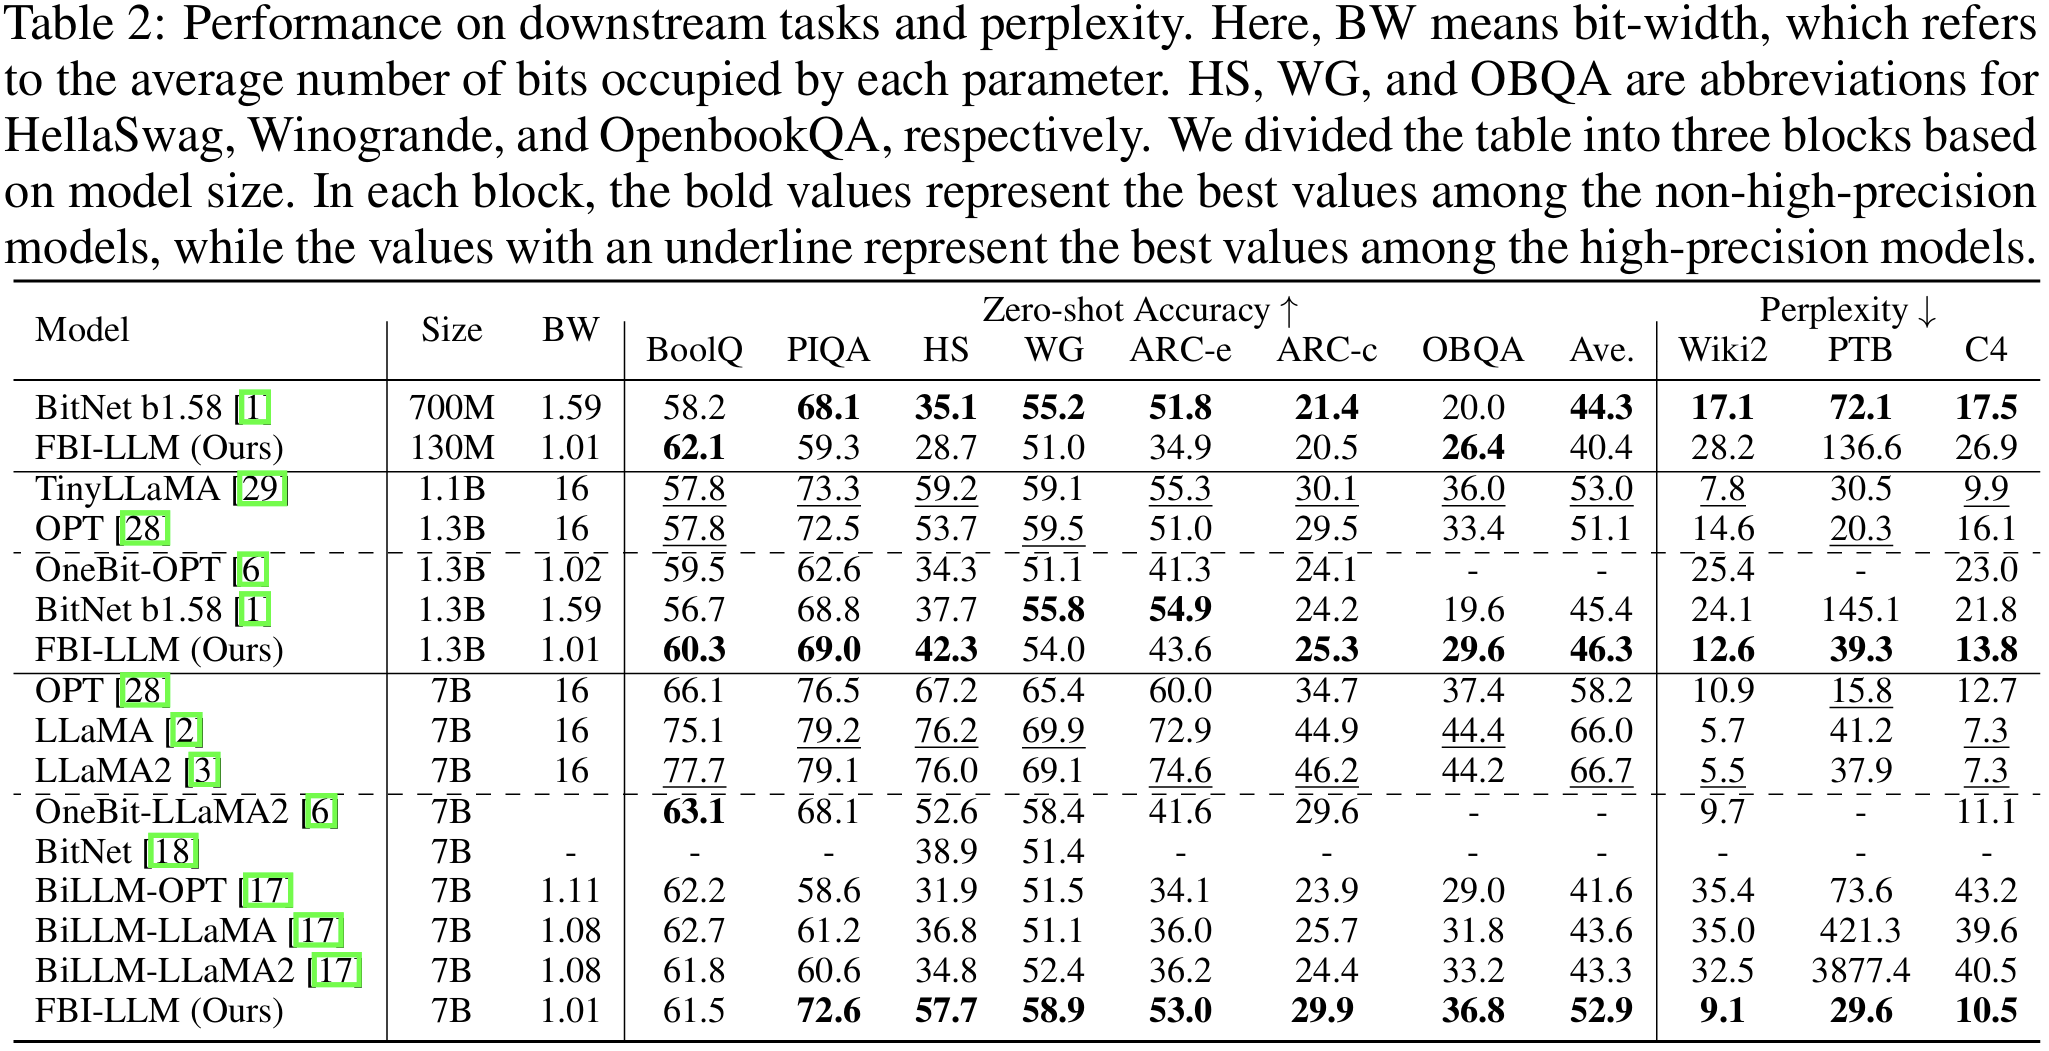
This work presents a Fully BInarized Large Language Model (FBI-LLM), demonstrating for the first time how to train a large-scale binary language model (not the ternary LLM like BitNet b1.58 from scratch to match the performance of its full-precision counterparts (e.g., FP16 or BF16) in transformer-based LLMs. It achieves this by employing an autoregressive distillation (AD) loss with maintaining equivalent model dimensions (130M, 1.3B, 7B) and training data volume as regular LLM pretraining, while delivering competitive results in terms of perplexity and task-specific effectiveness. Intriguingly, by analyzing the training trajectory, we find that the pretrained weight is not necessary for training binarized LLMs from scratch. This research encourages a new computational framework and may facilitate the future design of specialized hardware tailored for fully 1-bit LLMs. We make all models, code, and training dataset fully accessible and transparent to support further research.

Input: Models input text only.

Output: Models generate text only.

Tokenizer

We use the same tokenizer as meta-llama/Llama-2-7b-hf

Training Data

We use AmberDateset to train our models.

Result

<img src=https://huggingface.co/LiqunMa/FBI-LLM_7B/resolve/main/main_result.jpg width="90%" />
How to use

Please download the code from LiqunMa/FBI-LLM firstly

from pathlib import Path
from transformers import AutoTokenizer,LlamaConfig,LlamaForCausalLM, AutoModelForCausalLM
from qat.replace_module import replace_with_learnable_binarylinear


def load_model(model_size, model_dir):
    assert model_size in ["130M", "1.3B", "7B"]

    model_dir = Path(model_dir)
    with Path(f'FBI-LLM_configs/FBI-LLM_llama2_{model_size}.json').open('r') as r_f:
        config = json.load(r_f)
    llama_config = LlamaConfig(**config)
    model = LlamaForCausalLM(llama_config).to('cuda')
    tokenizer = AutoTokenizer.from_pretrained('meta-llama/Llama-2-7b-hf', padding_side="right", use_fast=False)
    model = replace_with_learnable_binarylinear(model, scaling_pattern = "column", keep_parts = ["lm_head"])

    weight_dict = {}
    ckpt_plist = [p for p in model_dir.iterdir() if p.suffix == '.bin']
    for p in ckpt_plist:
      weight_dict = torch.load(p)
      for k,v in _weight_dict.items():
        if 'self_attn.rotary_emb.inv_freq' not in k:
          weight_dict[k] = v

    model.load_state_dict(weight_dict)
    for param in model.parameters():
        param.data = param.data.to(torch.float16)

    return model, tokenizer

Citation

BibTeX:

@misc{ma2024fbillmscalingfullybinarized,
      title={FBI-LLM: Scaling Up Fully Binarized LLMs from Scratch via Autoregressive Distillation}, 
      author={Liqun Ma and Mingjie Sun and Zhiqiang Shen},
      year={2024},
      eprint={2407.07093},
      archivePrefix={arXiv},
      primaryClass={cs.CL},
      url={https://arxiv.org/abs/2407.07093}, 
}

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм

Можно запустить

Подбираем GPU…

Класс архитектуры
LlamaForCausalLM
Ревизия весов
62814d1

0 моделей