Massively Multilingual Adaptation of Large Language Models Using Bilingual Translation Data
Model Description
EMMA-500 Llama 3.1 8B is a state-of-the-art multilingual language model designed to improve language representation, especially in low-resource languages, through continual pre-training on the Llama 3.1 8B architecture. Leveraging the MaLA Corpus, which spans over 500 languages and is augmented with books, code, instruction data, and papers, EMMA-500 excels in multilingual tasks like commonsense reasoning, machine translation, and text classification.
- Project Website: https://mala-lm.github.io/emma-500-gen2.html
- Paper: https://arxiv.org/abs/2506.00469
Model Details
- Architecture: Built on Llama 3.1 8B with enhanced language adaptation through continual pre-training.
- Languages: Supports 546 languages with substantial training data (over 100k tokens each).
- Data Mix: A diverse bilingual mix of text from domains like code, books, instruction data, and papers.
- Total Tokens: 671B
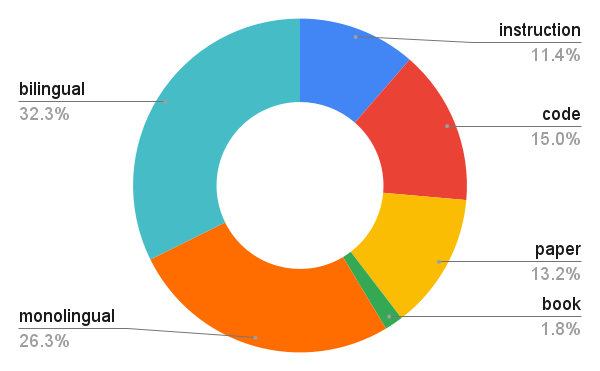
EMMA-500 series
- 🤗MaLA-LM/emma-500-llama2-7b: CPT model trained on monolingual data mix in 500+ languages
- 🤗MaLA-LM/emma-500-llama3-8b-mono: CPT model trained on monolingual data mix in 500+ languages
- 🤗MaLA-LM/emma-500-llama3-8b-bi: CPT model trained on monolingual data mix in 500+ languages + bilingual translation data in 2,500+ language pairs
- 🤗MaLA-LM/emma-500-llama3.1-8b-mono: CPT model trained on monolingual data mix in 500+ languages
- 🤗MaLA-LM/emma-500-llama3.1-8b-bi: CPT model trained on monolingual data mix in 500+ languages + bilingual translation data in 2,500+ language pairs
Data Access
🤗MaLA Corpus Dataset Collection
- MaLA monolingual corpus: 🤗MaLA-LM/mala-monolingual-split
- MaLA bilingual translation corpus: 🤗MaLA-LM/mala-bilingual-translation-corpus
- MaLA code and reasoning corpus: 🤗MaLA-LM/mala-code-reasoning-v2
Usage
You can use EMMA-500 for multilingual text generation. Below is an example to generate text using the model:
from transformers import AutoModelForCausalLM, AutoTokenizer

model_name = "MaLA-LM/emma-500-llama3.1-8b-bi"
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(model_name)

input_text = "Once upon a time"
inputs = tokenizer(input_text, return_tensors="pt")
outputs = model.generate(**inputs)

print(tokenizer.decode(outputs[0], skip_special_tokens=True))
Use Cases
- Massively multilingual NLP tasks, e.g., machine translation
- Performance regression on some tasks and high-resource languages
- Cannot be used for real-world scenarios, esp. in high-stakes domains.
Citation
If you find this model useful, please cite the paper below.
@inproceedings{ji-etal-2026-data,
  title     = {Data-Centric Continual Pre-training for 500+ Languages: A New Bilingual Translation Corpus and Multilingual Models},
  author    = {Ji, Shaoxiong  and
               Li, Zihao  and
               Paavola, Jaakko  and
               Luo, Hengyu  and
               Tiedemann, J{\"o}rg},
  editor    = {Liakata, Maria  and
               Moreira, Viviane P.  and
               Zhang, Jiajun  and
               Jurgens, David},
  booktitle = {Findings of the {A}ssociation for {C}omputational {L}inguistics: {ACL} 2026},
  month     = jul,
  year      = {2026},
  address   = {San Diego, California, United States},
  publisher = {Association for Computational Linguistics},
  url       = {https://aclanthology.org/2026.findings-acl.937/},
  doi       = {10.18653/v1/2026.findings-acl.937},
  pages     = {18776--18807},
  isbn      = {979-8-89176-395-1}
}

@article{ji2025emma2,
      title={Massively Multilingual Adaptation of Large Language Models Using Bilingual Translation Data},
      author={Shaoxiong Ji and Zihao Li and Jaakko Paavola and Indraneil Paul and Hengyu Luo and Jörg Tiedemann},
      year={2025},
      journal={arXiv preprint 2506.00469},
      url={https://arxiv.org/abs/2506.00469},
}
Check out the below paper for the precedent EMMA-500 model trained on Llama 2 (🤗MaLA-LM/emma-500-llama2-7b).
@article{ji2024emma500enhancingmassivelymultilingual,
      title={{EMMA}-500: Enhancing Massively Multilingual Adaptation of Large Language Models},
      author={Shaoxiong Ji and Zihao Li and Indraneil Paul and Jaakko Paavola and Peiqin Lin and Pinzhen Chen and Dayyán O'Brien and Hengyu Luo and Hinrich Schütze and Jörg Tiedemann and Barry Haddow},
      year={2024},
      journal={arXiv preprint 2409.17892},
      url={https://arxiv.org/abs/2409.17892},
}