.
.
.
.
.
.
❗❗❗❗❗❗❗❗❗❗❗❗❗❗❗❗❗❗❗❗❗❗❗❗❗❗❗❗❗❗❗❗
This version is deprecated.
Please use Mitsua Diffusion One, which is a successor of this model.
❗❗❗❗❗❗❗❗❗❗❗❗❗❗❗❗❗❗❗❗❗❗❗❗❗❗❗❗❗❗❗❗
.
.
.
.
.
Mitsua Diffusion CC0 Model Card
Mitsua Diffusion CC0 is a latent text-to-image diffusion model, whose U-Net is trained from scratch using only public domain/CC0 or copyright images with permission for use.
Text Encoder and VAE are borrowed from Stable Diffusion v2.1 base.
This will be used as a base model for AI VTuber Elan Mitsua🖌️’s activity.
❗❗ Currently the model has super low visual quality and limited diversity ❗❗
Yes, the visual quality is not so good. Most of modern artistic concept is lost completely. However, since she is a growing AI in an ethical fashion, it would be good starting point for Mitsua-chan!
You can join her training on Twitter! Please support Mitsua-chan!🎉
Further training will be done in a fully opt-in basis. If you are interested in, please click here to submit an opt-in application.
We are active on a Discord server for opt-in participants only. Communication is currently in Japanese.
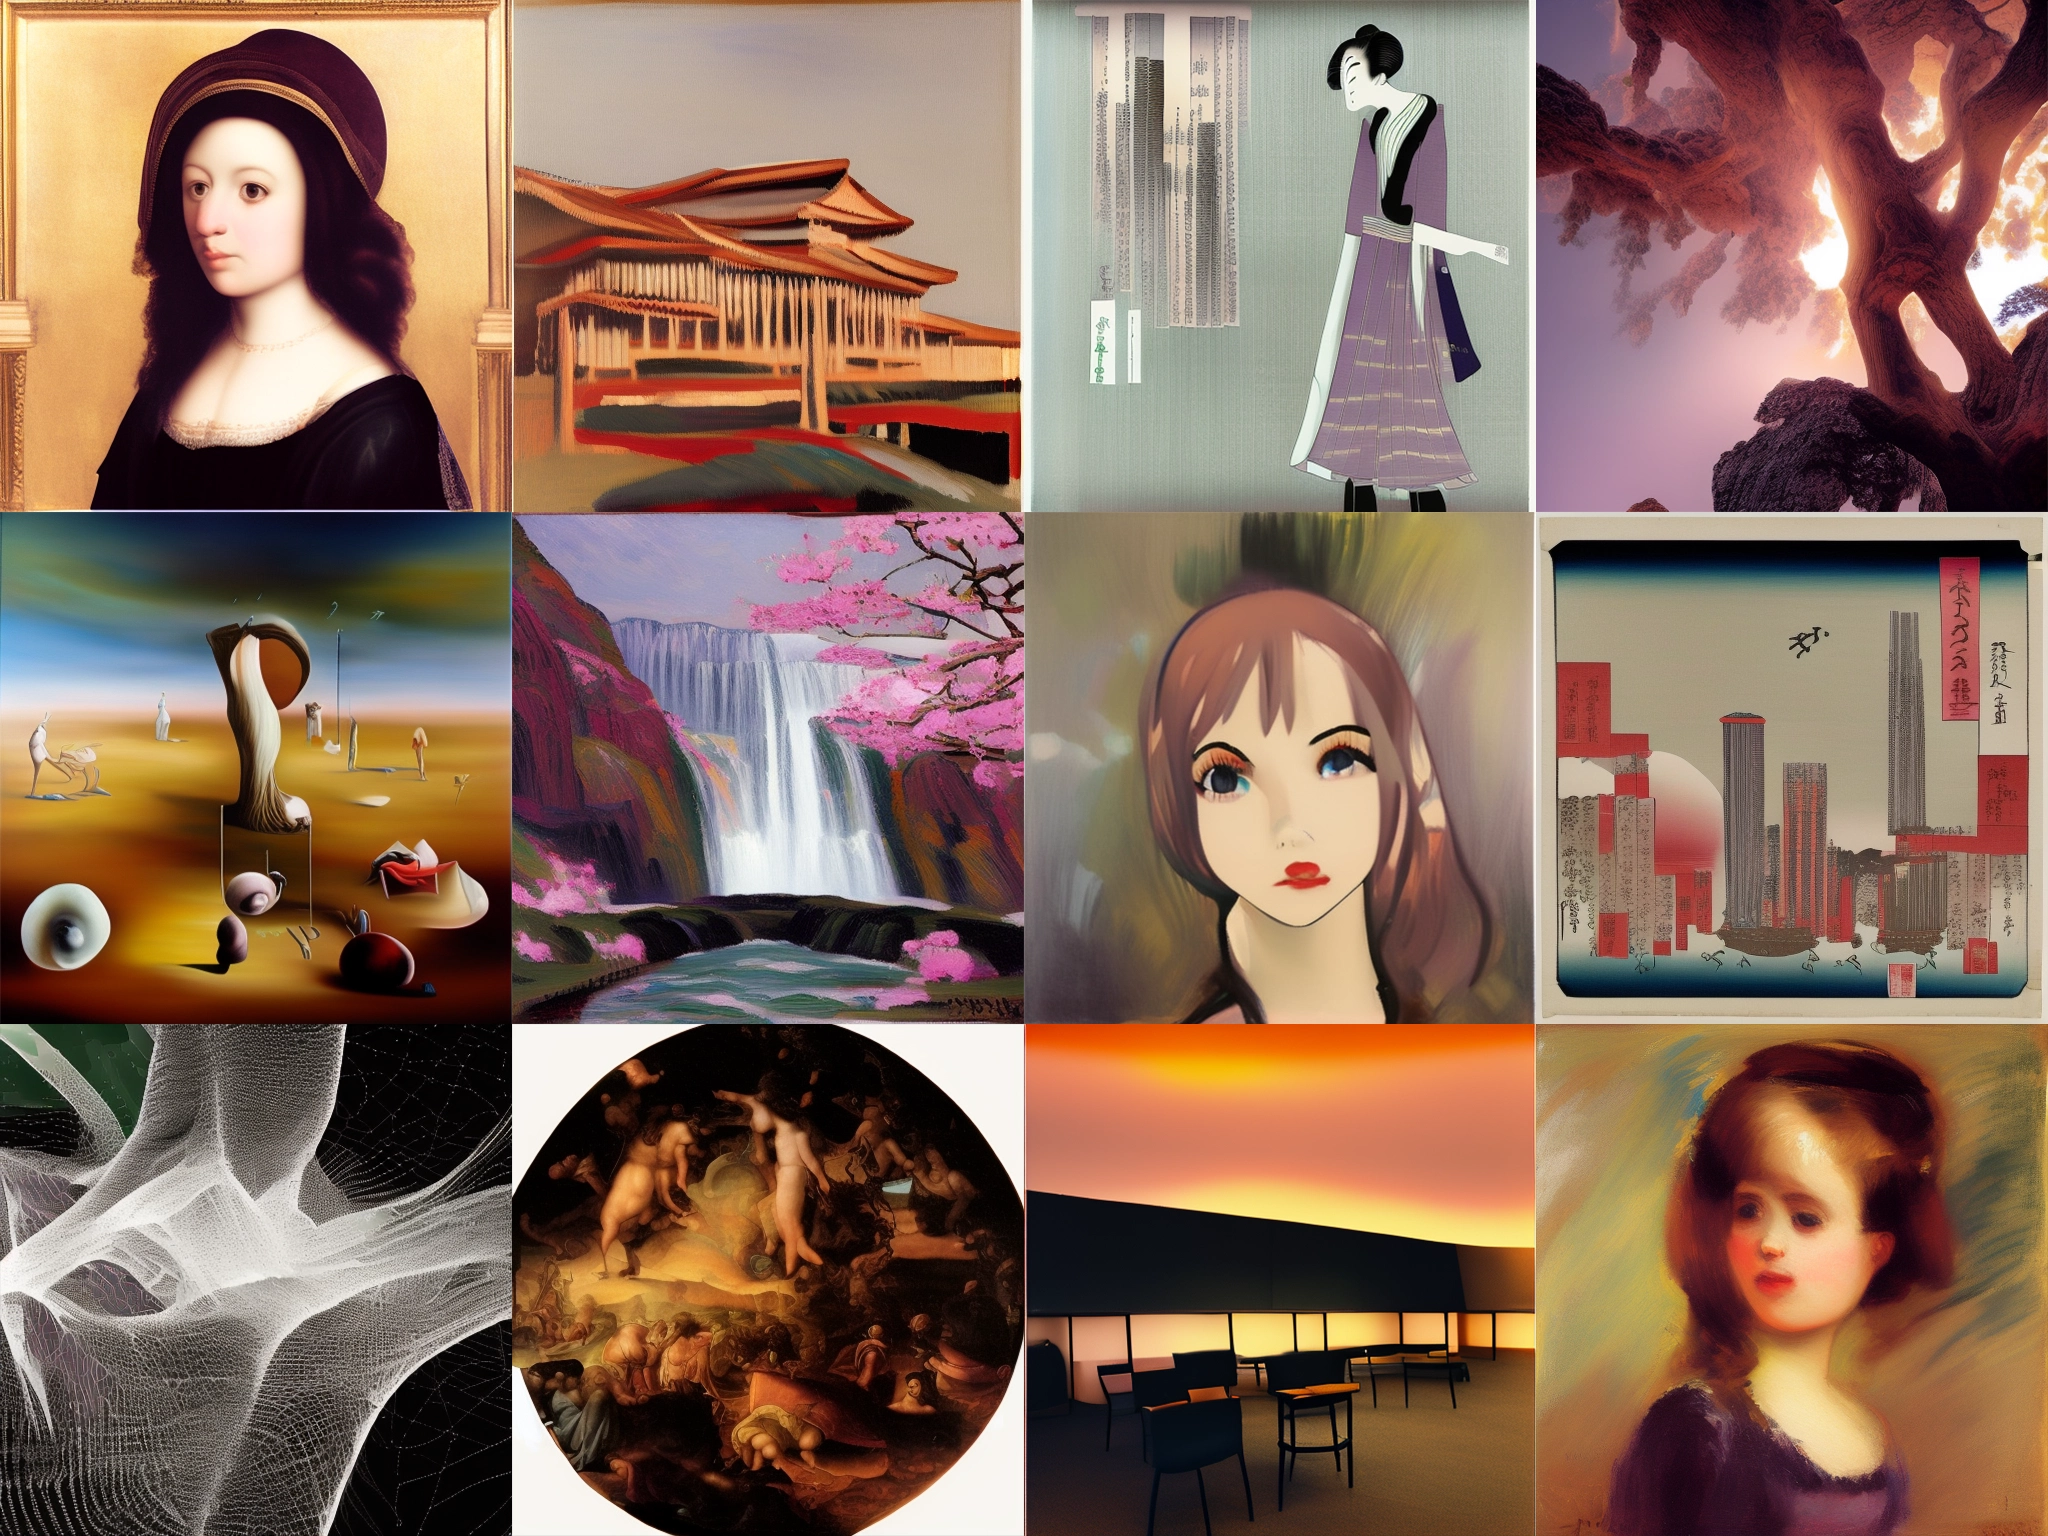
You can check here to all prompts to generate these images.
Training Data Sources
All data was obtained ethically and in compliance with the site's terms and conditions. No copyright images are used in the training of this model without the permission. No AI generated images are in the dataset.
- Traditional Artwork in public domain / CC0
- MET Museum Open Access
- Smithsonian Open Access
- Cleveland Museum of Art Open Access
- National Gallery of Art Open Access
- ArtBench-10 (public domain subset)
- CC0 Photos
- Flickr, Wikimedia Commons
- CC0 NFTs *1
- goblintown.nft, mfer, tubby-cats, Timeless
- CC0 VRM models
- made by VRoid Project, pastelkies, yomox9 (all CC0 subset)
- We generated a bunch of synthesized images dataset rendered with various poses and camera angles.
- Copyright images with permission for use
- Generative and Visual Artworks made by Rhizomatiks
Approx 11M images in total with data augmentation.
- Their work is released under a CC0 license, but if you are considering using this model to create a work inspired by their NFT and sell it as NFT, please consider paying them a royalty to help the CC0 NFT community grow.
License
Creative Open-Rail++-M License
❗❗ “Mitsua Diffusion CC0” means most of the training data is CC0. the model license itself is NOT CC0.❗❗
This model is open access and available to all, with a CreativeML OpenRAIL++-M license further specifying rights and usage. The CreativeML OpenRAIL++-M License specifies:
- You can't use the model to deliberately produce nor share illegal or harmful outputs or content
- The authors claims no rights on the outputs you generate, you are free to use them and are accountable for their use which must not go against the provisions set in the license
- You may re-distribute the weights and use the model commercially and/or as a service. If you do, please be aware you have to include the same use restrictions as the ones in the license and share a copy of the CreativeML OpenRAIL++-M to all your users (please read the license entirely and carefully) Please read the full license here
Developed by
- Stable Diffusion 2.1: Robin Rombach, Patrick Esser
- Mitsua Diffusion CC0 : Abstract Engine dev team