Mitsua Diffusion One Model Card
Mitsua Diffusion One is a latent text-to-image diffusion model, which is a successor of Mitsua Diffusion CC0.
This model is trained from scratch using only public domain/CC0 or copyright images with permission for use, with using a fixed pretrained text encoder (OpenCLIP ViT-H/14, MIT License).
This will be used as a base model for AI VTuber Elan Mitsua🖌️’s activity.
❗❗ Currently, the model is still of low quality and lacks diversity ❗❗
Further training will be done fully opt-in basis.
If you are interested in, please click here to submit an opt-in application.
We are active on a Discord server for opt-in contributors only. Communication is currently in Japanese.
❗❗ To train this model, images from opt-in contributors have not yet been used ❗❗
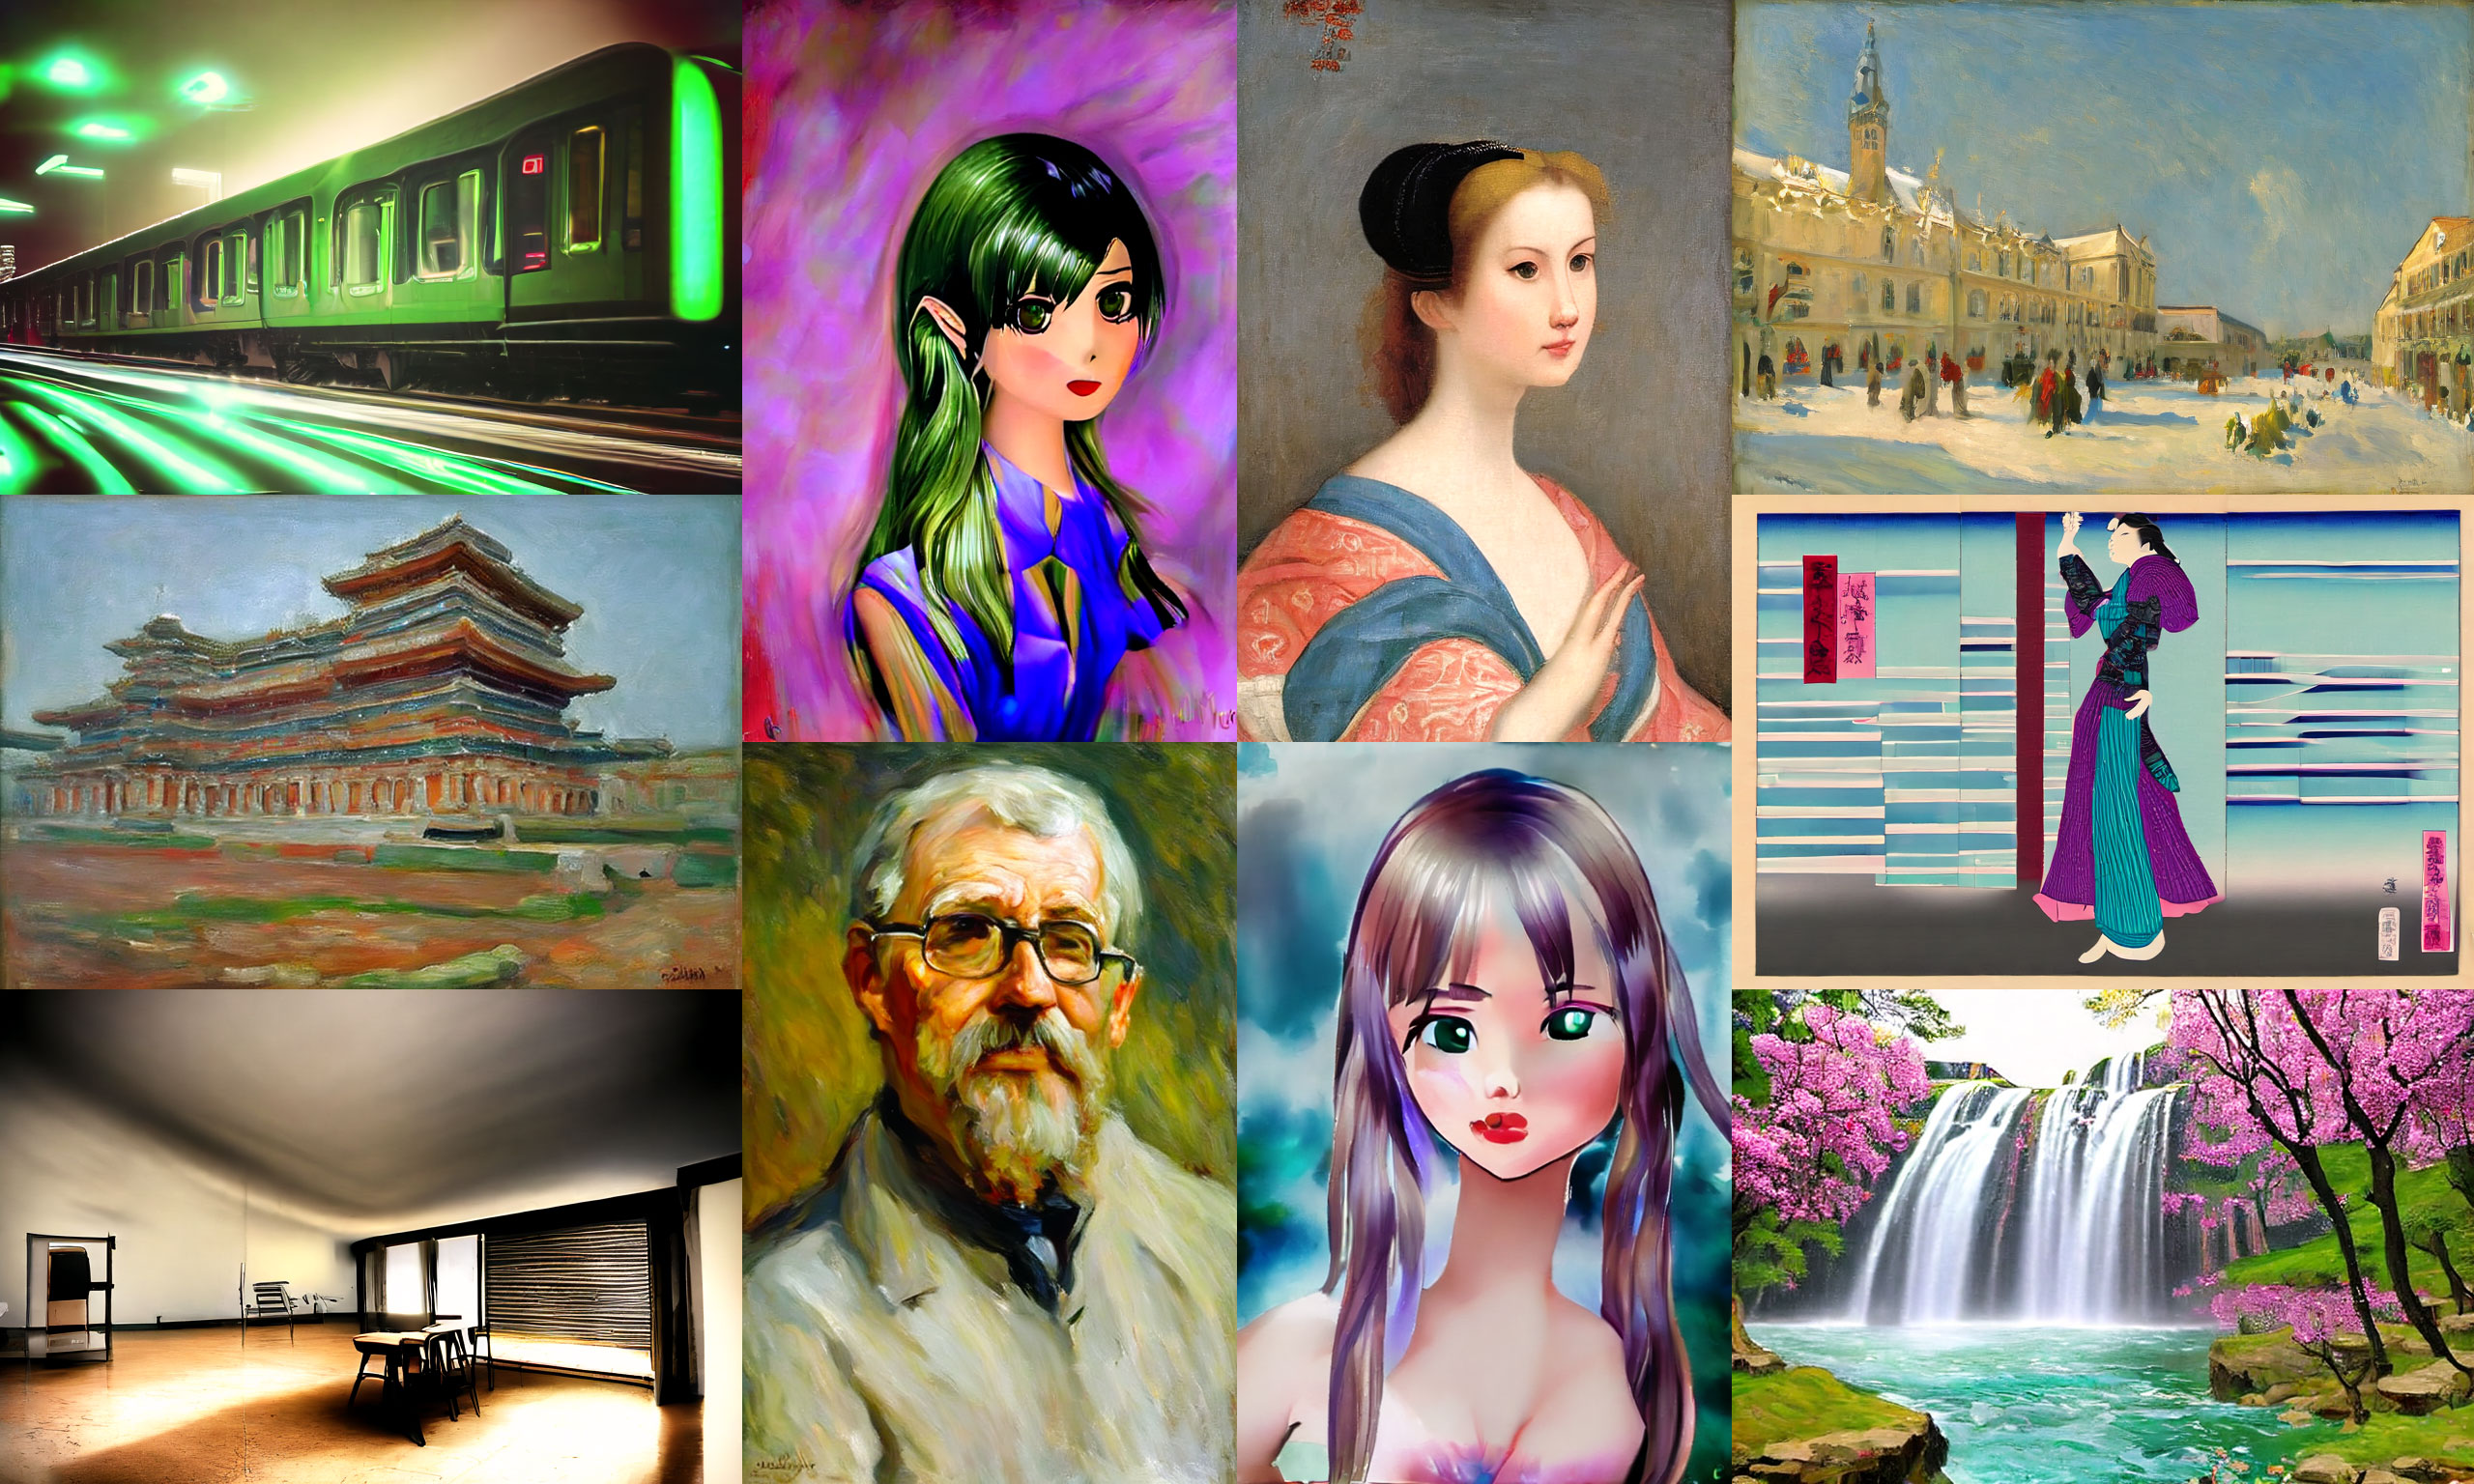
You can check here to all prompts to generate these images.
License
- Mitsua Open RAIL-M License (More restrictive variant of CreativeML Open RAIL-M)
This model is open access and available to all, with a Mitsua Open RAIL-M license further specifying rights and usage. The Mitsua Open RAIL-M License specifies:
- You can't use the model to deliberately produce nor share illegal or harmful outputs or content
- The authors claims no rights on the outputs you generate, you are free to use them and are accountable for their use which must not go against the provisions set in the license
- You can't use the model to infringe any rights of other by feeding image sources or model weights to the model (e.g. using another person's copyrighted image for fine-tuning without permission, using another person's copyrighted image as a source for image2image without permission).
- You can't misrepresent that a generated image as not AI-generated.
- You may re-distribute the weights and use the model commercially and/or as a service. If you do, please be aware you have to include the same use restrictions as the ones in the license and share a copy of the Mitsua Open RAIL-M to all your users (please read the license entirely and carefully) Please read the full license here
Training Data Sources
All data was obtained ethically and in compliance with the site's terms and conditions. No copyright images are used in the training of this model without the permission. No AI generated images are in the dataset.
- The Metropolitan Museum of Art Open Access (CC0 / Public domain)
- Smithsonian Museum Open Access (CC0 / Public domain)
- Cleveland Museum of Art Open Access (CC0 / Public domain)
- National Gallery of Art Open Access (CC0 / Public domain)
- The Art Institute of Chicago Open Access (CC0 / Public domain)
- The Walters Art Museum Open Access (CC0 / Public domain)
- J. Paul Getty Museum Open Access (CC0 / Public domain)
- ArtBench-10 (public domain subset)
- Flickr (CC0 subset)
- Wikimedia Commons (CC0 subset)
- NFT arts *1 (goblintown.nft, mfer, tubby-cats, Timeless) (CC0)
- Full version of VRoid Image Dataset (CC0 or licensed)
- Open Clipart (Public domain)
- Open Duelyst (CC0)
- 3dicons (CC0)
- ambientCG (CC0)
- Wuffle comics made by Piti Yindee (CC0)
- 大崎一番太郎 made by 大崎駅西口商店会 (CC0)
- Traditional Generative Art (Non-AI) and Visual Artworks made by Rhizomatiks (licensed)
Approx 11M images in total with data augmentation.
- Their work is released under a CC0 license, but if you are considering using this model to create a work inspired by their NFT and sell it as NFT, please consider paying them a royalty to help the CC0 NFT community grow.
Training Notes
- Trained resolution : 256x256 --> 512x512 --> (512x512, 640x448, 448x640) --> (512x512, 768x512, 512x768)
- diffusers version and
mitsua-diffusion-one.ckptare fine-tuned with Diffusion With Offset Noise technique which is applied to last 12k steps withp=0.02. mitsua-diffusion-one-base.ckptis non-fine-tuned version. For fine-tuning stuff, this version would be better choice.
Cosine similarity (as a proof of full-scratch training)
- VAE
- 0.16694325 (vs Stable Diffusion v2.1 base)
- 0.20887965 (vs Stable Diffusion v.1.4)
- All fine-tuned variant would have over 0.90
- U-Net
- 0.07097270 (vs Stable Diffusion v2.1 base)
- 0.08351029 (vs Stable Diffusion v.1.4)
- All fine-tuned variant would have over 0.99
Developed by
- Latent Diffusion Models (for algorithm and training scripts, MIT License) : Robin Rombach, Andreas Blattmann, Dominik Lorenz, Patrick Esser and Björn Ommer
- OpenCLIP : Ilharco Gabriel, Wortsman Mitchell, Wightman Ross, Gordon Cade, Carlini Nicholas, Taori Rohan, Dave Achal, Shankar Vaishaal, Namkoong Hongseok, Miller John, Hajishirzi Hannaneh, Farhadi Ali, Schmidt Ludwig
- Mitsua Diffusion One : Abstract Engine
- Special Thanks to Mitsua Contributors