/ Модель

Характеристики

Контекст
512 токенов
Параметры
162 млн
Лицензия
Apache 2.0
Архитектура
bert · dense
Базовая модель
GATE-AraBert-v1
Библиотека
transformers
Опубликована
25 окт 2024

GATE-Reranker-V1

Классификация текстаТекст → label6 профессий

Арабский BERT-реранкер, который оценивает релевантность документов запросу и помогает улучшить поиск, рекомендации и извлечение материалов для RAG.

484скачиваний за 30 дней11лайковвеса обновлены3 апр 2025

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

GATE-Reranker-V1 — модель-реранкер от NAMAA-space для ранжирования арабских документов по релевантности запросу. Она дообучена на базе Omartificial-Intelligence-Space/GATE-AraBert-v1 и использует архитектуру BERT с классификатором последовательностей; размер модели — 162,4 млн параметров. Модель оценивает пары «запрос — документ» и выдаёт оценки релевантности, которые можно использовать для сортировки результатов поиска.

Модель предназначена для повышения качества арабского поиска, ранжирования документов в системах рекомендаций и отбора материалов для ответов на вопросы и RAG. README приводит пример работы через SentenceTransformers CrossEncoder. Максимальная длина контекста — 512 токенов. Модель рассчитана на арабский язык; лицензия — Apache-2.0.

Оценка в карточке проводится на двух наборах данных с метриками MAP, MRR и NDCG@10, однако сравнения и дополнительные результаты обозначены как находящиеся в разработке. Поэтому качество на других наборах данных и в прикладных сценариях может отличаться.

Сценарии применения

  • переранжирование результатов поиска по арабским запросам
  • отбор релевантных арабских документов для RAG
  • улучшение поиска материалов для ответов на арабском языке
  • ранжирование арабских публикаций для рекомендательной системы

Ограничения

Контекст ограничен 512 токенами. Карточка описывает оценку на двух наборах данных, но дополнительные сравнения и результаты ещё в разработке; качество на других данных не установлено.

Для каких профессий подходит6

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Также подходит для

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

GATE-Reranker-V1 🚀✨

NAMAA-space releases GATE-Reranker-V1, a high-performance model fine-tuned to elevate Arabic document retrieval and ranking to new heights! 📚🇸🇦

This model is designed to improve search relevance of arabic documents by accurately ranking documents based on their contextual fit for a given query.

Key Features 🔑

  • Optimized for Arabic: Built on the highly performant Omartificial-Intelligence-Space/GATE-AraBert-v1 with exclusivly rich Arabic data.
  • Advanced Document Ranking: Ranks results with precision, perfect for search engines, recommendation systems, and question-answering applications.
  • State-of-the-Art Performance: Achieves excellent performance compared to famous rerankers(See Evaluation), ensuring reliable relevance and precision.

Example Use Cases 💼

  • Retrieval Augmented Generation: Improve search result relevance for Arabic content.
  • Content Recommendation: Deliver top-tier Arabic content suggestions.
  • Question Answering: Boost answer retrieval quality in Arabic-focused systems.

Usage

Within sentence-transformers

The usage becomes easier when you have SentenceTransformers installed. Then, you can use the pre-trained models like this:

from sentence_transformers import CrossEncoder
model = CrossEncoder('NAMAA-Space/GATE-Reranker-V1', max_length=512)

Query = 'كيف يمكن استخدام التعلم العميق في معالجة الصور الطبية؟'
Paragraph1 = 'التعلم العميق يساعد في تحليل الصور الطبية وتشخيص الأمراض'
Paragraph2 = 'الذكاء الاصطناعي يستخدم في تحسين الإنتاجية في الصناعات'

scores = model.predict([(Query, Paragraph1), (Query, Paragraph2)])

Evaluation

We evaluate our model on two different datasets using the metrics MAP, MRR and NDCG@10:

The purpose of this evaluation is to highlight the performance of our model with regards to: Relevant/Irrelevant labels and positive/multiple negatives documents:

Dataset 1: NAMAA-Space/Ar-Reranking-Eval
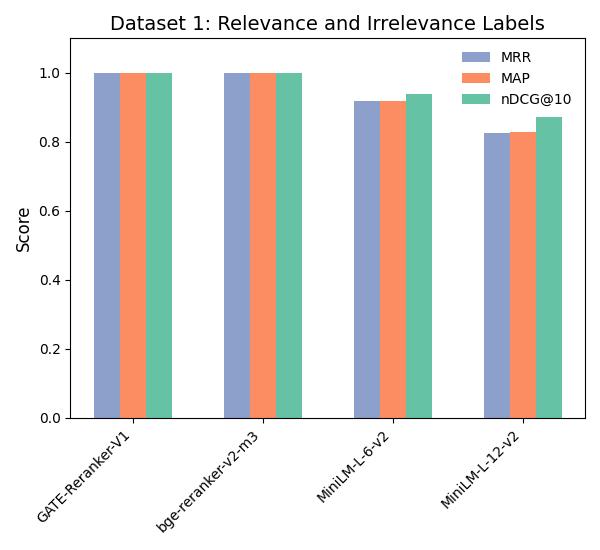
Plot

Dataset 2: NAMAA-Space/Arabic-Reranking-Triplet-5-Eval
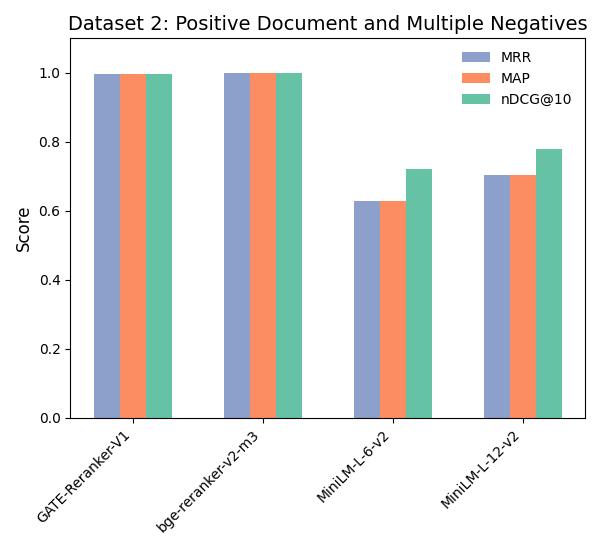
Plot

As seen, The model performs extremly well in comparison to other famous rerankers.

WIP: More comparisons and evaluation on arabic datasets.

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм · transformers · text-classification

Можно запустить

Подбираем GPU…

Класс архитектуры
BertForSequenceClassification
Ревизия весов
664ebca

0 моделей