/ Модель

Характеристики

Лицензия
CreativeML OpenRAIL-M
Опубликована
2 дек 2022

sd2-cartoon-blip

Генерация изображенийТекст → изображение3 профессии

Дообученная на мультяшных изображениях модель Stable Diffusion 2.0 для создания картинок по текстовым запросам в мультяшном стиле.

66скачиваний за 30 дней19лайковвеса обновлены8 июл 2025

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Тесты пользователейпока нет

Никто ещё не опубликовал тест этой модели. Соберите бенчмарк из своих задач — результат появится здесь.

  1. Добавьте модель в бенчмарк

    Вместе с другими моделями категории «Изображения» — сравнение идёт внутри одной категории.

  2. Опишите свои задачи

    Напишите запросы, при необходимости приложите файлы и эталонные ответы.

  3. Запустите и опубликуйте

    Модели сгенерируют результат по каждой задаче. Опубликованный тест появится на этой странице.

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

Norod78/sd2-cartoon-blip — модель генерации изображений на основе Stable Diffusion 2.0, дообученная автором Norod78 на изображениях из различных мультсериалов. Она принимает текстовый запрос и создаёт изображения в мультяшной стилистике. Обучение длилось 25 000 итераций на изображениях с подписями BLIP из набора Norod78/cartoon-blip-captions; модель использует StableDiffusionPipeline и доступна в форматах Diffusers, PyTorch и safetensors. Также в репозитории есть файлы checkpoint и YAML для использования с AUTOMATIC1111.

Модель предназначена для генерации мультяшных изображений по текстовым описаниям. Она основана на stabilityai/stable-diffusion-2-base и распространяется по лицензии CreativeML OpenRAIL-M. Карточка не приводит сведений о размере модели или длине контекста.

Сценарии применения

  • создание мультяшной иллюстрации по текстовому описанию
  • генерация изображений персонажей мультсериалов
  • создание сцен в мультяшной стилистике
  • подготовка концепт-арта для мультфильма

Ограничения

Обучение ориентировано на мультяшные изображения и может хуже подходить для генерации реалистичных изображений. Качество и разнообразие результата зависят от текстового запроса.

Для каких профессий подходит3

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

Cartoon diffusion v2.0

*Stable Diffusion v2.0 fine tuned on images from various cartoon shows

If you want more details on how to generate your own blip cpationed dataset see this colab

Training was done using a slightly modified version of Hugging-Face's text to image training example script

About

Put in a text prompt and generate cartoony images

AUTOMATIC1111 webui checkpoint

The main folder contains a .ckpt and a .yaml file to be put in stable-diffusion-webui "stable-diffusion-webui/models/Stable-diffusion" folder and used to generate images

Sample code

from diffusers import StableDiffusionPipeline, LMSDiscreteScheduler
import torch

# this will substitute the default PNDM scheduler for K-LMS  
lms = LMSDiscreteScheduler(
    beta_start=0.00085, 
    beta_end=0.012, 
    beta_schedule="scaled_linear"
)

guidance_scale=8.5
steps=50

cartoon_model_path = "Norod78/sd2-cartoon-blip"
cartoon_pipe = StableDiffusionPipeline.from_pretrained(cartoon_model_path, scheduler=lms, torch_dtype=torch.float16)
cartoon_pipe.to("cuda")

def generate(prompt, file_prefix ,samples, seed=42):
    torch.manual_seed(seed)
    prompt += ", Very detailed, clean, high quality, sharp image"
    cartoon_images = cartoon_pipe([prompt] * samples, num_inference_steps=steps, guidance_scale=guidance_scale)["images"]
    for idx, image in enumerate(cartoon_images):
        image.save(f"{file_prefix}-{idx}-{seed}-sd2-cartoon-blip.jpg")

generate("An oil on canvas portrait of Snoop Dogg, Mark Ryden", "01_SnoopDog", 2, 777)
generate("A flemish baroque painting of Kermit from the muppet show", "02_KermitFlemishBaroque", 2, 42)
generate("Gal Gadot in Avatar", "03_GalGadotAvatar", 2, 777)
generate("Ninja turtles, Naoto Hattori", "04_TMNT", 2, 312)
generate("An anime town", "05_AnimeTown", 2, 777)
generate("Family guy taking selfies at the beach", "06_FamilyGuy", 2, 555)
generate("Pikachu as Rick and morty, Eric Wallis", "07_PikachuRnM", 2, 777)
generate("Pikachu as Spongebob, Eric Wallis", "08_PikachuSpongeBob", 2, 42)
generate("An oil painting of Miss. Piggy from the muppets as the Mona Lisa", "09_MsPiggyMonaLisa", 2, 42)
generate("Rick Sanchez in star wars, Dave Dorman", "10_RickStarWars", 2, 42)
generate("An paiting of Southpark with rainbow", "11_Southpark", 2, 777)
generate("An oil painting of Phineas and Pherb hamering on a new machine, Eric Wallis", "12_PhineasPherb", 2, 777)
generate("Bender, Saturno Butto", "13_Bender", 2, 777)
generate("A psychedelic image of Bojack Horseman", "14_Bojack", 2, 777)
generate("A movie poster for Gravity Falls Cthulhu stories", "15_GravityFalls", 2, 777)
generate("A vibrant oil painting portrait of She-Ra", "16_Shira", 2, 512)
#
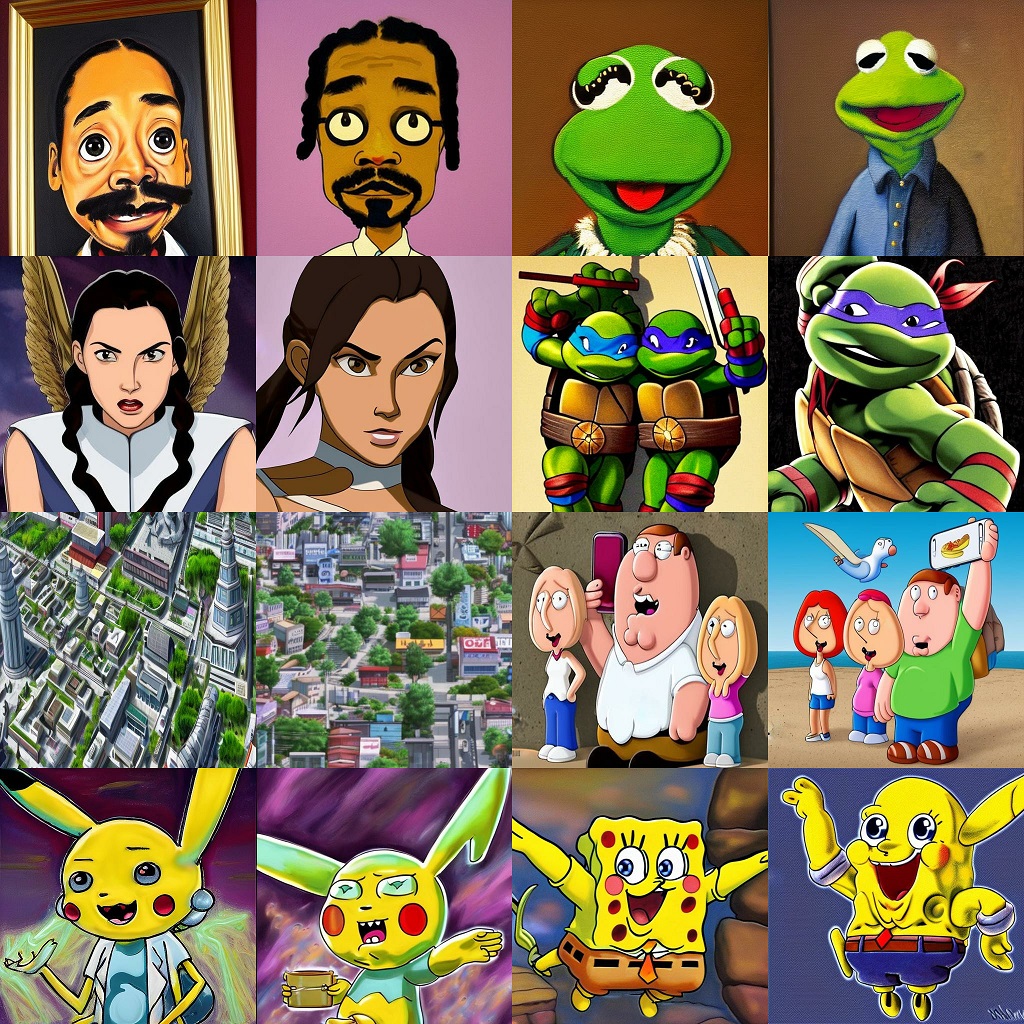
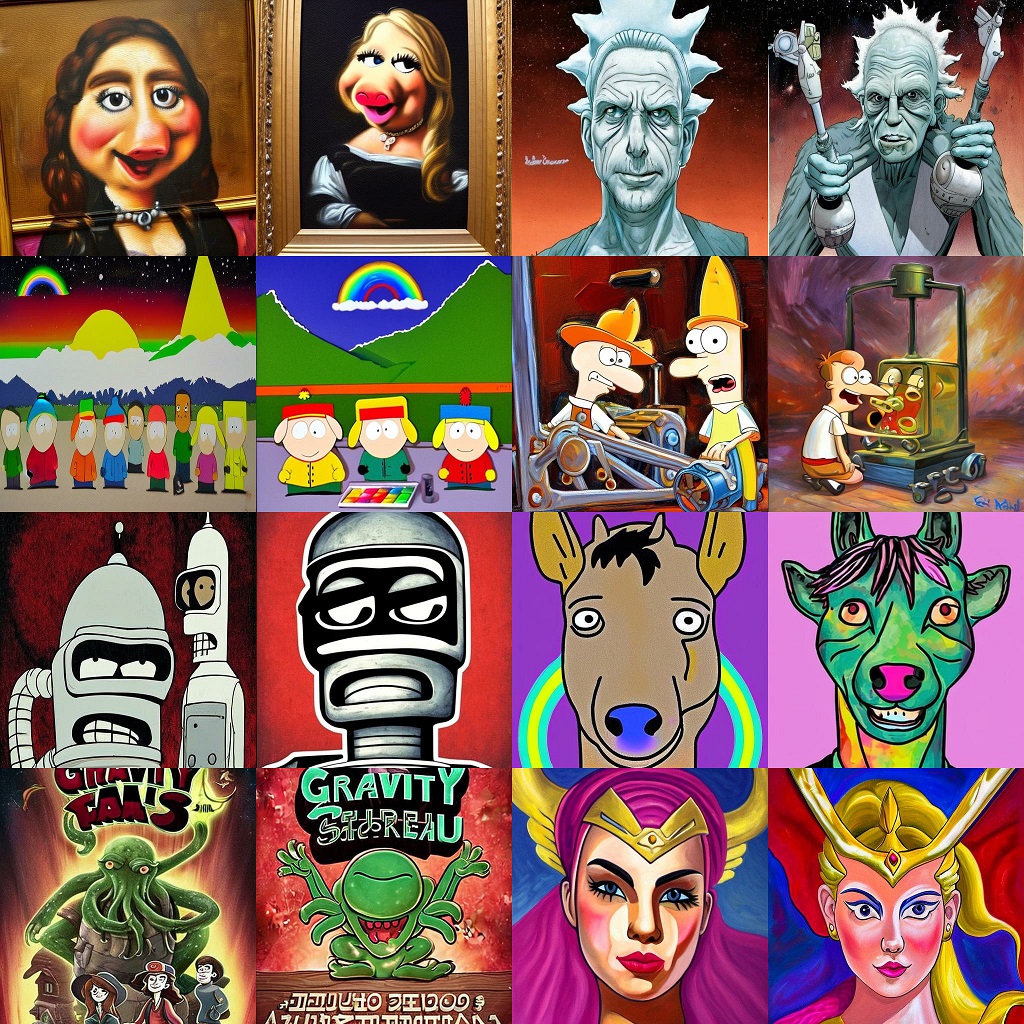
Images generated by this sample code Images generated by this sample code

Dataset and Training

Finetuned for 25,000 iterations upon stabilityai/stable-diffusion-2-base on BLIP captioned cartoon images using 1xA5000 GPU on my home desktop computer

Trained by @Norod78

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм

Можно запустить

Подбираем GPU…

Ревизия весов
9068c99

0 моделей