/ Модель

Характеристики

Лицензия
CreativeML OpenRAIL-M
Опубликована
7 дек 2022

sd2-dreambooth-ClaymationXmas

Генерация изображенийТекст → изображение3 профессии

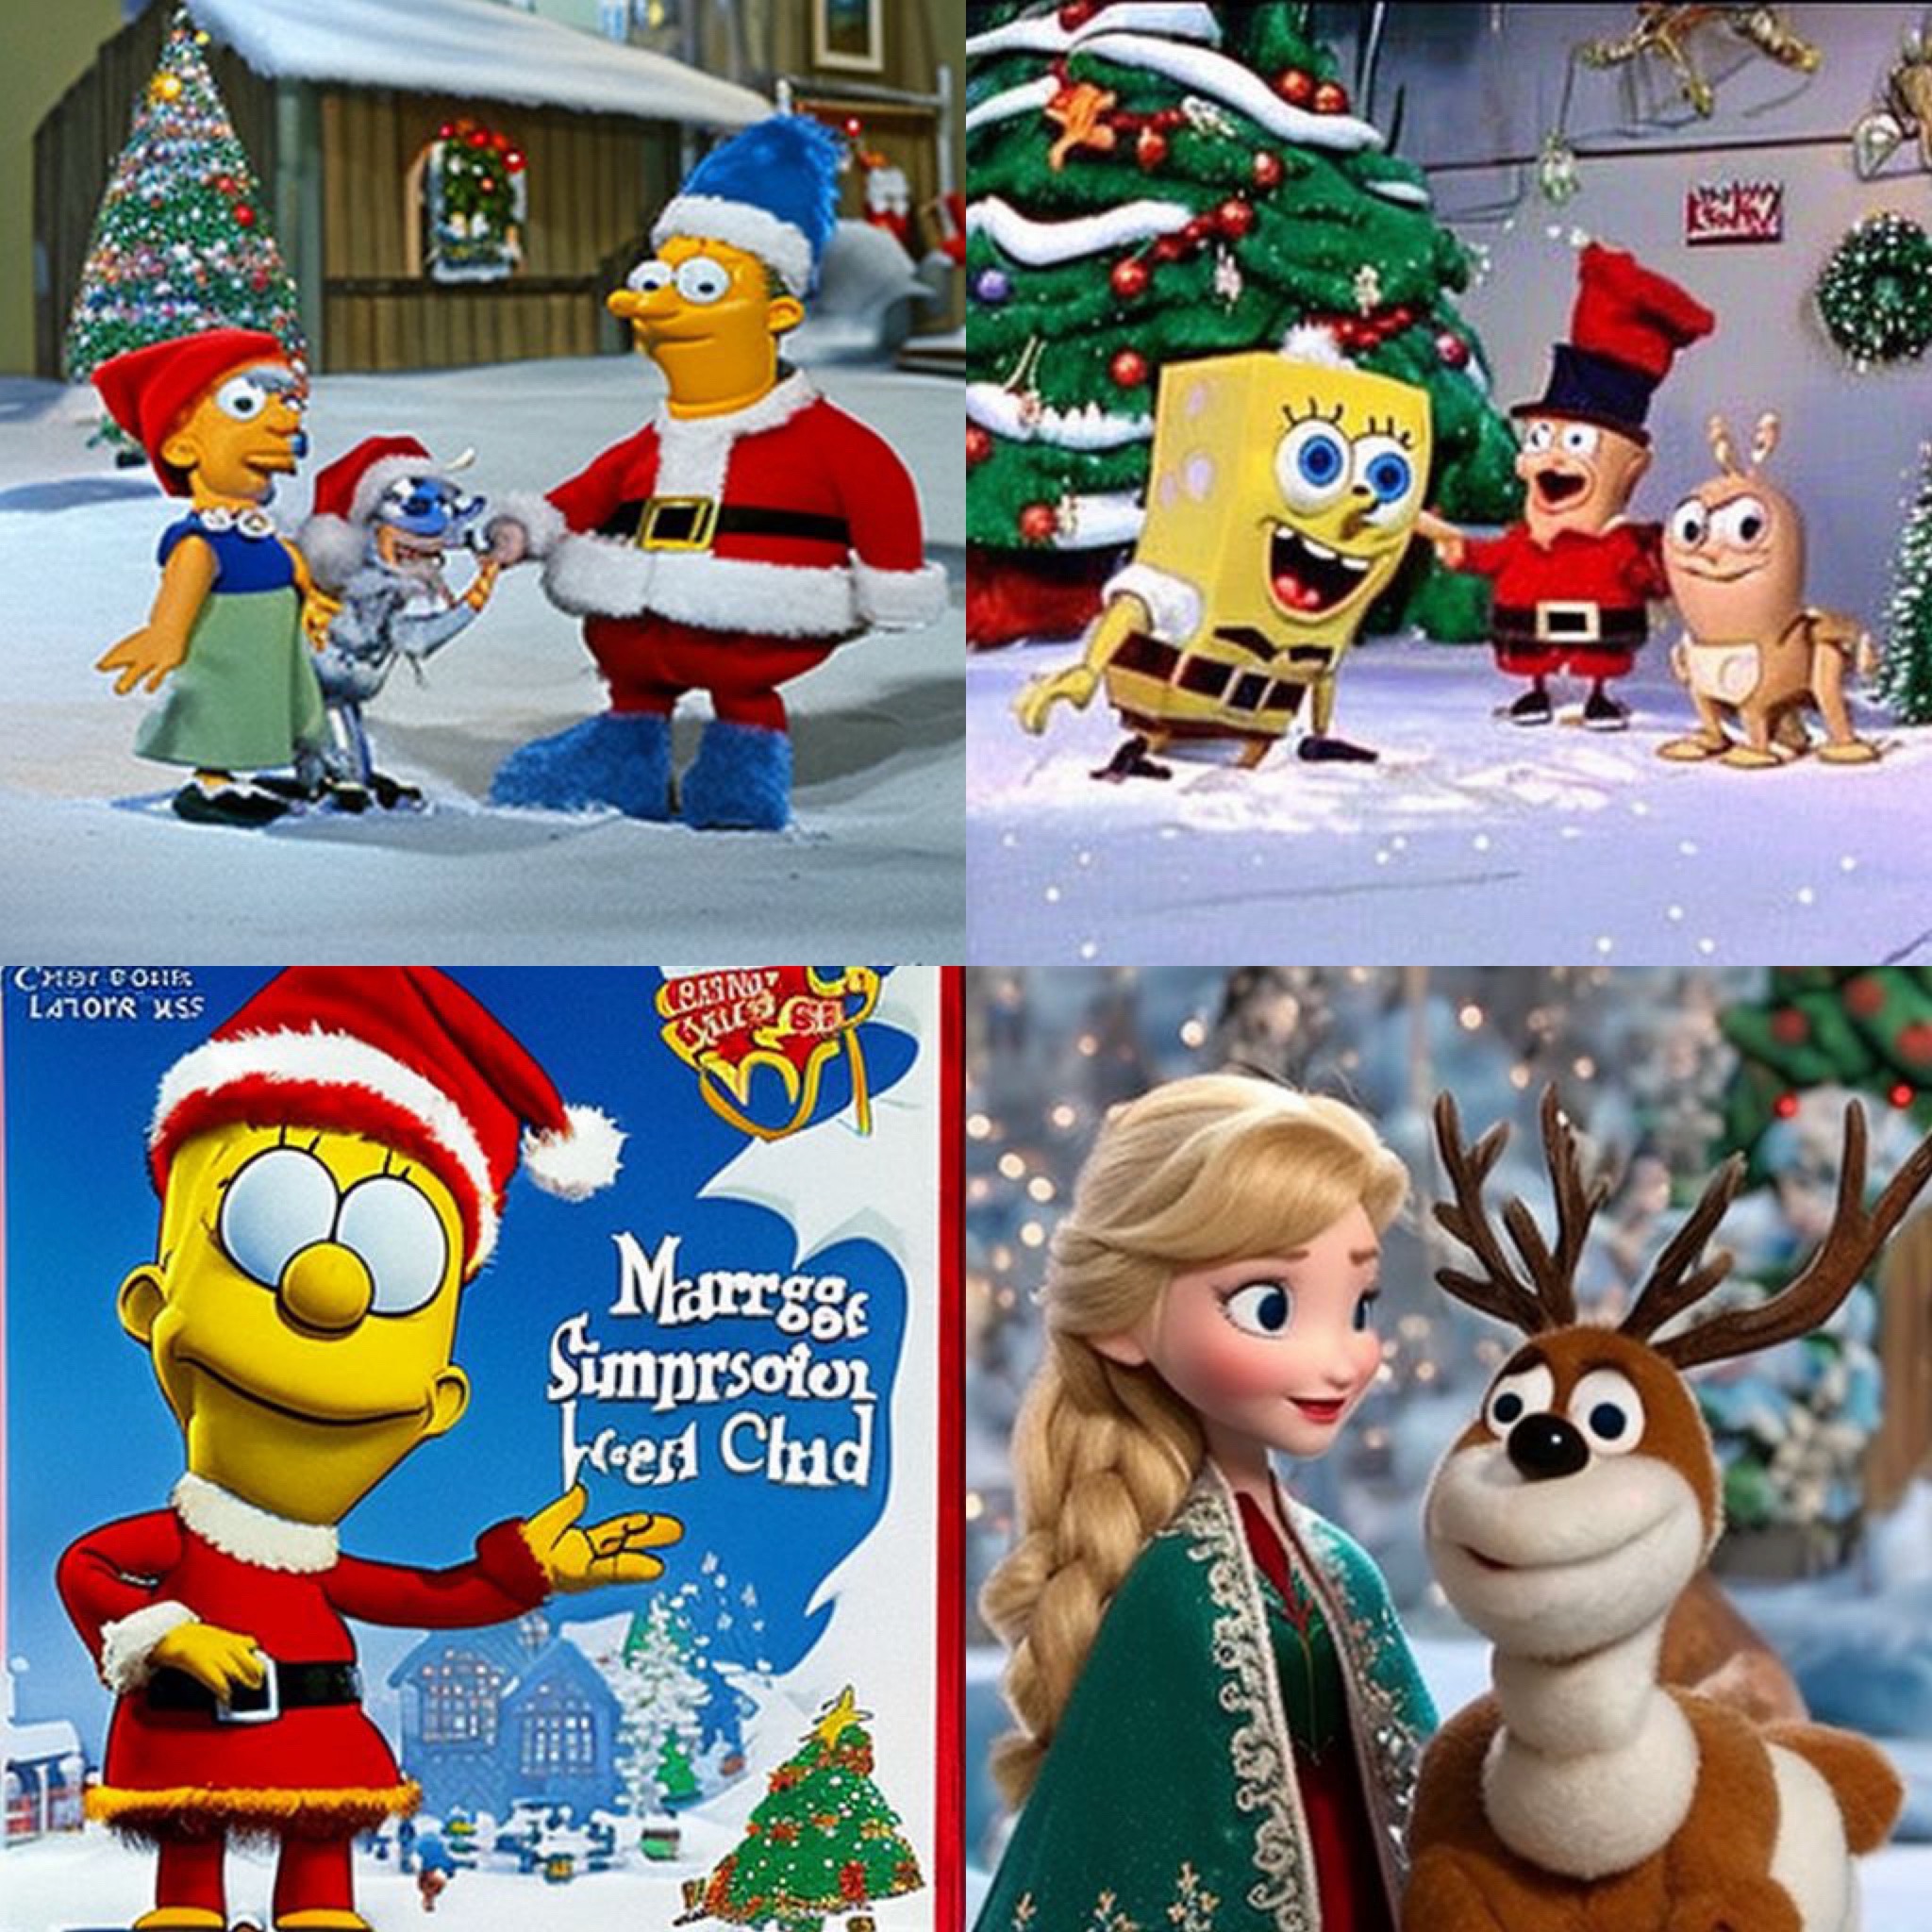
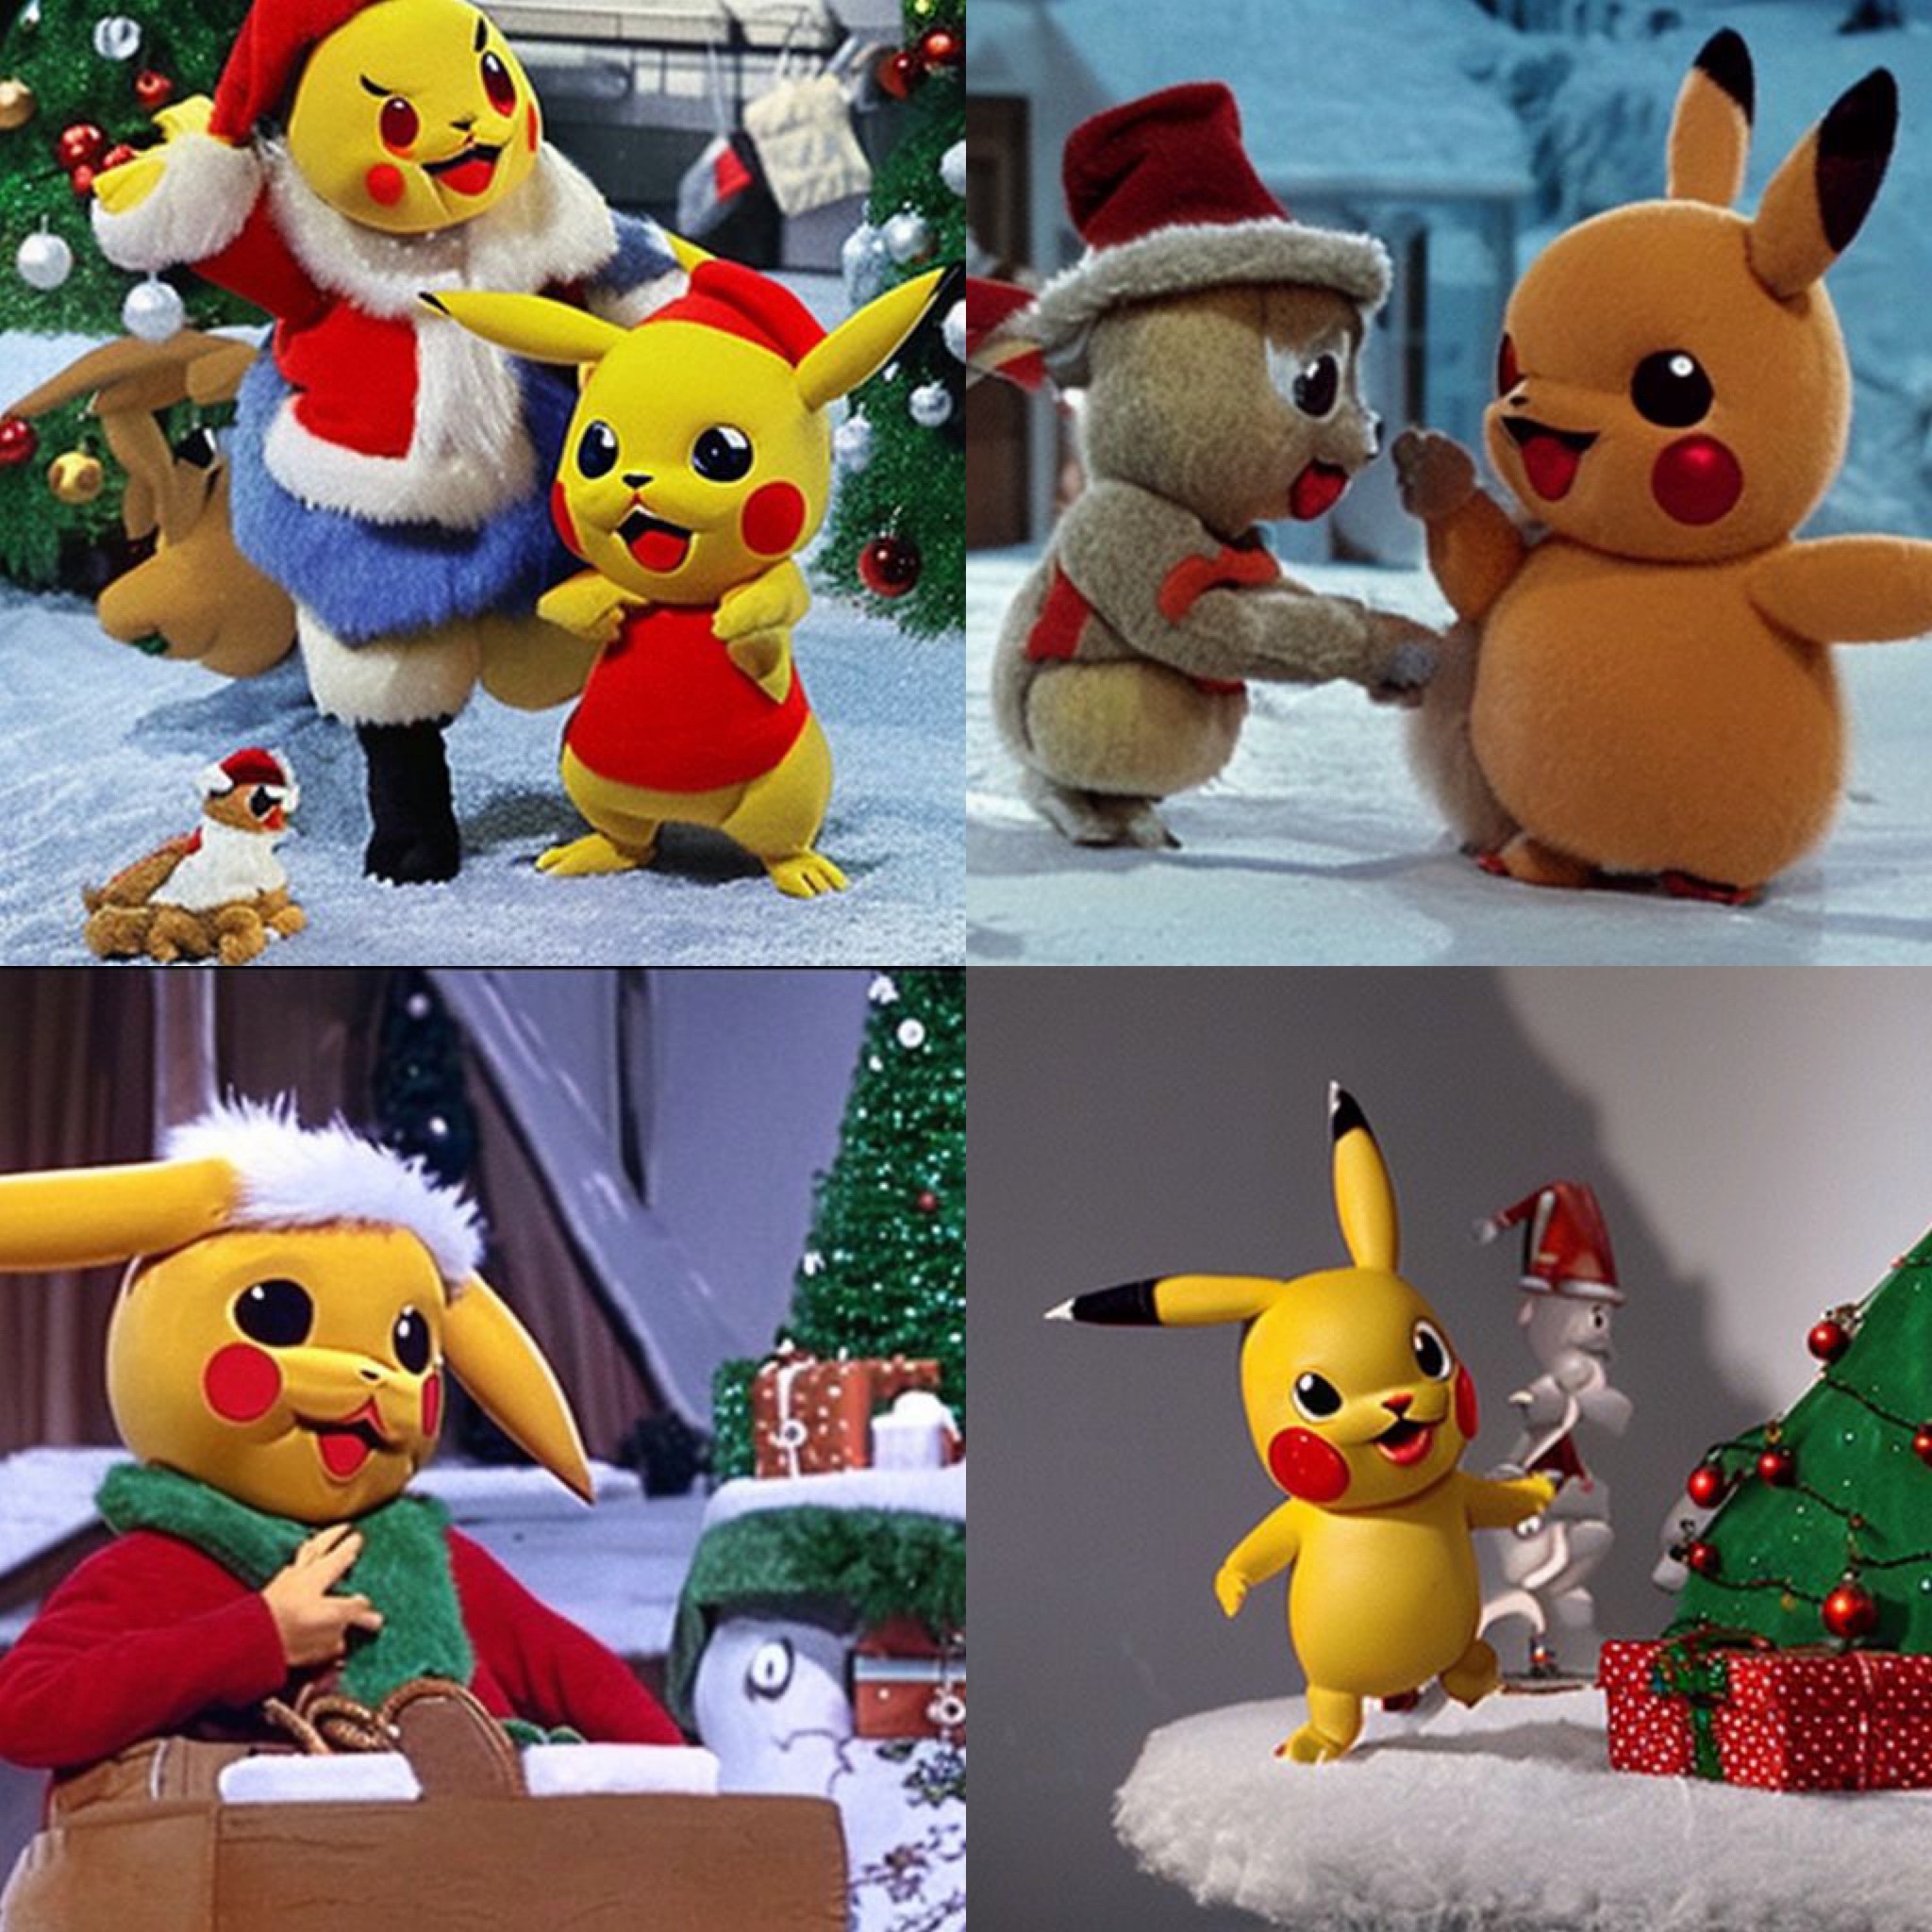
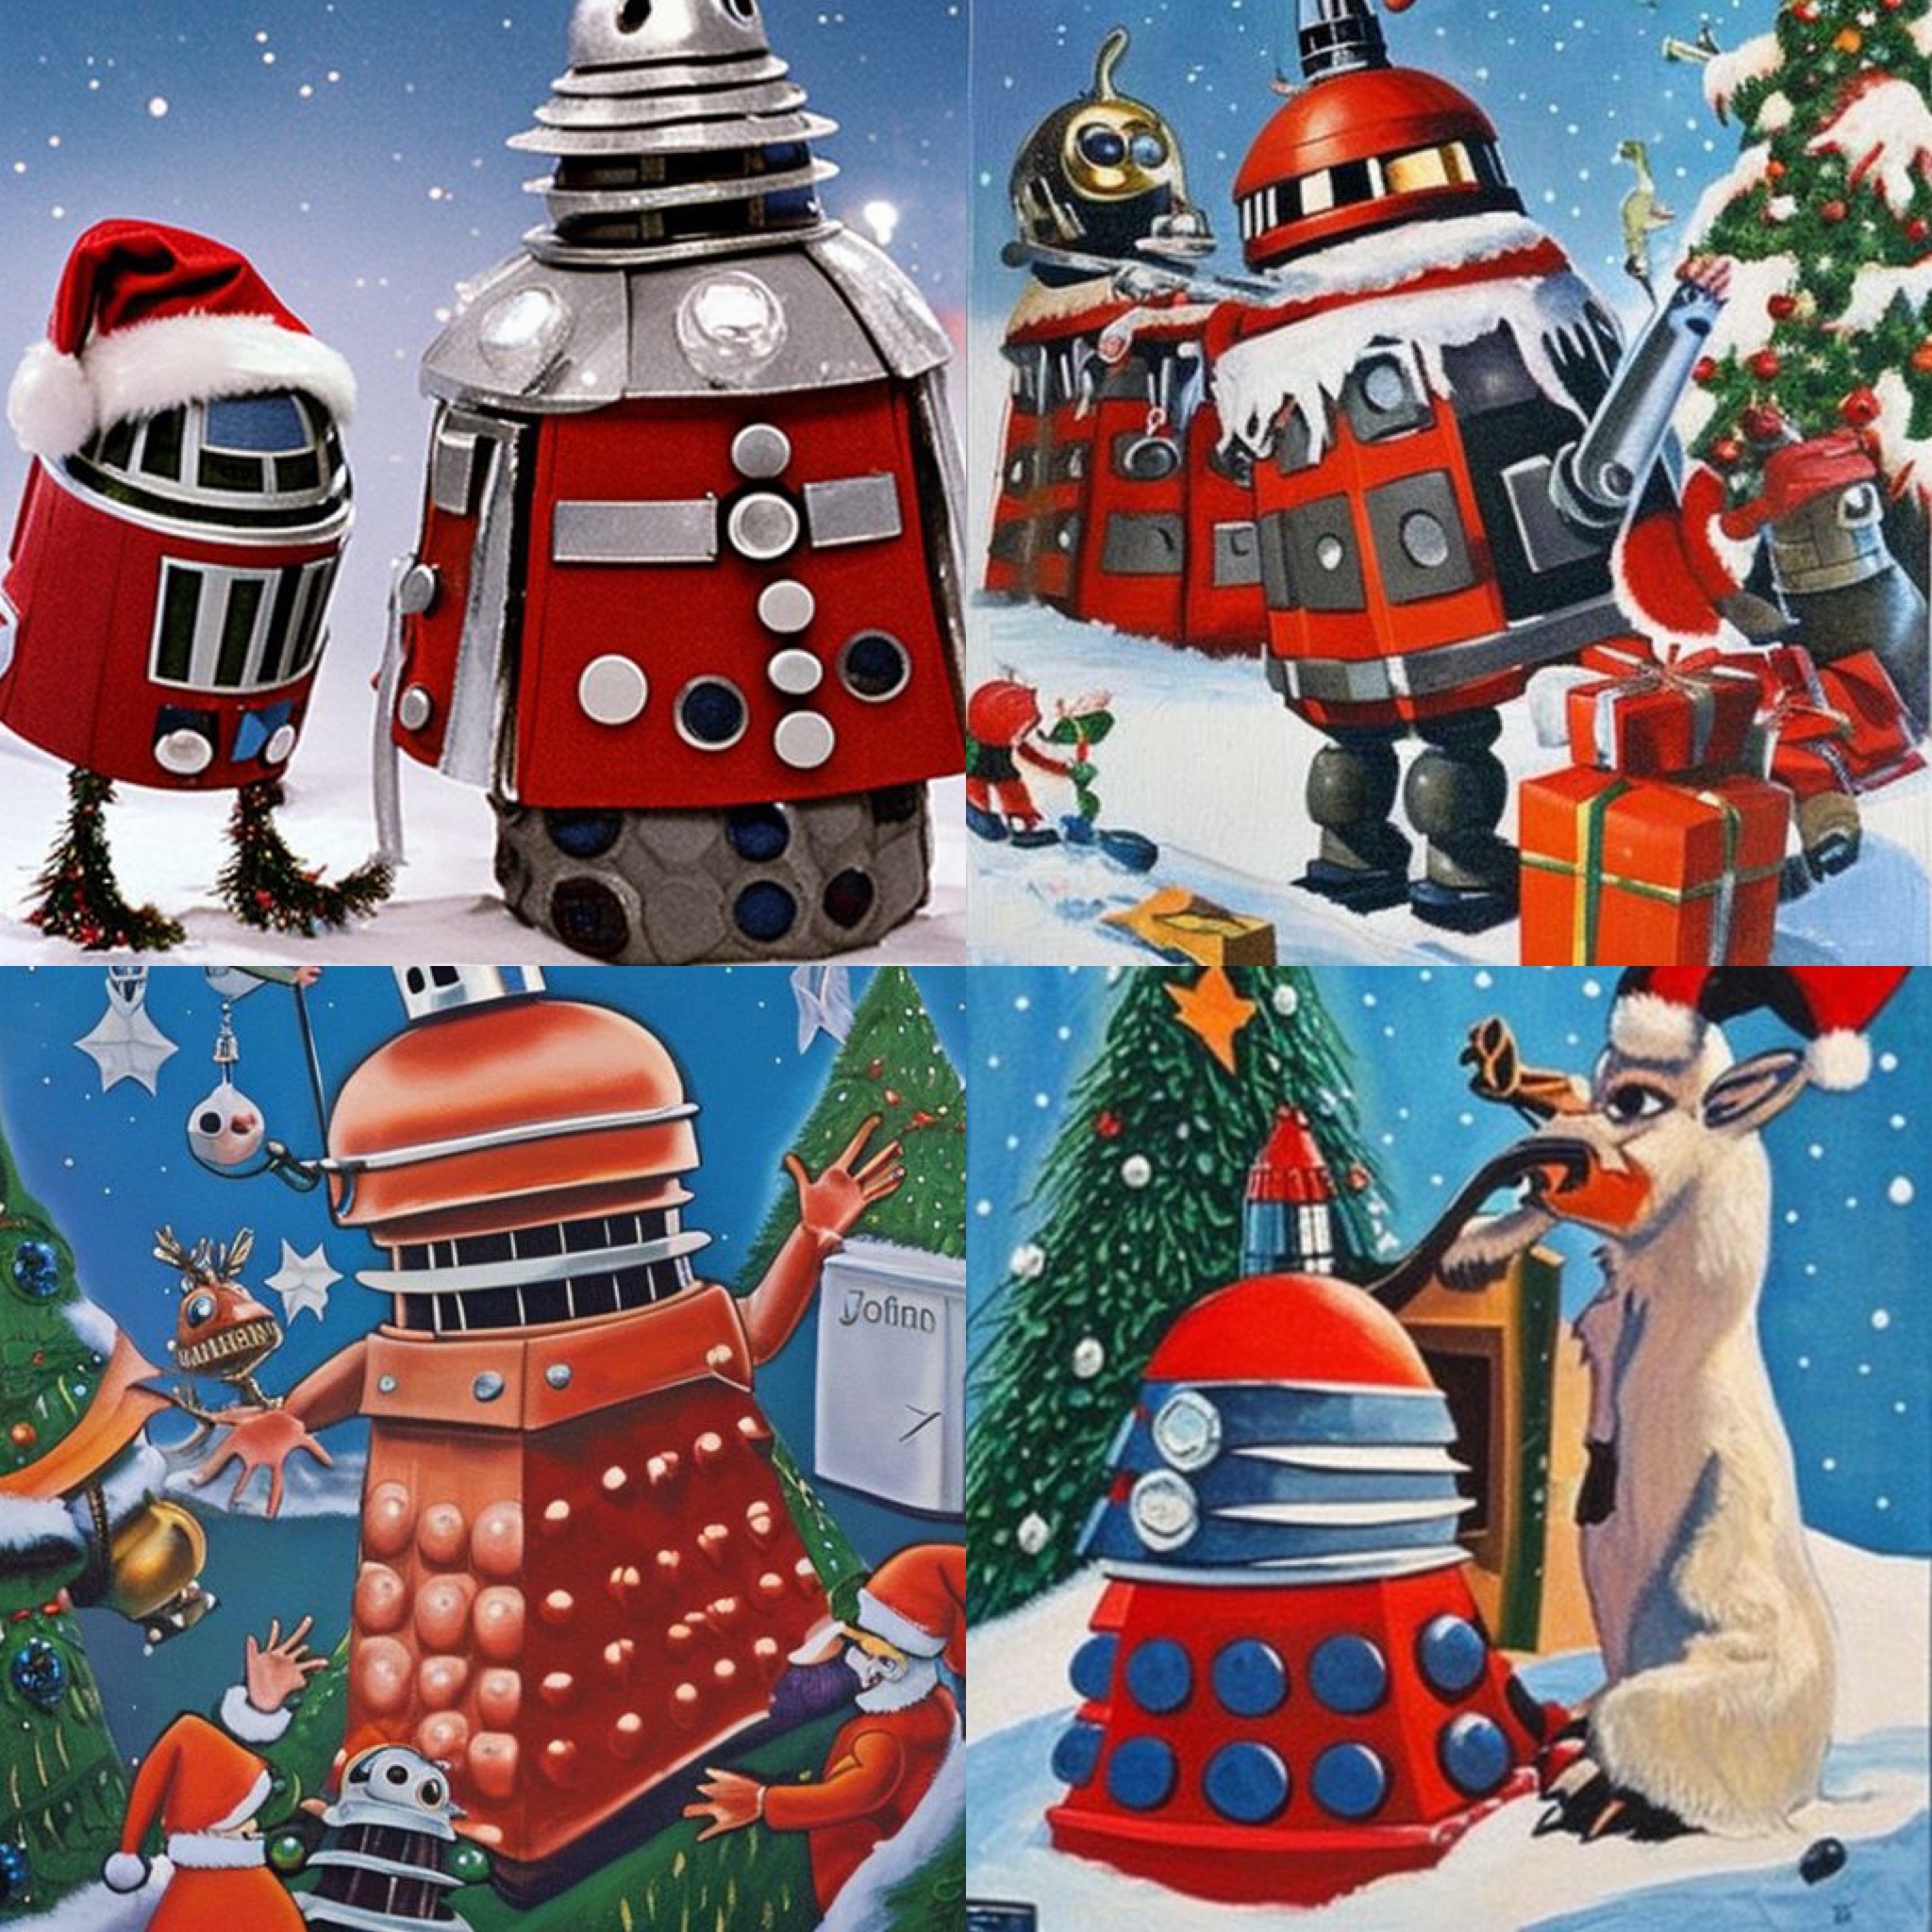
Дообученная модель Stable Diffusion для генерации изображений по текстовым запросам в стиле рождественской пластилиновой анимации.

65скачиваний за 30 дней10лайковвеса обновлены8 июл 2025

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Тесты пользователейпока нет

Никто ещё не опубликовал тест этой модели. Соберите бенчмарк из своих задач — результат появится здесь.

  1. Добавьте модель в бенчмарк

    Вместе с другими моделями категории «Изображения» — сравнение идёт внутри одной категории.

  2. Опишите свои задачи

    Напишите запросы, при необходимости приложите файлы и эталонные ответы.

  3. Запустите и опубликуйте

    Модели сгенерируют результат по каждой задаче. Опубликованный тест появится на этой странице.

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

Norod78/sd2-dreambooth-ClaymationXmas — модель преобразования текста в изображение, дообученная Norod78 для генерации изображений в стиле рождественской пластилиновой анимации. В карточке указано, что модель является fine-tune; примеры генерации представлены для WebUI AUTOMATIC1111. В репозитории используются Diffusers, PyTorch и safetensors.

Модель предназначена для создания изображений по текстовым запросам с рождественскими мотивами и эстетикой claymation. Она основана на Stable Diffusion, однако конкретная базовая версия и размер модели в доступных сведениях не указаны. Лицензия — CreativeML OpenRAIL-M.

Сценарии применения

  • создание рождественских иллюстраций в стиле пластилиновой анимации
  • генерация праздничных открыток по текстовому описанию
  • создание изображений персонажей и сцен из пластилина с зимней тематикой

Ограничения

Специализация на рождественской тематике и пластилиновой эстетике может ограничивать пригодность модели для других стилей. В карточке нет сведений о размере, контексте и количественной оценке качества.

Для каких профессий подходит3

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

sd2-dreambooth-ClaymationXmas

Use ClaymationXmas in your prompt

WebUI Examples

See examples folder for images generated with this model using a1111's WebUI

WebUI Example Collage
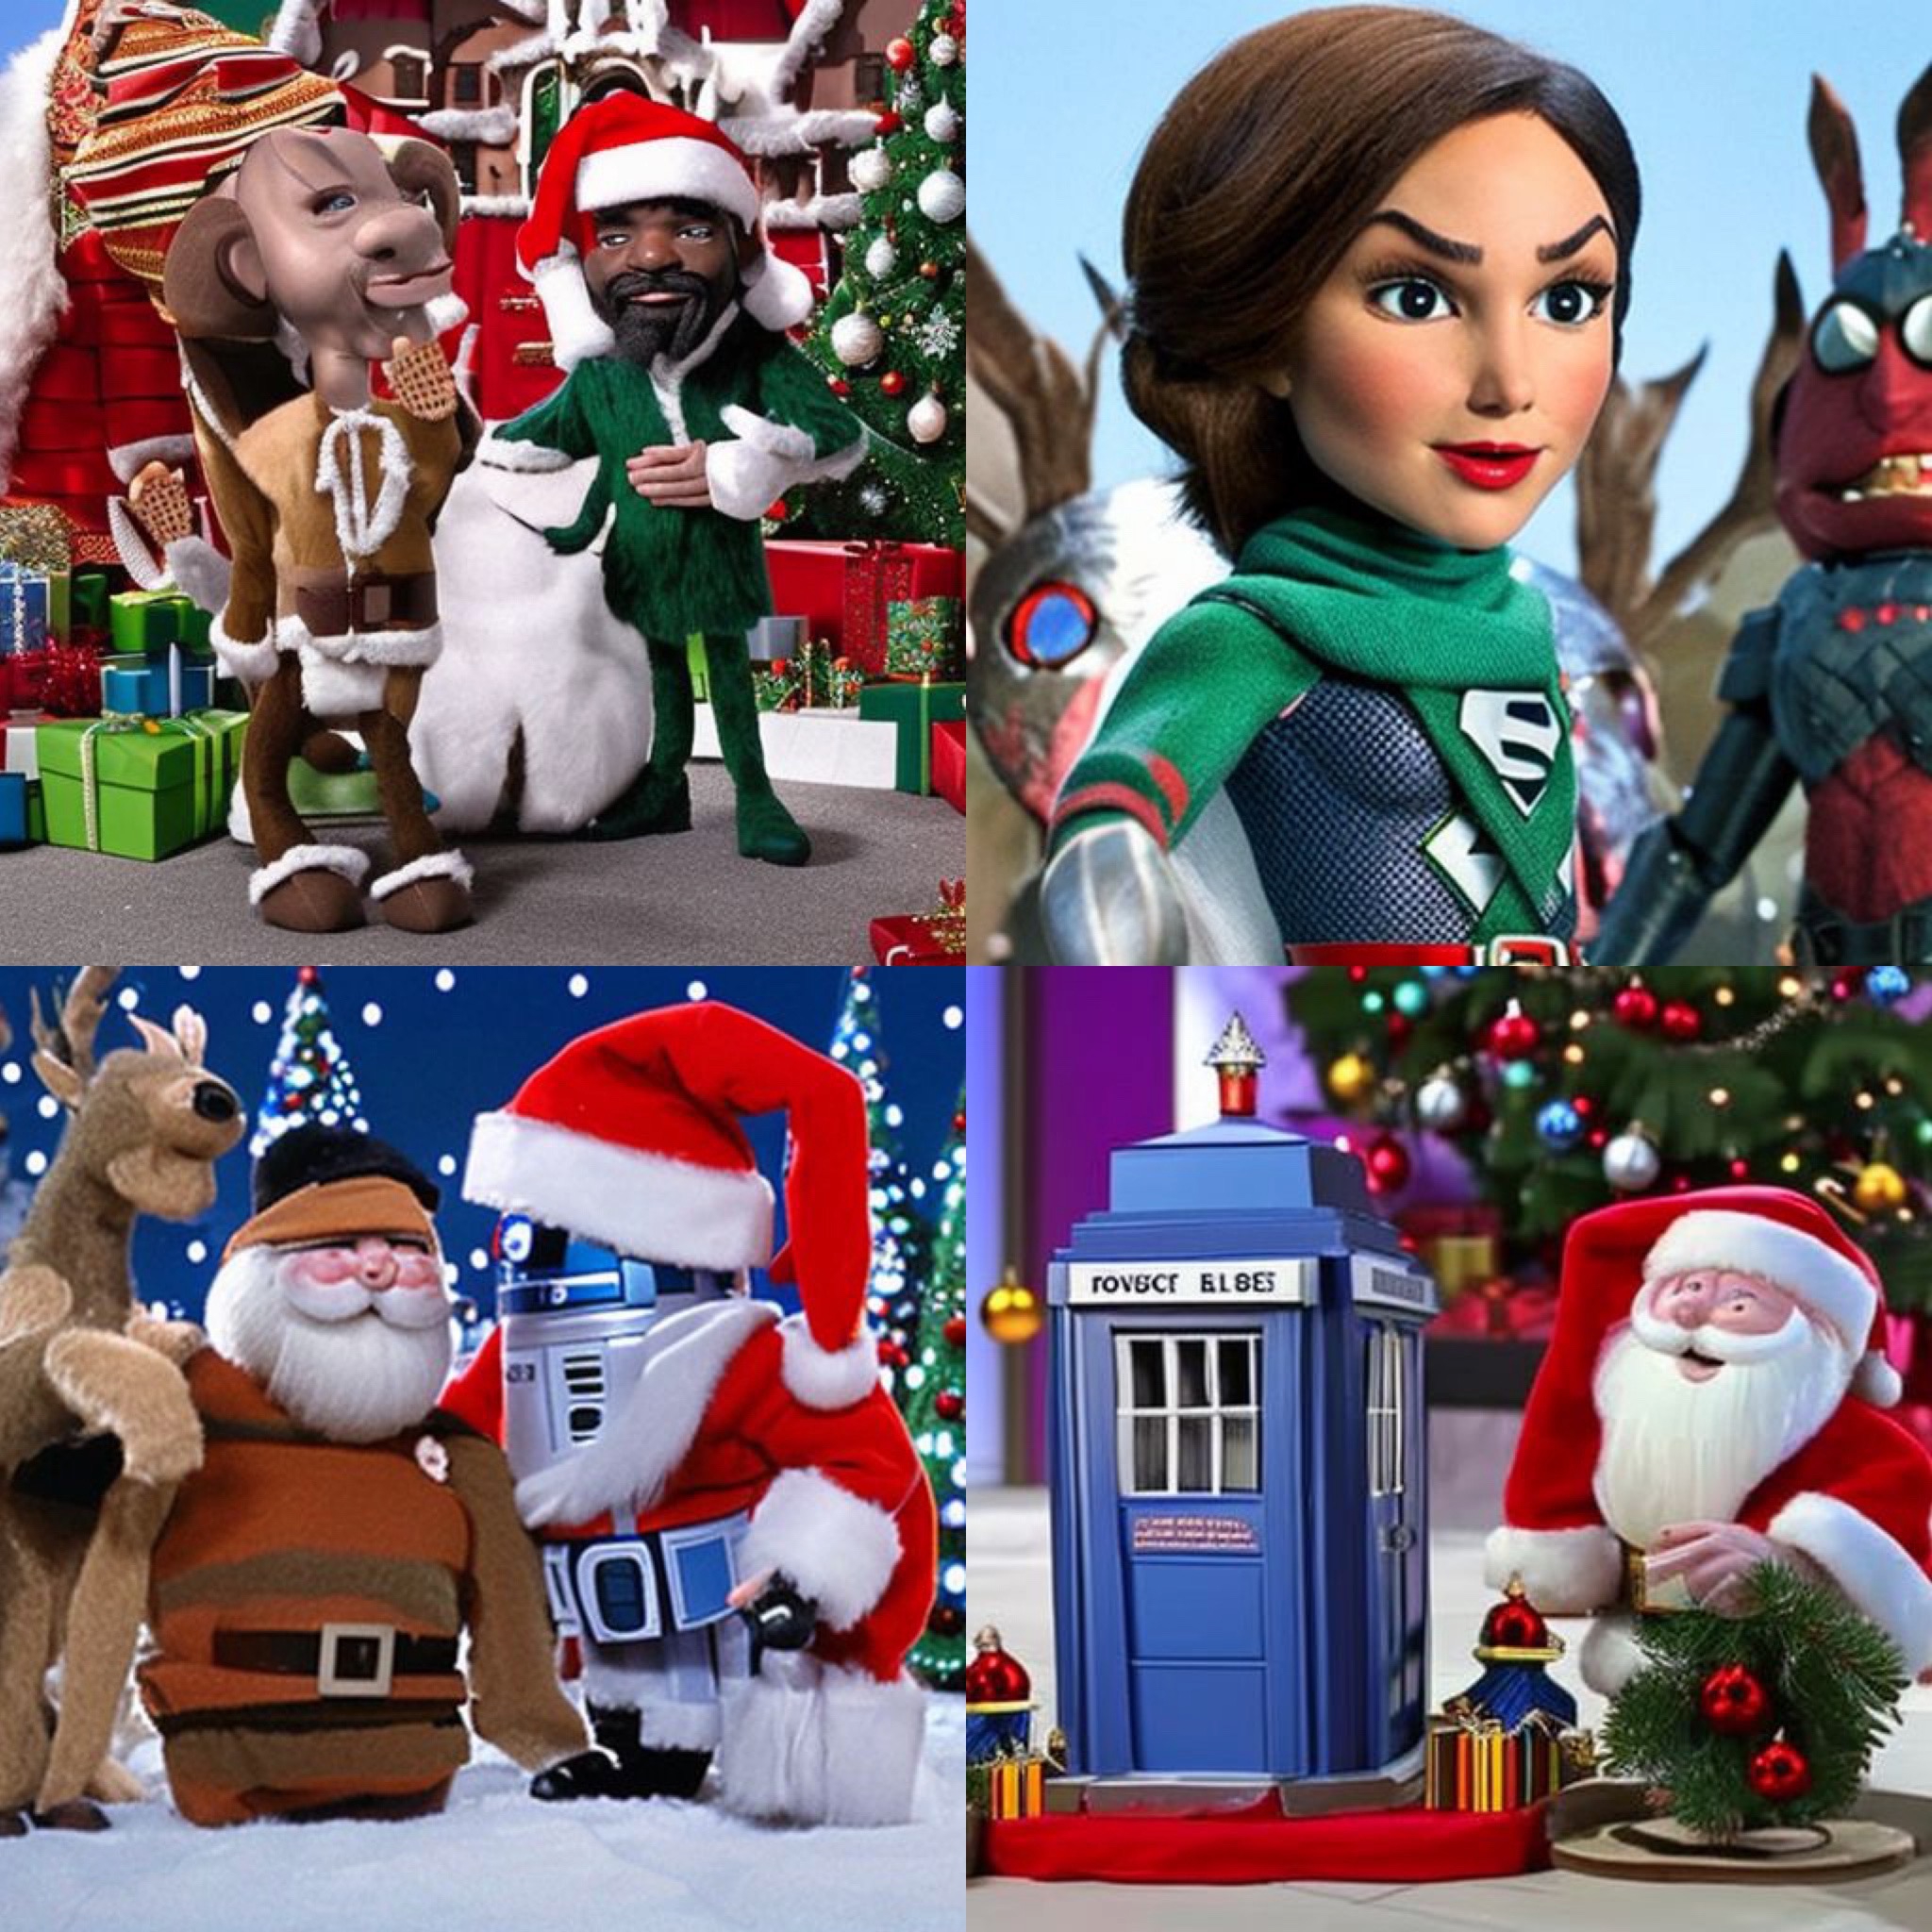
Collage 1 Collage 2 Collage 3 Collage 4


from diffusers import StableDiffusionPipeline, DPMSolverMultistepScheduler
import torch

def main():
    #////////////////////////////////////////////
    seed = 42
    model = "Norod78/sd2-dreambooth-ClaymationXmas"
    #////////////////////////////////////////////

    torch.manual_seed(seed)
    generator = torch.Generator()
    generator.manual_seed(seed)

    scheduler = DPMSolverMultistepScheduler(
        beta_start=0.00085,
        beta_end=0.012,
        beta_schedule="scaled_linear",
        num_train_timesteps=1000,
        trained_betas=None,
        predict_epsilon=True,
        thresholding=False,
        algorithm_type="dpmsolver++",
        solver_type="midpoint",
        lower_order_final=True,
)

    device = "cuda" if torch.cuda.is_available() else "cpu"
    dtype = torch.float16 if device == "cuda" else torch.float32
    pipe = StableDiffusionPipeline.from_pretrained(model, scheduler=scheduler,torch_dtype=dtype, generator=generator,use_auth_token=True).to(device)

    #////////////////////////////////////////////
    num_inference_steps = 20
    width=512
    height=512
    samples=4
    #////////////////////////////////////////////

    prompt = "Willy Wonka, ClaymationXmas"
    result = pipe([prompt] * samples, num_inference_steps=num_inference_steps, height=height, width=width)
    images = result["images"]
    for i, image in enumerate(images):       
        prompt_to_print = str(i) + "-" + prompt
        output_file = prompt_to_print.replace(" ", "_") + "-" + str(width) + "x" +str(height)+ "_" + str(num_inference_steps) + "steps" + "_seed" + str(seed) + ".jpg"
        image.save(output_file)
        print("Saved: " + str(output_file))

if __name__ == '__main__':
    main()

Fine Tuned by @Norod78

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм

Можно запустить

Подбираем GPU…

Ревизия весов
b28ce79

0 моделей