/ Модель

Характеристики

Контекст
32 768 токенов
Параметры
7,1 млрд
Размер весов
14,5 ГБ
Лицензия
Apache 2.0
Архитектура
mistral · dense
Библиотека
transformers
Опубликована
31 окт 2023

Yarn-Mistral-7b-64k

Генерация текстаТекст → текст15 профессий

Модель Mistral на 7,1 млрд параметров с расширенным контекстом до 64 тысяч токенов для генерации текста и работы с длинными документами.

310скачиваний за 30 дней53лайкавеса обновлены2 ноя 2023

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Тесты пользователейпока нет

Никто ещё не опубликовал тест этой модели. Соберите бенчмарк из своих задач — результат появится здесь.

  1. Добавьте модель в бенчмарк

    Вместе с другими моделями категории «Текст» — сравнение идёт внутри одной категории.

  2. Опишите свои задачи

    Напишите запросы, при необходимости приложите файлы и эталонные ответы.

  3. Запустите и опубликуйте

    Модели ответят на каждую задачу, судья оценит ответы. Опубликованный результат появится на этой странице.

Публичные оценки6

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

  • MATH Lvl 5

    MATH Lvl 5 Raw · выше — лучше

    Результат

    0,037

    Open LLM v2 · архив

    Публичная таблицаревизия совпадает

  • BBH

    BBH Raw · выше — лучше

    Результат

    0,4293

    Open LLM v2 · архив

    Публичная таблицаревизия совпадает

  • IFEval

    IFEval Raw · выше — лучше

    Результат

    0,208

    Open LLM v2 · архив

    Публичная таблицаревизия совпадает

  • MUSR

    MUSR Raw · выше — лучше

    Результат

    0,4124

    Open LLM v2 · архив

    Публичная таблицаревизия совпадает

  • GPQA

    GPQA Raw · выше — лучше

    Результат

    0,2903

    Open LLM v2 · архив

    Публичная таблицаревизия совпадает

  • MMLU-PRO

    MMLU-PRO Raw · выше — лучше

    Результат

    0,2914

    Open LLM v2 · архив

    Публичная таблицаревизия совпадает

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

Nous-Yarn-Mistral-7b-64k — языковая модель семейства Mistral, разработанная NousResearch и участниками проекта YaRN. Она основана на Mistral-7B-v0.1 и дополнительно обучена на данных с длинным контекстом в течение 1000 шагов с использованием метода YaRN для расширения контекстного окна. Модель имеет плотную архитектуру MistralForCausalLM, содержит 7,1 млрд параметров и предназначена для генерации текста с контекстом до 64 тысяч токенов. Метаданные указывают native context в 32 768 токенов.

Модель подходит для продолжения текста, работы с длинными документами и других сценариев генерации, где важно учитывать большой объём предшествующего текста. В карточке приведены результаты тестов на длинном контексте и стандартных языковых бенчмарках; они показывают сохранение близкого к исходной Mistral-7B-v0.1 качества на коротком контексте. В карточке указана лицензия Apache-2.0. Для загрузки авторы рекомендуют свежую версию Transformers и параметр trust_remote_code=True.

Сценарии применения

  • генерация продолжения длинного текста
  • суммаризация больших документов в диалоговом интерфейсе
  • ответы на вопросы с учётом длинного контекста
  • анализ содержимого длинных документов
  • обработка больших текстовых фрагментов без предварительного разбиения

Ограничения

Метаданные указывают native context в 32 768 токенов, хотя карточка заявляет поддержку окна до 64 тысяч токенов. Для загрузки может потребоваться trust_remote_code=True и свежая версия Transformers.

Для каких профессий подходит15

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Также подходит для

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

Model Card: Nous-Yarn-Mistral-7b-64k
Preprint (arXiv)
GitHub yarn

Model Description

Nous-Yarn-Mistral-7b-64k is a state-of-the-art language model for long context, further pretrained on long context data for 1000 steps using the YaRN extension method. It is an extension of Mistral-7B-v0.1 and supports a 64k token context window.

To use, pass trust_remote_code=True when loading the model, for example

model = AutoModelForCausalLM.from_pretrained("NousResearch/Yarn-Mistral-7b-64k",
  use_flash_attention_2=True,
  torch_dtype=torch.bfloat16,
  device_map="auto",
  trust_remote_code=True)

In addition you will need to use the latest version of transformers (until 4.35 comes out)

pip install git+https://github.com/huggingface/transformers

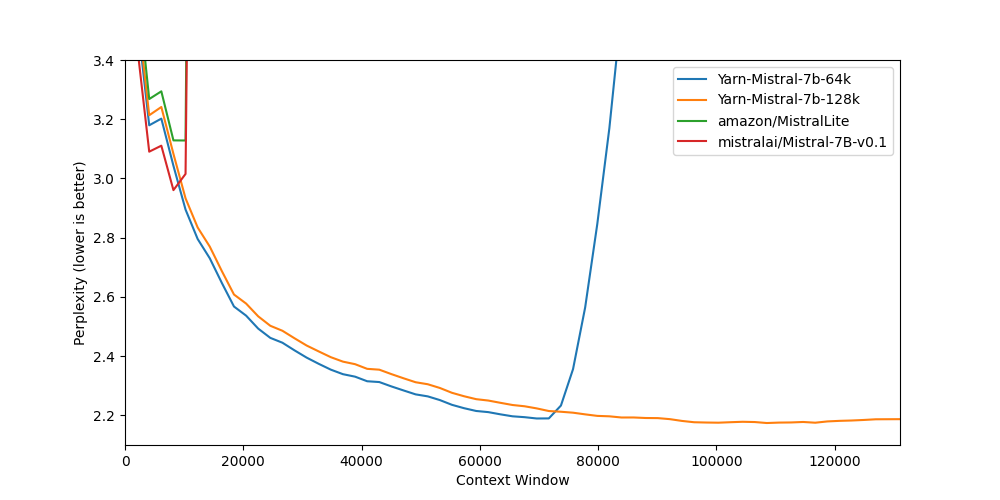
Benchmarks

Long context benchmarks:

ModelContext Window8k PPL16k PPL32k PPL64k PPL128k PPL
Mistral-7B-v0.18k2.96----
Yarn-Mistral-7b-64k64k3.042.652.442.20-
Yarn-Mistral-7b-128k128k3.082.682.472.242.19

Short context benchmarks showing that quality degradation is minimal:

ModelContext WindowARC-cHellaswagMMLUTruthful QA
Mistral-7B-v0.18k59.9883.3164.1642.15
Yarn-Mistral-7b-64k64k59.3881.2161.3242.50
Yarn-Mistral-7b-128k128k58.8780.5860.6442.46

Collaborators

The authors would like to thank LAION AI for their support of compute for this model. It was trained on the JUWELS supercomputer.

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм · transformers

Можно запустить

Подбираем GPU…

Класс архитектуры
MistralForCausalLM
Ревизия весов
0273c62

0 моделей