OpenOrca-Preview1-13B
We have used our own OpenOrca dataset to fine-tune LLaMA-13B. This dataset is our attempt to reproduce the dataset generated for Microsoft Research's Orca Paper.
We have trained on less than 6% of our data, just to give a preview of what is possible while we further refine our dataset! We trained a refined selection of 200k GPT-4 entries from OpenOrca. We have filtered our GPT-4 augmentations to remove statements like, "As an AI language model..." and other responses which have been shown to harm model reasoning capabilities. Further details on our dataset curation practices will be forthcoming with our full model releases.
This release highlights that even a small portion of our training data can produce state of the art results in this model class with training costs <$200 in total.
Want to visualize our full (pre-filtering) dataset? Check out our Nomic Atlas Map.
We are in-process with training more models, so keep a look out on our org for releases coming soon with exciting partners.
We will also give sneak-peak announcements on our Discord, which you can find here:
Evaluation
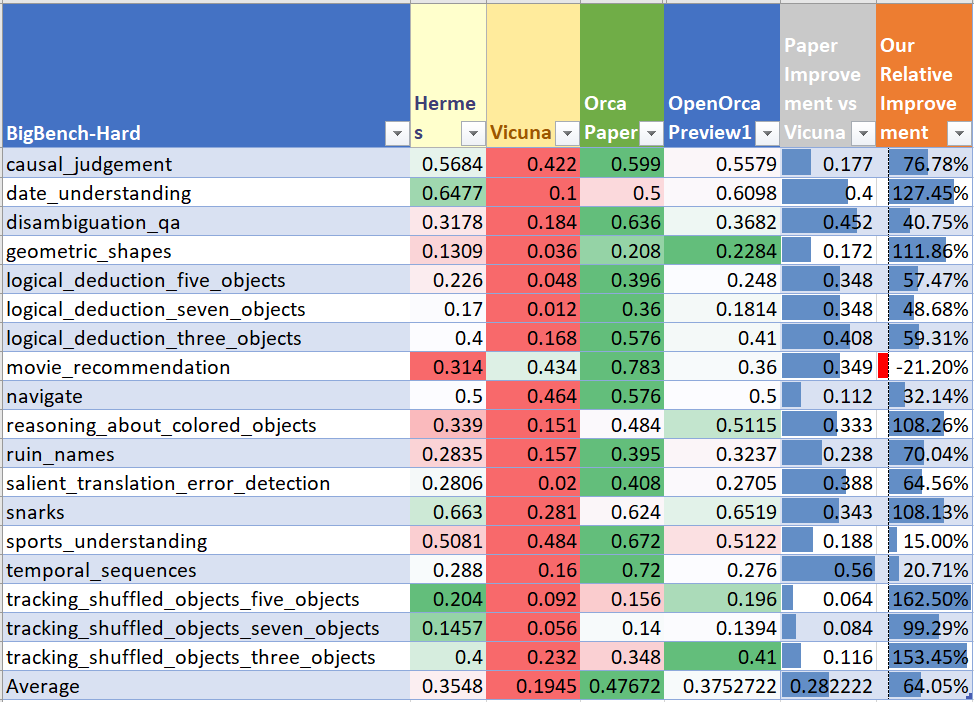
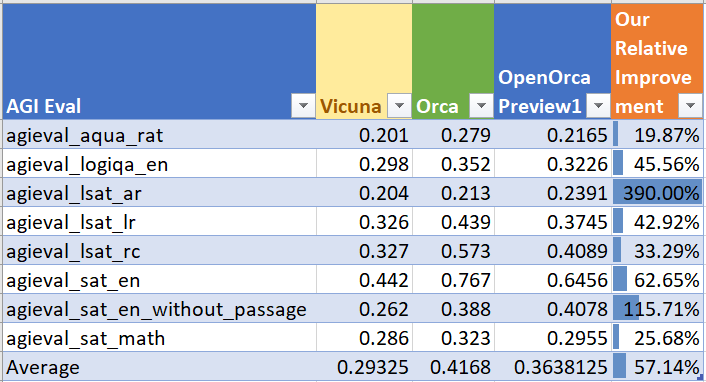
We have evaluated OpenOrca-Preview1-13B on hard reasoning tasks from BigBench-Hard and AGIEval as outlined in the Orca paper.
Our average performance for BigBench-Hard: 0.3753
Average for AGIEval: 0.3638
In the Orca paper, they measured their score relative to Vicuna on these evals. We've done the same and have found our score averages to ~60% of the total improvement that was shown in the Orca paper.
So we got 60% of the improvement with 6% of the data!
BigBench-Hard Performance
AGIEval Performance
We will report our results on HuggingFaceH4 Open LLM Leaderboard Evals once we receive them.
Dataset
We used a small (6%, 200k) subset of our data from OpenOrca, which aims to reproduce the Orca Research Paper dataset.
As this release is intended as a preview, please await our full releases for further details on the training data.
Training
We trained with 8x A100-80G GPUs for 15 hours. Commodity cost was < $200.
We trained for 4 epochs and selected a snapshot at 3 epochs for peak performance.
Please await our full releases for further training details.
Prompting
It uses the Alpaca format (see FastChat implementation example):
### Instruction:

### Response:
Citation
@software{OpenOrca_Preview1,
  title = {OpenOrca_Preview1: A LLaMA-13B Model Fine-tuned on Small Portion of OpenOrcaV1 Dataset},
  author = {Wing Lian and Bleys Goodson and Eugene Pentland and Austin Cook and Chanvichet Vong and "Teknium"},
  year = {2023},
  publisher = {HuggingFace},
  journal = {HuggingFace repository},
  howpublished = {\url{https://https://huggingface.co/Open-Orca/OpenOrca-Preview1-13B},
}
@misc{mukherjee2023orca,
      title={Orca: Progressive Learning from Complex Explanation Traces of GPT-4},
      author={Subhabrata Mukherjee and Arindam Mitra and Ganesh Jawahar and Sahaj Agarwal and Hamid Palangi and Ahmed Awadallah},
      year={2023},
      eprint={2306.02707},
      archivePrefix={arXiv},
      primaryClass={cs.CL}
}
@misc{longpre2023flan,
      title={The Flan Collection: Designing Data and Methods for Effective Instruction Tuning},
      author={Shayne Longpre and Le Hou and Tu Vu and Albert Webson and Hyung Won Chung and Yi Tay and Denny Zhou and Quoc V. Le and Barret Zoph and Jason Wei and Adam Roberts},
      year={2023},
      eprint={2301.13688},
      archivePrefix={arXiv},
      primaryClass={cs.AI}
}
@software{touvron2023llama,
  title={LLaMA: Open and Efficient Foundation Language Models},
  author={Touvron, Hugo and Lavril, Thibaut and Izacard, Gautier and Martinet, Xavier and Lachaux, Marie-Anne and Lacroix, Timoth{\'e}e and Rozi{\`e}re, Baptiste and Goyal, Naman and Hambro, Eric and Azhar, Faisal and Rodriguez, Aurelien and Joulin, Armand and Grave, Edouard and Lample, Guillaume},
  journal={arXiv preprint arXiv:2302.13971},
  year={2023}
}