Qwen2-Math-RM-72B
Introduction
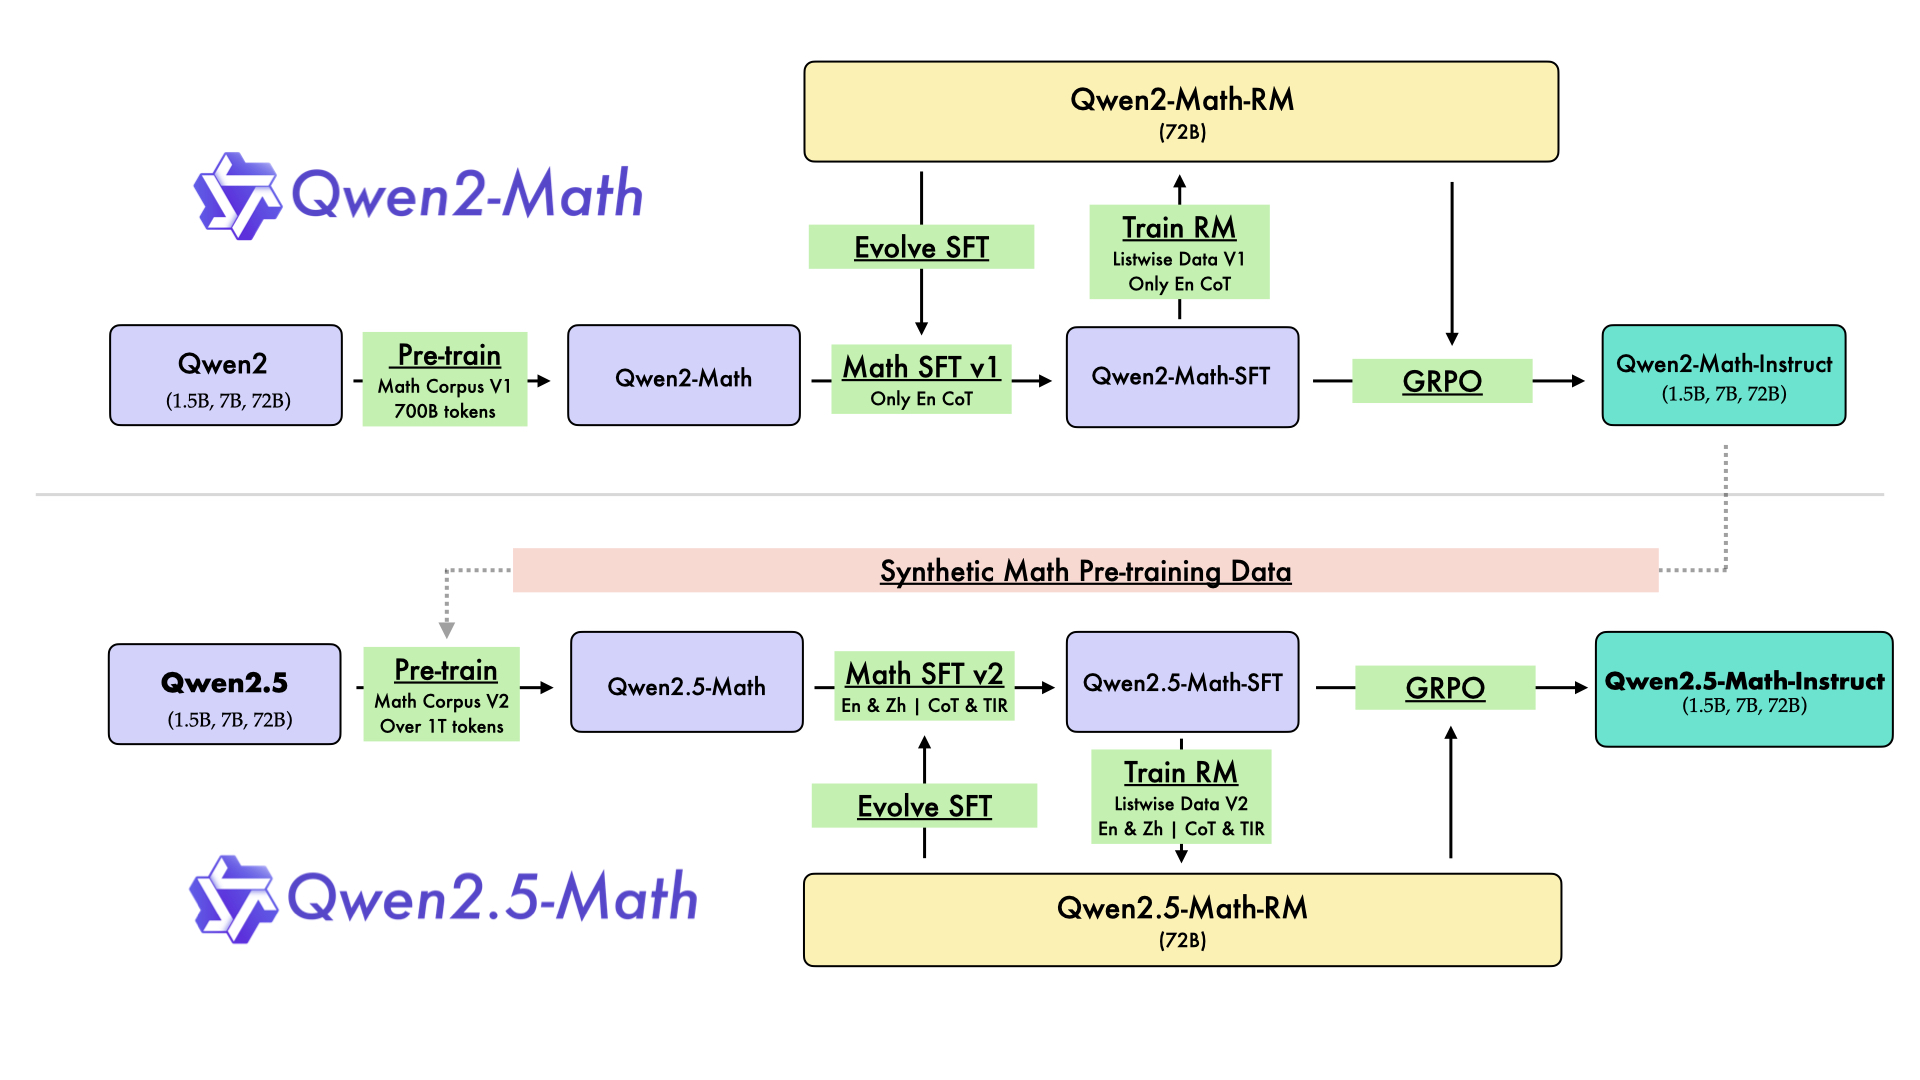
Qwen2-Math-RM-72B is specifically designed to guide the Qwen2-Math model throughout the training process by offering more granular feedback on the quality of reasoning and intermediate steps, ultimately facilitating more robust model improvements.
Key Highlights:
-
Model Training Guide:
- Training Data Enhancement: Employs a data selection process via reward model scoring combined with Rejection Sampling to incrementally enhance the quality of responses
- Reinforcement Learning Training: Integrates seamlessly into the reinforcement learning training and provide effective reward signal, further improving model performance.
-
Inference Boosting:
- Best of N: By leveraging a combination of response sampling and Best-of-N strategies, we choose the response of top score judged by reward model, yielding better results with spending more inference time. For example, Qwen2-Math-1.5B-Instruct obtains 79.9 on MATH in RM@8 setting and even surpasses the performance of Qwen2-Math-7B-Instruct 75.1 with greedy decoding.
- Comparasion with majority voting (Maj@N): RM@N scores are substantially better than Maj@N scores aross almost all benchmarks and models.
Model Details
For more details, please refer to our blog post and GitHub repo.
Requirements
transformers>=4.40.0for Qwen2-Math models. The latest version is recommended.
[!Warning]
For requirements on GPU memory and the respective throughput, see similar results of Qwen2 here.
Quick Start
[!Important]
Qwen2-Math-RM-72B is a reward model typically used for offering feedback on the quality of reasoning and intermediate steps, serving in Rejection Sampling, reinforcement learning training and RM@N.
🤗 Hugging Face Transformers
Here we show a code snippet to show you how to use the Qwen2-Math-RM-72B with transformers:
import torch
from transformers import AutoModel, AutoTokenizer

model_name = "Qwen/Qwen2-Math-RM-72B"
device = "auto" # the device to load the model onto

model = AutoModel.from_pretrained(
    model_name,
    device_map=device,
    torch_dtype=torch.bfloat16,
    trust_remote_code=True,
).eval()

tokenizer = AutoTokenizer.from_pretrained(model_name, trust_remote_code=True)

chat = [
    {"role": "system", "content": ""},
    {"role": "user", "content": "Suppose that a certain software product has a mean time between failures of 10,000 hours and has a mean time to repair of 20 hours. If the product is used by 100 customers, what is its availability?\nAnswer Choices: (A) 80% (B) 90% (C) 98% (D) 99.80%\nPlease reason step by step, and put your final answer within \\boxed{}."},
    {"role": "assistant", "content": "To find the availability of the software product, we'll use the formula:\n\n\\[ \\text{ availability} = \\frac{\\text{Mean Time Between Failures (MTBF)}}{\\text{Mean Time Between Failures (MTBF) + Mean Time To Repair (MTTR)}} \\]\n\nGiven:\n- MTBF = 10,000 hours\n- MTTR = 20 hours\n\nLet's plug these values into the formula:\n\n\\[ \\text{availability} = \\frac{10,000}{10,000 + 20} = \\frac{10,000}{10,020} \\]\n\nTo simplify this fraction, we can divide both the numerator and the denominator by 10,000:\n\n\\[ \\text{availability} = \\frac{10,000 \\div 10,000}{10,020 \\div 10,000} = \\frac{1}{1.002} \\]\n\nTo express this as a percentage, we can calculate the decimal value of the fraction and then multiply by 100:\n\n\\[ \\text{availability} \\approx 0.998002 \\times 100 = 99.80\\% \\]\n\nTherefore, the availability of the software product is approximately 99.80%.\n\nThe correct answer is \\boxed{D}"}
] # 1.7578

conversation_str = tokenizer.apply_chat_template(
    chat,
    tokenize=False,
    add_generation_prompt=False
)

input_ids = tokenizer.encode(
    conversation_str,
    return_tensors="pt",
    add_special_tokens=False
).to(model.device)

outputs = model(input_ids=input_ids)
print(outputs[0])
Citation
If you find our work helpful, feel free to give us a citation.
@article{yang2024qwen2,
  title={Qwen2 technical report},
  author={Yang, An and Yang, Baosong and Hui, Binyuan and Zheng, Bo and Yu, Bowen and Zhou, Chang and Li, Chengpeng and Li, Chengyuan and Liu, Dayiheng and Huang, Fei and others},
  journal={arXiv preprint arXiv:2407.10671},
  year={2024}
}