/ Модель

Характеристики

Контекст
4 096 токенов
Параметры
1,5 млрд
Лицензия
Apache 2.0
Архитектура
qwen2 · dense
Базовая модель
Qwen2.5-Math-1.5B
Библиотека
transformers
Опубликована
16 сен 2024

Qwen2.5-Math-1.5B-Instruct

Генерация текстаТекст → текст3 профессии

Инструкционная языковая модель Qwen2 с 1,5 млрд параметров для решения математических задач на английском и китайском языках.

221 тыс.скачиваний за 30 дней60лайковвеса обновлены23 сен 2024

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Тесты пользователейпока нет

Никто ещё не опубликовал тест этой модели. Соберите бенчмарк из своих задач — результат появится здесь.

  1. Добавьте модель в бенчмарк

    Вместе с другими моделями категории «Текст» — сравнение идёт внутри одной категории.

  2. Опишите свои задачи

    Напишите запросы, при необходимости приложите файлы и эталонные ответы.

  3. Запустите и опубликуйте

    Модели ответят на каждую задачу, судья оценит ответы. Опубликованный результат появится на этой странице.

Публичные оценки7

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

  • IFEval

    IFEval Raw · выше — лучше

    Результат

    0,1856

    Open LLM v2 · архив

    Публичная таблицаревизия совпадает

  • GPQA

    GPQA Raw · выше — лучше

    Результат

    0,2651

    Open LLM v2 · архив

    Публичная таблицаревизия совпадает

  • MUSR

    MUSR Raw · выше — лучше

    Результат

    0,3685

    Open LLM v2 · архив

    Публичная таблицаревизия совпадает

  • MMLU-PRO

    MMLU-PRO Raw · выше — лучше

    Результат

    0,1801

    Open LLM v2 · архив

    Публичная таблицаревизия совпадает

  • BBH

    BBH Raw · выше — лучше

    Результат

    0,3752

    Open LLM v2 · архив

    Публичная таблицаревизия совпадает

  • MATH Lvl 5

    MATH Lvl 5 Raw · выше — лучше

    Результат

    0,2628

    Open LLM v2 · архив

    Публичная таблицаревизия совпадает

  • pymlex/calculator

    score

    Результат

    0,7583

    Hugging Face Eval Results

    Отчёт автораревизия не подтверждена

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

Qwen2.5-Math-1.5B-Instruct — языковая модель с архитектурой Qwen2, разработанная командой Qwen. Это версия с инструкционной настройкой и 1,5 млрд параметров, предназначенная прежде всего для решения математических задач на английском и китайском языках с пошаговыми рассуждениями (CoT) и tool-integrated reasoning (TIR). Модель работает через Transformers и поддерживает контекст до 4096 токенов.

TIR помогает выполнять точные вычисления, символьные преобразования и алгоритмические рассуждения; модель подходит для ответов на математические вопросы и решения задач, включая вычислительно сложные примеры. В карточке приведён результат 79,7 на бенчмарке MATH для версии 1.5B-Instruct при использовании TIR. Разработчик не рекомендует применять семейство для задач вне математики. Модель распространяется по лицензии Apache-2.0.

Сценарии применения

  • пошаговое решение задач по математике на английском
  • решение задач по математике на китайском
  • точные вычисления с использованием инструментов
  • символьные преобразования и решение уравнений
  • алгоритмические математические рассуждения

Ограничения

Разработчик не рекомендует использовать модель для задач вне математики. Основные заявленные языки для математических задач — английский и китайский.

Для каких профессий подходит3

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

Qwen2.5-Math-1.5B-Instruct

[!Warning]

Introduction

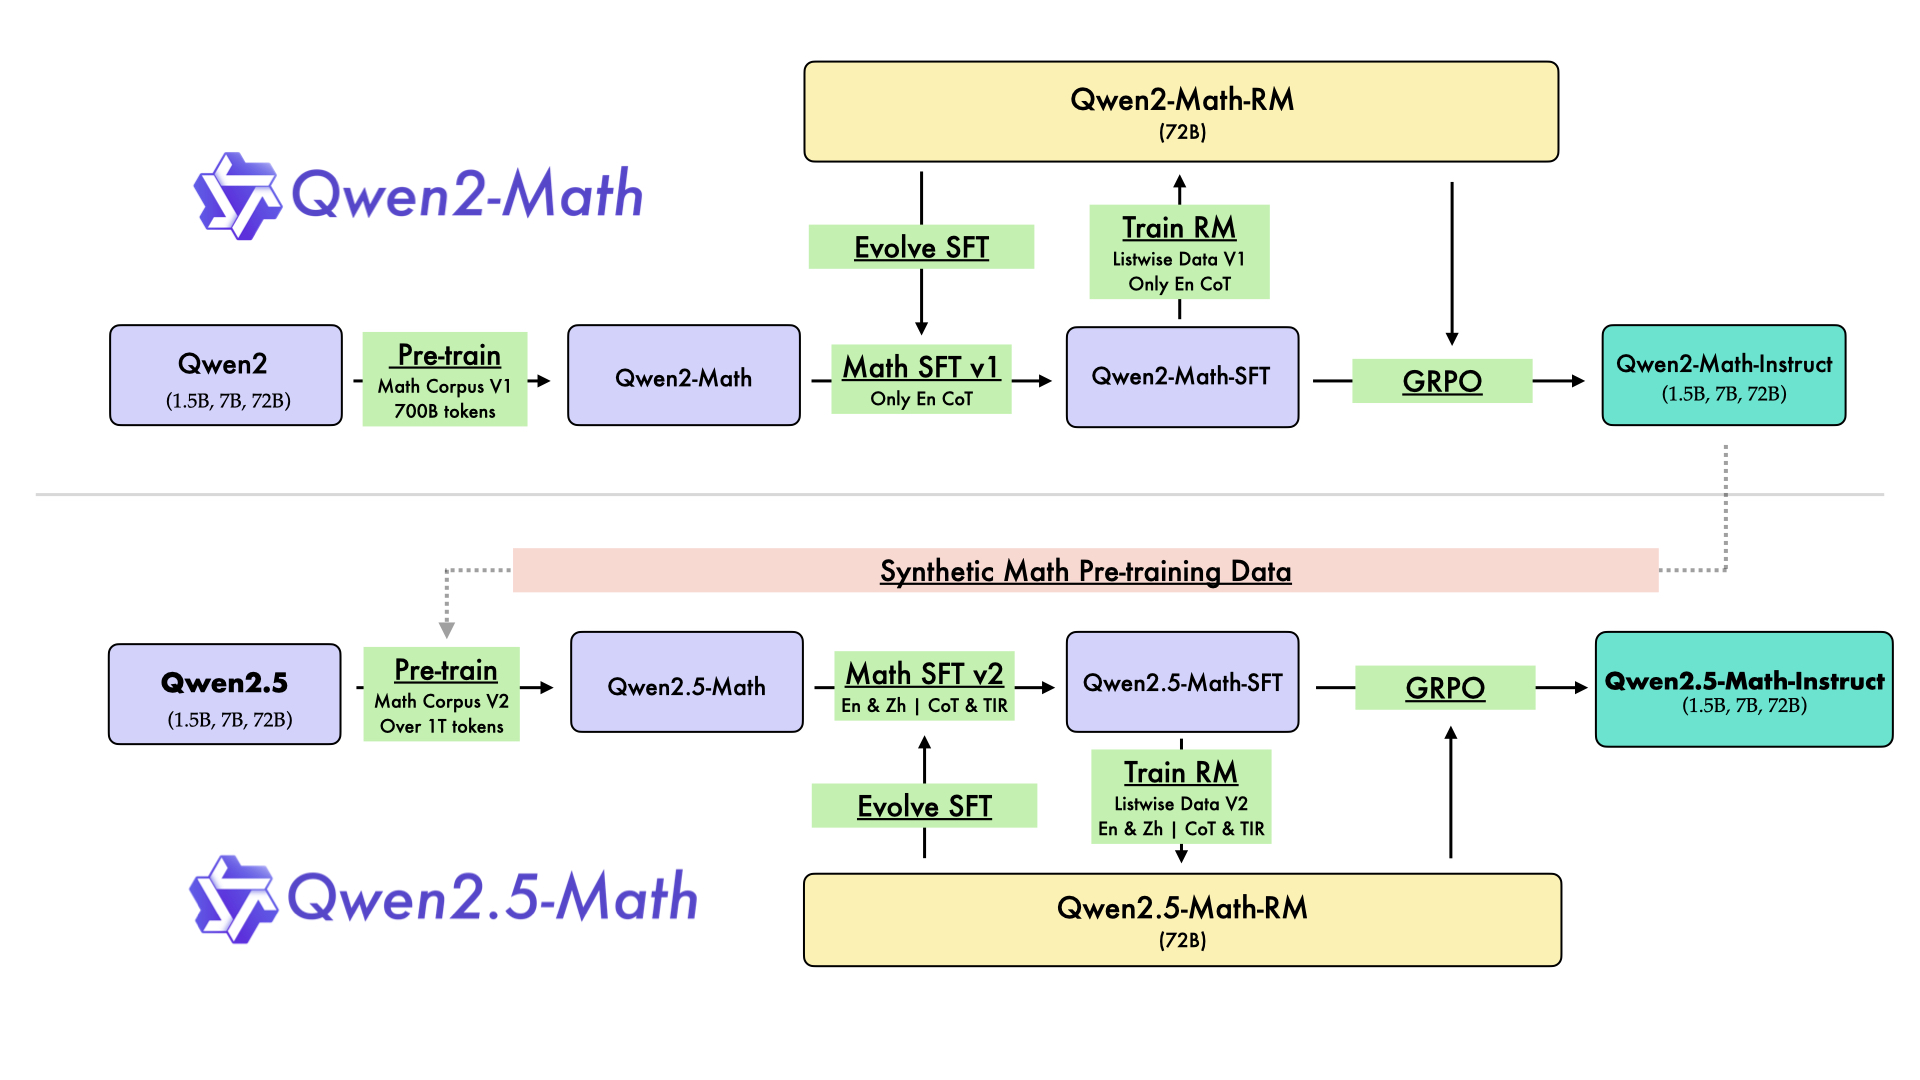
In August 2024, we released the first series of mathematical LLMs - Qwen2-Math - of our Qwen family. A month later, we have upgraded it and open-sourced Qwen2.5-Math series, including base models Qwen2.5-Math-1.5B/7B/72B, instruction-tuned models Qwen2.5-Math-1.5B/7B/72B-Instruct, and mathematical reward model Qwen2.5-Math-RM-72B.

Unlike Qwen2-Math series which only supports using Chain-of-Thught (CoT) to solve English math problems, Qwen2.5-Math series is expanded to support using both CoT and Tool-integrated Reasoning (TIR) to solve math problems in both Chinese and English. The Qwen2.5-Math series models have achieved significant performance improvements compared to the Qwen2-Math series models on the Chinese and English mathematics benchmarks with CoT.
While CoT plays a vital role in enhancing the reasoning capabilities of LLMs, it faces challenges in achieving computational accuracy and handling complex mathematical or algorithmic reasoning tasks, such as finding the roots of a quadratic equation or computing the eigenvalues of a matrix. TIR can further improve the model's proficiency in precise computation, symbolic manipulation, and algorithmic manipulation. Qwen2.5-Math-1.5B/7B/72B-Instruct achieve 79.7, 85.3, and 87.8 respectively on the MATH benchmark using TIR.

Model Details

For more details, please refer to our blog post and GitHub repo.

Requirements

  • transformers>=4.37.0 for Qwen2.5-Math models. The latest version is recommended.

[!Warning]

For requirements on GPU memory and the respective throughput, see similar results of Qwen2 here.

Quick Start

[!Important]

Qwen2.5-Math-1.5B-Instruct is an instruction model for chatting;

Qwen2.5-Math-1.5B is a base model typically used for completion and few-shot inference, serving as a better starting point for fine-tuning.

🤗 Hugging Face Transformers

Qwen2.5-Math can be deployed and infered in the same way as Qwen2.5. Here we show a code snippet to show you how to use the chat model with transformers:

from transformers import AutoModelForCausalLM, AutoTokenizer

model_name = "Qwen/Qwen2.5-Math-1.5B-Instruct"
device = "cuda" # the device to load the model onto

model = AutoModelForCausalLM.from_pretrained(
    model_name,
    torch_dtype="auto",
    device_map="auto"
)
tokenizer = AutoTokenizer.from_pretrained(model_name)

prompt = "Find the value of $x$ that satisfies the equation $4x+5 = 6x+7$."

# CoT
messages = [
    {"role": "system", "content": "Please reason step by step, and put your final answer within \\boxed{}."},
    {"role": "user", "content": prompt}
]

# TIR
messages = [
    {"role": "system", "content": "Please integrate natural language reasoning with programs to solve the problem above, and put your final answer within \\boxed{}."},
    {"role": "user", "content": prompt}
]

text = tokenizer.apply_chat_template(
    messages,
    tokenize=False,
    add_generation_prompt=True
)
model_inputs = tokenizer([text], return_tensors="pt").to(device)

generated_ids = model.generate(
    **model_inputs,
    max_new_tokens=512
)
generated_ids = [
    output_ids[len(input_ids):] for input_ids, output_ids in zip(model_inputs.input_ids, generated_ids)
]

response = tokenizer.batch_decode(generated_ids, skip_special_tokens=True)[0]

Citation

If you find our work helpful, feel free to give us a citation.

@article{yang2024qwen25mathtechnicalreportmathematical,
  title={Qwen2.5-Math Technical Report: Toward Mathematical Expert Model via Self-Improvement}, 
  author={An Yang and Beichen Zhang and Binyuan Hui and Bofei Gao and Bowen Yu and Chengpeng Li and Dayiheng Liu and Jianhong Tu and Jingren Zhou and Junyang Lin and Keming Lu and Mingfeng Xue and Runji Lin and Tianyu Liu and Xingzhang Ren and Zhenru Zhang},
  journal={arXiv preprint arXiv:2409.12122},
  year={2024}
}

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм · transformers

Можно запустить

Подбираем GPU…

Класс архитектуры
Qwen2ForCausalLM
Ревизия весов
aafeb0f

0 моделей