/ Модель

Характеристики

Контекст
512 токенов
Параметры
137 млн
Лицензия
MIT
Архитектура
bert · dense
Опубликована
5 ноя 2022

SciNERTopic

Разметка токеновТекст → label3 профессии

SciNERTopic извлекает и классифицирует научные термины в текстах, помогая готовить данные для тематического моделирования.

98скачиваний за 30 дней8лайковвеса обновлены14 мая 2023

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

SciNERTopic — модель распознавания именованных сущностей на основе SciBERT, дообученная автором RJuro на наборе SciERC для извлечения научных терминов из текста. Она размечает токены по категориям: задачи и применения, методы и инструменты, метрики оценки, материалы и ресурсы, прочие научные термины и общие слова. Модель предназначена для анализа научных публикаций и может использоваться как этап подготовки данных для тематического моделирования, в том числе в подходе, вдохновлённом BERTopic.

Модель построена на архитектуре BERT и содержит 137,1 млн параметров; максимальная длина контекста — 512 токенов. В README приведены результаты на оценке: точность 0,577, полнота 0,632 и F1 0,603. Модель распространяется под лицензией MIT. Показатель F1 указывает на ограниченное качество разметки; перед применением в важных сценариях стоит проверить её на целевом корпусе.

Сценарии применения

  • извлечение методов и инструментов из научных статей
  • поиск метрик оценки в научных публикациях
  • выделение задач и применений, рассматриваемых в статье
  • извлечение названий наборов данных и научных ресурсов
  • подготовка терминов для тематического моделирования научного корпуса

Ограничения

В README указаны precision 0,577, recall 0,632 и F1 0,603, поэтому качество разметки ограничено и может требовать проверки или адаптации к целевому корпусу. Поддерживаемые языки в предоставленных данных не установлены.

Для каких профессий подходит3

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

NER model based on allenai/scibert_scivocab_cased Fine-tuned using the SciERC Dataset to identify scientific terms:

  • Task: Applications, problems to solve, systems to construct. E.g. information extraction, machine reading system, image segmentation, etc.
  • Method: Methods , models, systems to use, or tools, components of a system, frameworks. E.g. language model, CORENLP, POS parser, kernel method, etc. • Evaluation Metric: Metrics, measures, or entities that can express the quality of a system/method. E.g. F1, BLEU, Precision, Recall, ROC curve, mean reciprocal rank, mean-squared error, robustness, time complexity, etc.
  • Material: Data, datasets, resources, Corpus, Knowledge base. E.g. image data, speech data, stereo images, bilingual dictionary, paraphrased questions, CoNLL, Panntreebank, WordNet, Wikipedia, etc.
  • Other Scientific Terms: Phrases that are scientific terms but do not fall into any of the above classes E.g. physical or geometric constraints, qualitative prior knowledge, discourse structure, syntactic rule, discourse structure, tree, node, tree kernel, features, noise, criteria
  • Generic: General terms or pronouns that may refer to an entity but are not themselves informative, often used as connection words. E.g model, approach, prior knowledge, them, it...

Training

  • Learning Rate: 1e-05
  • Epochs: 10,

Performance

  • Eval Loss: 0.401
  • Precision 0.577
  • Recall: 0.632
  • F1: 0.603

Colab

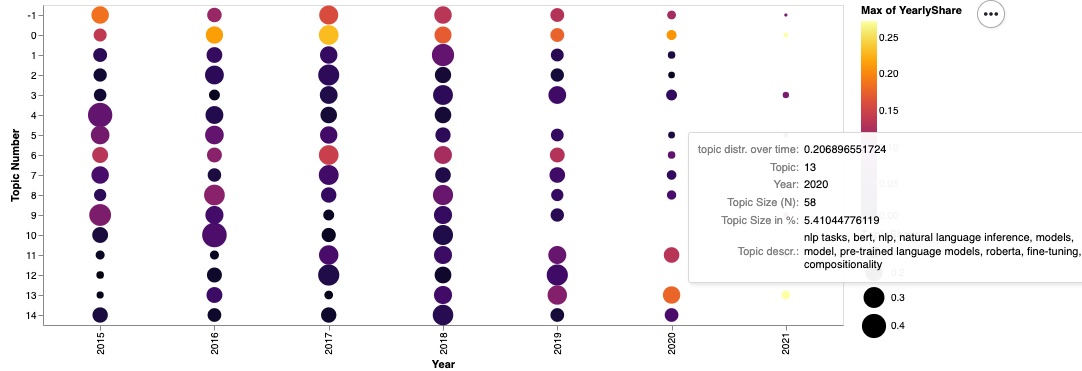
Check out how this model is used for NER-enhanced topic modelling, inspired by BERTopic.

Use

from transformers import AutoTokenizer, AutoModelForTokenClassification
from transformers import pipeline

tokenizer = AutoTokenizer.from_pretrained("RJuro/SciNERTopic")
model_trf = AutoModelForTokenClassification.from_pretrained("RJuro/SciNERTopic")

nlp = pipeline("ner", model=model_trf, tokenizer=tokenizer, aggregation_strategy='average')

Cite this model

@misc {roman_jurowetzki_2022,
	author       = { {Roman Jurowetzki, Hamid Bekamiri} },
	title        = { SciNERTopic - NER enhanced transformer-based topic modelling for scientific text },
	year         = 2022,
	url          = { https://huggingface.co/RJuro/SciNERTopic },
	doi          = { 10.57967/hf/0095 },
	publisher    = { Hugging Face }
}

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм · token-classification

Можно запустить

Подбираем GPU…

Класс архитектуры
BertForTokenClassification
Ревизия весов
d3b536b

0 моделей