Spec-T1-RL-7B
A high-precision mathematical and algorithmic reasoning model
📋 Model Card
| Model Details | Description |
|---|---|
| Developer | SVECTOR |
| Model Size | 7 billion parameters |
| Context Length | 32,000 tokens |
| Training Data | Reasoning-focused datasets with mathematical, logical, and code content |
| Precision | bfloat16, float16 |
| License | MIT |
| Release Date | May 2025 |
🔍 Model Overview
Spec-T1-RL-7B is a specialized large language model engineered for exceptional performance in mathematical reasoning, algorithmic problem-solving, and real-world code generation. Unlike general-purpose models, Spec-T1 has been architecturally designed and trained specifically to excel in domains requiring precise, logical thinking.
The model represents a significant advancement in specialized reasoning capabilities at the 7B parameter scale, outperforming much larger models on technical benchmarks while maintaining efficient deployment requirements.
✨ Key Capabilities
- Mathematical Reasoning: Solves complex math problems with step-by-step logical deduction
- Algorithmic Problem-Solving: Designs and analyzes algorithms across multiple domains
- Code Generation: Produces functional, high-quality code with strong test pass rates
- Precise Instruction Following: Responds accurately to structured technical prompts
- Symbolic Verification: Uses built-in verification mechanisms for mathematics and logic
🏗️ Model Architecture
Spec-T1-RL-7B combines several architectural innovations to achieve its specialized reasoning capabilities:
- Foundation: Advanced transformer architecture with optimized attention mechanisms
- Mixture-of-Experts (MoE): Lightweight conditional computation for efficient scaling
- Activations: SwiGLU activations for improved gradient flow in mathematical operations
- Normalization: RMSNorm for faster convergence and stability in reasoning tasks
🛠️ Training Methodology
Our model underwent a three-phase training process designed to optimize reasoning capabilities:
1️⃣ Reasoning-Aware Pretraining
- Specialized corpus with heavy emphasis on mathematical notation, logical syntax, and code
- Curriculum learning approach prioritizing structured reasoning patterns
- Custom tokenizer optimized for mathematical and programming syntax
2️⃣ Instruction Fine-Tuning
- 400K+ multi-domain, structured prompts focused on reasoning tasks
- Combined CodeInstruct methodology with ThoughtChain prompting
- Synthetic data generation with verification feedback loops
3️⃣ Reinforcement Learning Alignment
- Reward modeling using deterministic pass/fail signals for math and code correctness
- Unit test integration for real-time verification of generated solutions
- Symbolic verification of mathematical proofs and derivations
📊 Benchmark Performance
The Spec-T1-RL-7B model demonstrates exceptional performance across reasoning benchmarks, particularly in mathematics and code generation tasks:
General Reasoning
| Benchmark | GPT-4o-0513 | Claude-3.5-Sonnet | OpenAI o1-mini | QwQ-32B | Spec-T1 |
|---|---|---|---|---|---|
| GPQA Diamond (Pass@1) | 49.9 | 65.0 | 60.0 | 54.5 | 65.1 |
| SuperGPQA (Pass@1) | 42.4 | 48.2 | 45.2 | 43.6 | 52.8 |
| DROP (3-shot F1) | 83.7 | 88.3 | 83.9 | 71.2 | 86.2 |
| MMLU-Pro (EM) | 72.6 | 78.0 | 80.3 | 52.0 | 76.4 |
| IF-Eval (Prompt Strict) | 84.3 | 86.5 | 84.8 | 40.4 | 83.3 |
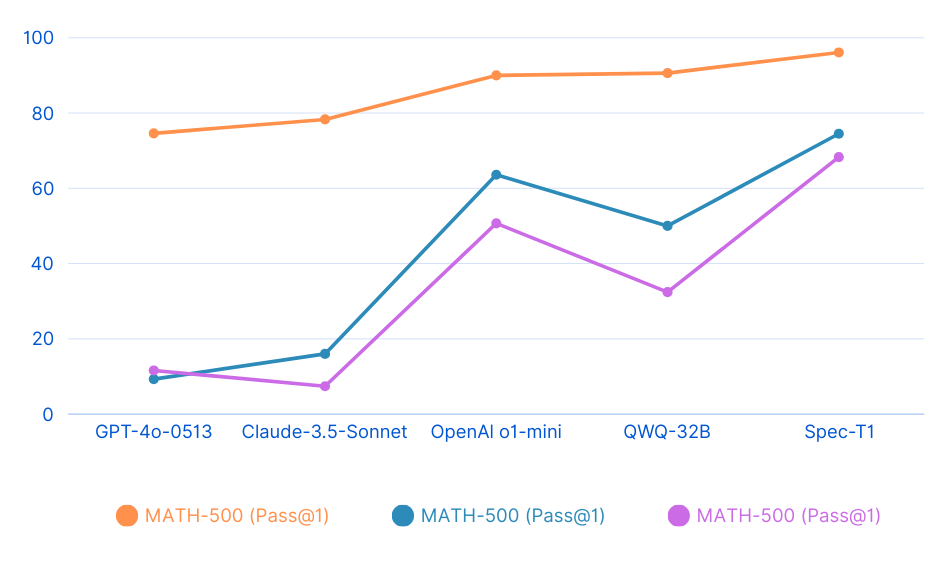
Mathematics
| Benchmark | GPT-4o-0513 | Claude-3.5-Sonnet | OpenAI o1-mini | QwQ-32B | Spec-T1 |
|---|---|---|---|---|---|
| MATH-500 (Pass@1) | 74.6 | 78.3 | 90.0 | 90.6 | 96.1 |
| AIME 2024 (Pass@1) | 9.3 | 16.0 | 63.6 | 50.0 | 74.5 |
| AIME 2025 (Pass@1) | 11.6 | 7.4 | 50.7 | 32.4 | 68.3 |
Code Generation
| Benchmark | GPT-4o-0513 | Claude-3.5-Sonnet | OpenAI o1-mini | QwQ-32B | Spec-T1 |
|---|---|---|---|---|---|
| LiveCodeBench v5 (Pass@1) | 32.9 | 38.9 | 53.8 | 41.9 | 60.2 |
| LiveCodeBench v6 (Pass@1) | 30.9 | 37.2 | 46.8 | 39.1 | 54.4 |
💻 Usage Examples
Basic Usage with Transformers
from transformers import AutoModelForCausalLM, AutoTokenizer

# Load model and tokenizer
model = AutoModelForCausalLM.from_pretrained("SVECTOR-CORPORATION/Spec-T1-RL-7B")
tokenizer = AutoTokenizer.from_pretrained("SVECTOR-CORPORATION/Spec-T1-RL-7B")

# Mathematical reasoning example
prompt = """
Prove: The sum of the first n odd numbers is n^2.
"""

inputs = tokenizer(prompt, return_tensors="pt").to("cuda")
outputs = model.generate(inputs, max_new_tokens=512)
print(tokenizer.decode(outputs[0], skip_special_tokens=True))
Advanced Usage with Generation Parameters
# Algorithm design example
prompt = """
Design an efficient algorithm to find the longest increasing subsequence in an array of integers.
"""

# Configure generation parameters for better reasoning
inputs = tokenizer(prompt, return_tensors="pt").to("cuda")
outputs = model.generate(
    inputs,
    max_new_tokens=1024,
    temperature=0.1,
    top_p=0.95,
    do_sample=True,
    num_return_sequences=1,
    repetition_penalty=1.1
)

print(tokenizer.decode(outputs[0], skip_special_tokens=True))
Code Generation Example
# Code generation example
prompt = """
Write a Python function that implements the A* search algorithm for pathfinding.
"""

inputs = tokenizer(prompt, return_tensors="pt").to("cuda")
outputs = model.generate(
    inputs,
    max_new_tokens=2048,
    temperature=0.2,
    top_p=0.9,
    do_sample=True
)

print(tokenizer.decode(outputs[0], skip_special_tokens=True))
🚀 Deployment
Spec-T1-RL-7B can be deployed on consumer hardware due to its efficient architecture and parameter count:
Minimum Requirements
- 16GB VRAM (bfloat16/float16)
- 32GB system RAM
- CUDA-compatible GPU
Recommended Configuration
- 24GB+ VRAM for optimal performance
- 64GB+ system RAM for long-context applications
- NVIDIA A10 or better
📝 Citation
If you use Spec-T1-RL-7B in your research, please cite:
@misc{svector2025spect1,
  title={Spec-T1-RL-7B: Structured Reasoning through Reinforcement Alignment},
  author={SVECTOR Team},
  year={2025},
}
📄 License
Spec-T1-RL-7B is released under the MIT License.
📬 Contact
For questions, feedback, or collaboration inquiries, please contact:
- Email: research@svector.co.in
- X: @SVECTOR_
- GitHub: SVECTOR-CORPORATION