/ Модель

Характеристики

Контекст
2 048 токенов
Размер весов
63,3 ГБ
Лицензия
Своя лицензия
Архитектура
instructblip · dense
Опубликована
22 мая 2023

instructblip-vicuna-7b

Изображение и текст → текст3 профессии

Визуально-языковая модель InstructBLIP с Vicuna-7B отвечает на текстовые инструкции по изображениям и описывает их содержимое.

15 297скачиваний за 30 дней102лайкавеса обновлены3 фев 2025

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Тесты пользователейпока нет

Никто ещё не опубликовал тест этой модели. Соберите бенчмарк из своих задач — результат появится здесь.

  1. Добавьте модель в бенчмарк

    Вместе с другими моделями категории «Изображение → текст» — сравнение идёт внутри одной категории.

  2. Опишите свои задачи

    Напишите запросы, при необходимости приложите файлы и эталонные ответы.

  3. Запустите и опубликуйте

    Модели ответят на каждую задачу, судья оценит ответы. Опубликованный результат появится на этой странице.

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

Salesforce/InstructBLIP-Vicuna-7B — визуально-языковая модель семейства InstructBLIP, разработанная Salesforce и основанная на BLIP-2 с языковой моделью Vicuna-7B. Она принимает изображение и текстовую инструкцию, а затем генерирует текстовый ответ о содержимом изображения.

Модель предназначена для ответов на вопросы по изображениям, описания сцен и других задач взаимодействия с изображениями на естественном языке. В репозитории представлены веса PyTorch и Safetensors; поддерживаемый язык карточки — английский. README указывает на исследовательский выпуск и рекомендует оценивать точность, безопасность и справедливость перед применением. Лицензия в метаданных обозначена как other, поэтому конкретные условия использования по доступным данным определить нельзя.

Сценарии применения

  • ответы на вопросы о содержимом изображения
  • описание объектов и сцен на изображении
  • объяснение визуальной информации по текстовой инструкции

Ограничения

Модель может ошибаться в описании изображений; перед применением следует оценить её точность, безопасность и справедливость для конкретного сценария. Метаданные указывают лицензию как other, без конкретизации условий.

Для каких профессий подходит3

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

InstructBLIP model

InstructBLIP model using Vicuna-7b as language model. InstructBLIP was introduced in the paper InstructBLIP: Towards General-purpose Vision-Language Models with Instruction Tuning by Dai et al.

Disclaimer: The team releasing InstructBLIP did not write a model card for this model so this model card has been written by the Hugging Face team.

Model description

InstructBLIP is a visual instruction tuned version of BLIP-2. Refer to the paper for details.
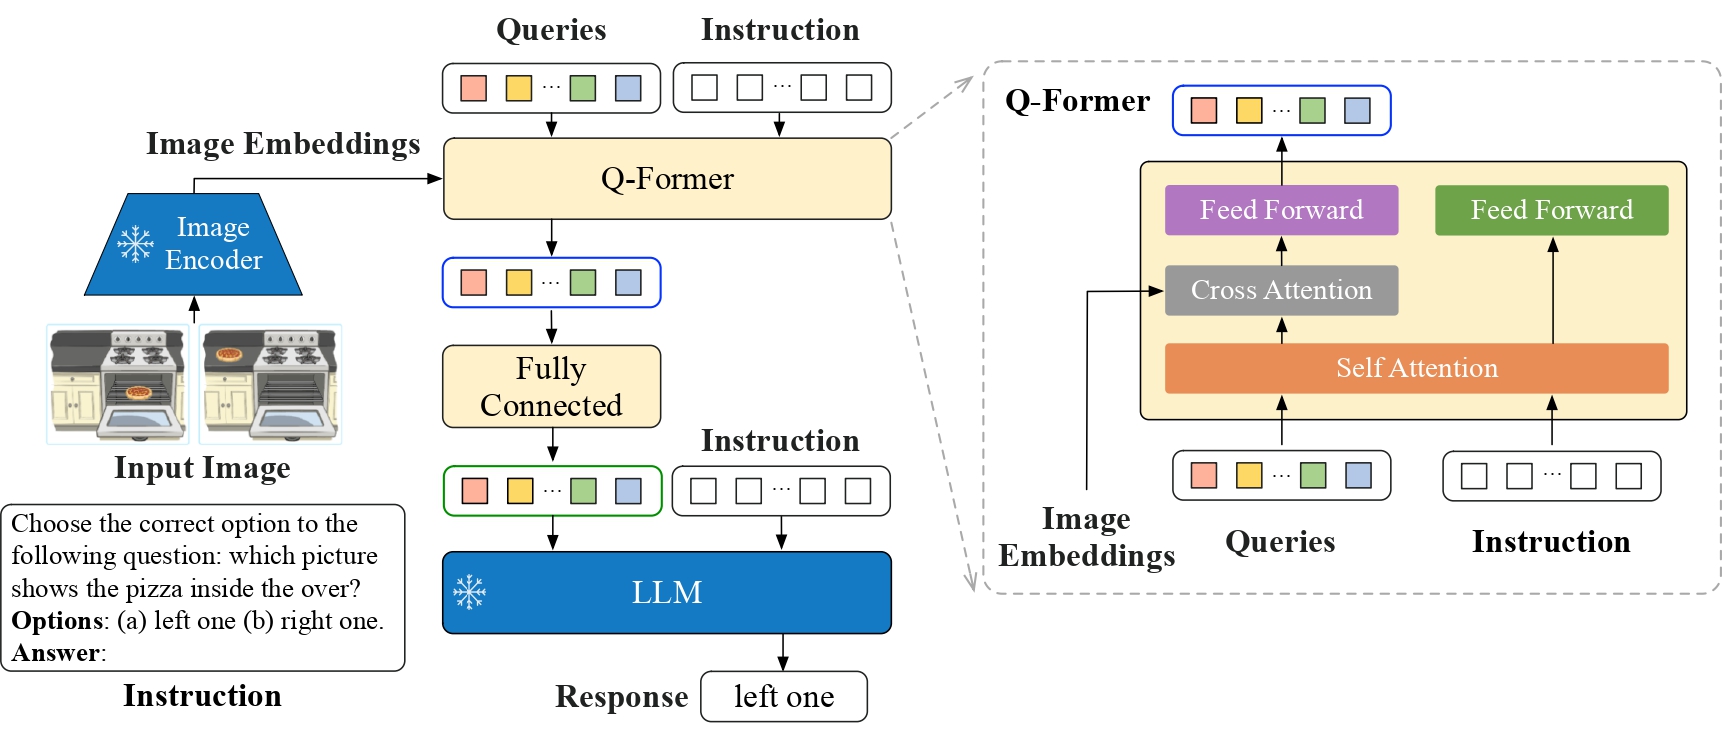
InstructBLIP architecture

Intended uses & limitations

Usage is as follows:

from transformers import InstructBlipProcessor, InstructBlipForConditionalGeneration
import torch
from PIL import Image
import requests

model = InstructBlipForConditionalGeneration.from_pretrained("Salesforce/instructblip-vicuna-7b")
processor = InstructBlipProcessor.from_pretrained("Salesforce/instructblip-vicuna-7b")

device = "cuda" if torch.cuda.is_available() else "cpu"
model.to(device)

url = "https://raw.githubusercontent.com/salesforce/LAVIS/main/docs/_static/Confusing-Pictures.jpg"
image = Image.open(requests.get(url, stream=True).raw).convert("RGB")
prompt = "What is unusual about this image?"
inputs = processor(images=image, text=prompt, return_tensors="pt").to(device)

outputs = model.generate(
        **inputs,
        do_sample=False,
        num_beams=5,
        max_length=256,
        min_length=1,
        top_p=0.9,
        repetition_penalty=1.5,
        length_penalty=1.0,
        temperature=1,
)
generated_text = processor.batch_decode(outputs, skip_special_tokens=True)[0].strip()
print(generated_text)

Ethical Considerations

This release is for research purposes only in support of an academic paper. Our models, datasets, and code are not specifically designed or evaluated for all downstream purposes. We strongly recommend users evaluate and address potential concerns related to accuracy, safety, and fairness before deploying this model. We encourage users to consider the common limitations of AI, comply with applicable laws, and leverage best practices when selecting use cases, particularly for high-risk scenarios where errors or misuse could significantly impact people’s lives, rights, or safety. For further guidance on use cases, refer to our AUP and AI AUP.

How to use

For code examples, we refer to the documentation.

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм

Можно запустить

Подбираем GPU…

Класс архитектуры
InstructBlipForConditionalGeneration
Ревизия весов
19103d0

0 моделей