/ Модель

Характеристики

Контекст
16 384 токена
Параметры
10,6 млрд
Размер весов
21,5 ГБ
Лицензия
CC BY-NC 4.0
Архитектура
llama · dense
Опубликована
25 июн 2024

Fimbulvetr-11B-v2.1-16K

Генерация текстаТекст → текст5 профессий

Дообученная модель семейства Llama с контекстом до 16 тысяч токенов для генерации текста, диалогов и ролевых сценариев.

83скачиваний за 30 дней17лайковвеса обновлены29 июн 2024

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Тесты пользователейпока нет

Никто ещё не опубликовал тест этой модели. Соберите бенчмарк из своих задач — результат появится здесь.

  1. Добавьте модель в бенчмарк

    Вместе с другими моделями категории «Текст» — сравнение идёт внутри одной категории.

  2. Опишите свои задачи

    Напишите запросы, при необходимости приложите файлы и эталонные ответы.

  3. Запустите и опубликуйте

    Модели ответят на каждую задачу, судья оценит ответы. Опубликованный результат появится на этой странице.

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

Sao10K/Fimbulvetr-11B-v2.1-16K — языковая модель, созданная Sao10K на основе Fimbulvetr-v2 и обученная с расширенным контекстом с помощью PoSE. Это плотная авторегрессионная модель семейства Llama с 10,6 млрд параметров, рассчитанная на генерацию текста; в карточке указан английский язык. Модель заявлена для контекста до 16 384 токенов, однако автор рекомендует использовать около 12 тысяч токенов: на длинных входах качество и надёжность снижаются.

Модель подходит для диалогов и ролевых сценариев, а также для генерации связного текста с длинным контекстом. Автор отмечает, что ответы обычно надёжны примерно до 11 тысяч токенов, а на 16 тысячах модель остаётся связной, но хуже справляется с детальными задачами. Иногда возникают ошибки форматирования; при квантизации до 8 бит и ниже пользователи сообщали о проблемах. Модель доступна под лицензией CC BY-NC 4.0, которая ограничивает коммерческое использование.

Сценарии применения

  • генерация диалогов с длинной историей
  • ролевая переписка с большим контекстом
  • создание художественного текста
  • ответы на вопросы по длинному текстовому контексту

Ограничения

Автор рекомендует ограничивать контекст примерно 12 тысячами токенов: на 16 тысячах качество детальных ответов снижается. Иногда возникают ошибки форматирования, а при квантизации до 8 бит и ниже отмечались проблемы.

Для каких профессий подходит5

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Также подходит для

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

Trained with compute from Backyard.ai | Thanks to them and @dynafire for helping me out.


Fimbulvetr-v2 but extended to 16K with PoSE. A sane context value would be ~12K before it degrades.

Note: - I left Rope Theta at 10K for this train, instead of expanding it like with Stheno 3.3. Solar did not play well with extended theta, grad norm / loss values went parabolic or plunged from 10000+ down. Unreliable pretty much, unlike Stheno 3.3's training run.


Notes: - I noticed people having bad issues with quants. Be it GGUF or others, at 8 bit or less. Kind of a weird issue? I had little to no issues during testing unquanted. - Slightly different results from base Fimbulvetr-v2, but during my tests they are similar enough. The vibes are still there. - Formatting issues happen rarely. Sometimes. A reroll / regenerate fixes it from tests. - I get consistent and reliable answers at ~11K context fine. - Still coherent at up to 16K though! Just works not that well.

I recommend sticking up to 12K context, but loading the model at 16K for inference. It has a really accurate context up to 10K from multiple different extended long context tests. 16K works fine for roleplays, but not for more detailed tasks.
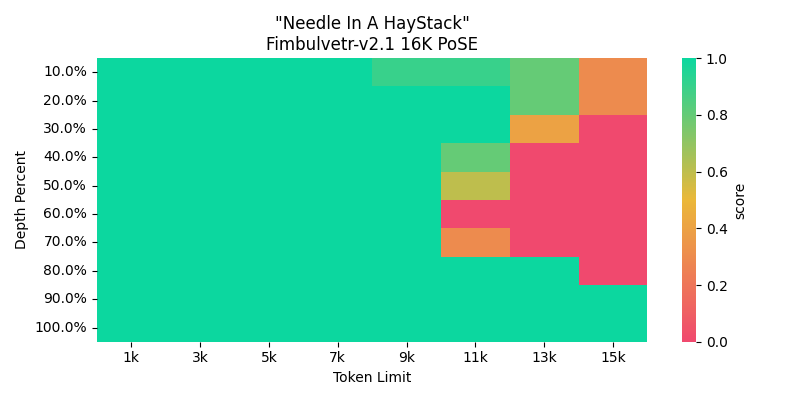
Needle

Red Needle in Haystack testing results for this specific one are usually due to weird result artifacts, like the model answering part of the key, or commenting extra. Basically, they got the result, but it's incomplete or there's additional stuff taken. Something like ' 3211' or '3211 and' instead of '321142'. Weird. Hence why its coherent and semi-reliable for roleplays at 16K context.

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм

Можно запустить

Подбираем GPU…

Класс архитектуры
LlamaForCausalLM
Ревизия весов
24fc6a3

0 моделей