/ Модель

Характеристики

Контекст
131 072 токена
Параметры
7,5 млрд
Размер весов
16,1 ГБ
Лицензия
CC BY-NC 4.0
Архитектура
llama · dense
Опубликована
19 авг 2024

Llama-3.1-8B-Stheno-v3.4

Генерация текстаТекст → текст6 профессий

Дообученная англоязычная модель Llama 3.1 для диалогов, инструкций, ролевых сценариев и творческого письма.

585скачиваний за 30 дней103лайкавеса обновлены19 авг 2024

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Тесты пользователейпока нет

Никто ещё не опубликовал тест этой модели. Соберите бенчмарк из своих задач — результат появится здесь.

  1. Добавьте модель в бенчмарк

    Вместе с другими моделями категории «Текст» — сравнение идёт внутри одной категории.

  2. Опишите свои задачи

    Напишите запросы, при необходимости приложите файлы и эталонные ответы.

  3. Запустите и опубликуйте

    Модели ответят на каждую задачу, судья оценит ответы. Опубликованный результат появится на этой странице.

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

Stheno v3.4 — языковая модель на архитектуре Llama 3.1, разработанная Sao10K и обученная при поддержке Backyard.ai. Модель прошла многоэтапное дообучение: сначала на многоходовых диалогах и инструкциях, затем на наборах для творческого письма, ролевых сценариев и творческих инструкций. В обучающих данных использовались материалы людей и Claude.

Модель предназначена для диалогов, следования инструкциям, ролевых сценариев и создания художественного текста. Это плотная авторегрессионная модель с 7,5 млрд параметров и контекстом до 131 072 токенов; метаданные указывают английский язык. Доступны веса в формате safetensors, а лицензия CC BY-NC 4.0 ограничивает коммерческое использование.

Сценарии применения

  • многоходовые диалоги на английском языке
  • выполнение текстовых инструкций
  • создание художественных рассказов
  • ролевые диалоги с персонажами
  • генерация творческих ответов в чате

Ограничения

Лицензия CC BY-NC 4.0 запрещает коммерческое использование. Оценки качества и сведения о конкретных ограничениях модели в доступных материалах не приведены.

Для каких профессий подходит6

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Также подходит для

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

img


Thanks to Backyard.ai for the compute to train this. :)


Llama-3.1-8B-Stheno-v3.4

This model has went through a multi-stage finetuning process.

- 1st, over a multi-turn Conversational-Instruct
- 2nd, over a Creative Writing / Roleplay along with some Creative-based Instruct Datasets.
- - Dataset consists of a mixture of Human and Claude Data.

Prompting Format:

- Use the L3 Instruct Formatting - Euryale 2.1 Preset Works Well
- Temperature + min_p as per usual, I recommend 1.4 Temp + 0.2 min_p.
- Has a different vibe to previous versions. Tinker around.

Changes since previous Stheno Datasets:

- Included Multi-turn Conversation-based Instruct Datasets to boost multi-turn coherency. # This is a seperate set, not the ones made by Kalomaze and Nopm, that are used in Magnum. They're completely different data.
- Replaced Single-Turn Instruct with Better Prompts and Answers by Claude 3.5 Sonnet and Claude 3 Opus.
- Removed c2 Samples -> Underway of re-filtering and masking to use with custom prefills. TBD
- Included 55% more Roleplaying Examples based of [Gryphe's](https://huggingface.co/datasets/Gryphe/Sonnet3.5-Charcard-Roleplay) Charcard RP Sets. Further filtered and cleaned on.
- Included 40% More Creative Writing Examples.
- Included Datasets Targeting System Prompt Adherence.
- Included Datasets targeting Reasoning / Spatial Awareness.
- Filtered for the usual errors, slop and stuff at the end. Some may have slipped through, but I removed nearly all of it.

Personal Opinions:

- Llama3.1 was more disappointing, in the Instruct Tune? It felt overbaked, atleast. Likely due to the DPO being done after their SFT Stage.
- Tuning on L3.1 base did not give good results, unlike when I tested with Nemo base. unfortunate.
- Still though, I think I did an okay job. It does feel a bit more distinctive.
- It took a lot of tinkering, like a LOT to wrangle this.

Below are some graphs and all for you to observe.


Turn Distribution # 1 Turn is considered as 1 combined Human/GPT pair in a ShareGPT format. 4 Turns means 1 System Row + 8 Human/GPT rows in total.
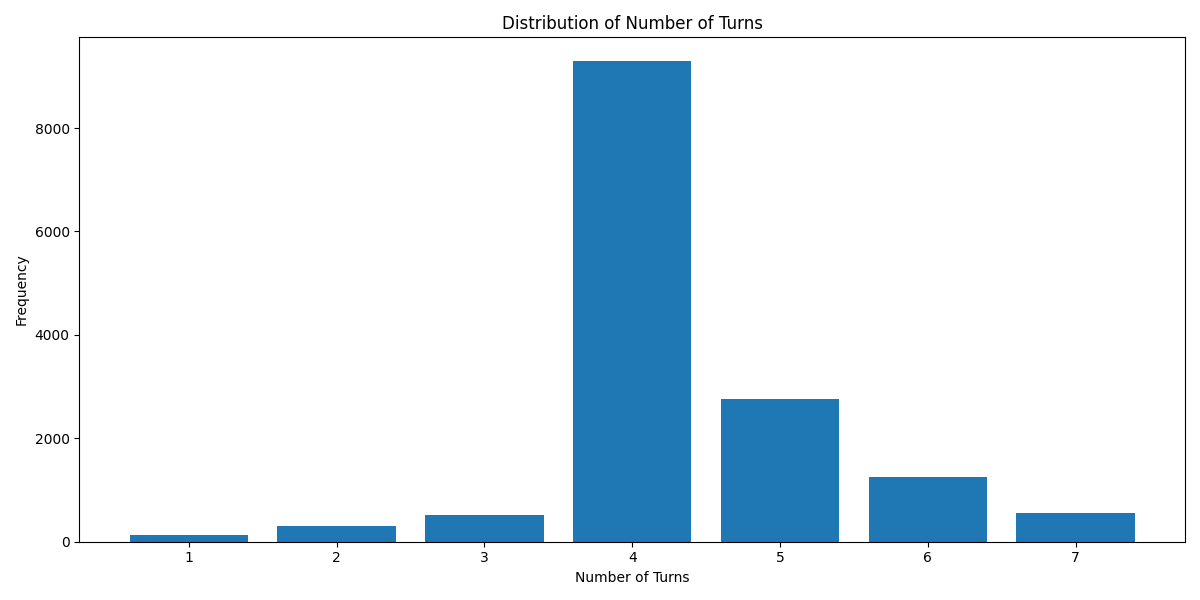
Turn

Token Count Histogram # Based on the Llama 3 Tokenizer
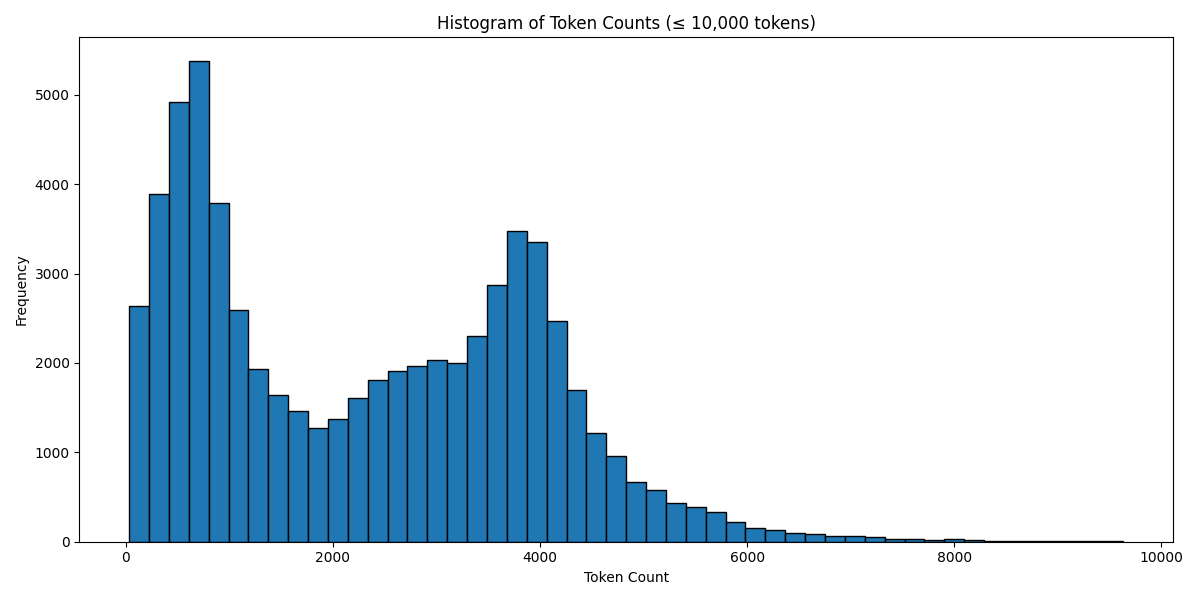
Turn


Have a good one.

Source Image: https://www.pixiv.net/en/artworks/91689070

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм

Можно запустить

Подбираем GPU…

Класс архитектуры
LlamaForCausalLM
Ревизия весов
423b189

0 моделей