/ Модель

Характеристики

Контекст
512 токенов
Параметры
131 млн
Архитектура
bert · dense
Опубликована
2 мар 2022

ChineseBERT-base

Заполнение пропусковТекст → текст3 профессии

Китайская BERT-модель с признаками начертания и пиньиня для восстановления замаскированных символов и анализа китайского текста.

292скачиваний за 30 дней26лайковвеса обновлены19 июн 2022

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

ChineseBERT-base — китайская языковая модель на архитектуре BERT, разработанная командой авторов статьи ChineseBERT на ACL 2021. Она объединяет обычные символьные эмбеддинги с визуальными признаками начертания и фонетическими признаками пиньиня, чтобы лучше учитывать форму китайских иероглифов и различать многозвучные символы. В репозитории представлена версия для заполнения маски; модель насчитывает 131,1 млн параметров и поддерживает контекст до 512 токенов.

Модель подходит для восстановления скрытых фрагментов китайского текста и как основа для задач понимания китайского языка. Карточка не сообщает лицензию, поэтому условия использования следует проверить в репозитории. Она принимает текст, а выдаёт распределение вероятностей токенов для маскированной позиции; заявленная специализация — китайский язык.

Сценарии применения

  • восстановление пропущенных иероглифов в китайском тексте
  • предсказание замаскированного токена в китайском предложении
  • получение контекстных представлений китайских символов
  • различение многозвучных китайских иероглифов по контексту

Ограничения

Поддерживает контекст до 512 токенов и ориентирована на китайский язык. Лицензия в предоставленных материалах не указана.

Для каких профессий подходит3

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

ChineseBERT-base

This repository contains code, model, dataset for ChineseBERT at ACL2021.

paper:
ChineseBERT: Chinese Pretraining Enhanced by Glyph and Pinyin Information
Zijun Sun, Xiaoya Li, Xiaofei Sun, Yuxian Meng, Xiang Ao, Qing He, Fei Wu and Jiwei Li

code:
ChineseBERT github link

Model description

We propose ChineseBERT, which incorporates both the glyph and pinyin information of Chinese characters into language model pretraining.

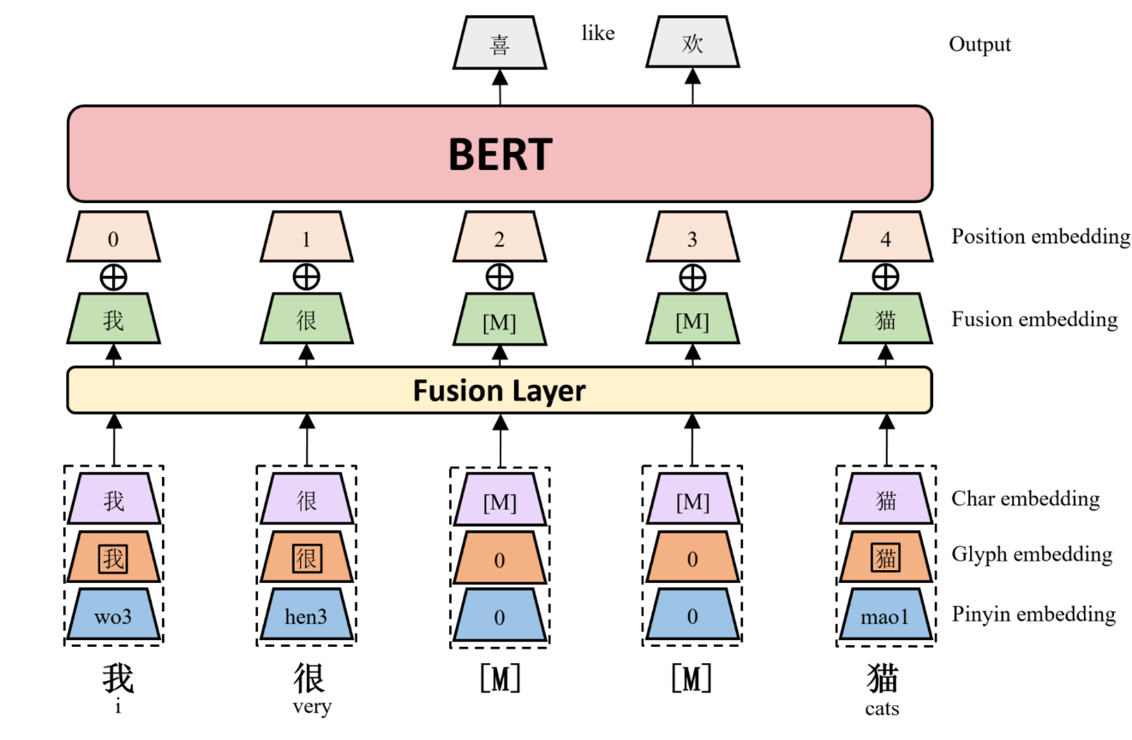
First, for each Chinese character, we get three kind of embedding.

  • Char Embedding: the same as origin BERT token embedding.
  • Glyph Embedding: capture visual features based on different fonts of a Chinese character.
  • Pinyin Embedding: capture phonetic feature from the pinyin sequence ot a Chinese Character.

Then, char embedding, glyph embedding and pinyin embedding are first concatenated, and mapped to a D-dimensional embedding through a fully connected layer to form the fusion embedding.
Finally, the fusion embedding is added with the position embedding, which is fed as input to the BERT model.
The following image shows an overview architecture of ChineseBERT model.
MODEL

ChineseBERT leverages the glyph and pinyin information of Chinese characters to enhance the model's ability of capturing context semantics from surface character forms and disambiguating polyphonic characters in Chinese.

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм · fill-mask

Можно запустить

Подбираем GPU…

Класс архитектуры
GlyceBertForMaskedLM
Ревизия весов
aa8b6fa

0 моделей