/ Модель

Характеристики

Контекст
512 токенов
Параметры
426 млн
Архитектура
bert · dense
Опубликована
2 мар 2022

ChineseBERT-large

Заполнение пропусковТекст → текст3 профессии

Крупная китайская BERT-модель, учитывающая начертание и пиньинь и предназначенная для языкового моделирования с заполнением пропусков.

93скачиваний за 30 дней6лайковвеса обновлены19 июн 2022

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

ChineseBERT-large — крупная модель семейства BERT от команды ShannonAI, представленная в работе ACL 2021. При предобучении она объединяет обычные эмбеддинги китайских иероглифов с признаками их визуального начертания в разных шрифтах и произношения в пиньине, после чего подаёт объединённое представление в BERT. Такой подход предназначен для улучшения понимания контекста по форме китайских символов и различения омографов с разным произношением.

В репозитории указаны веса PyTorch класса GlyceBertForMaskedLM с 426,4 млн параметров и контекстом до 512 токенов. Модель подходит как основа для заполнения пропусков и других задач понимания китайского текста с последующей адаптацией. README не сообщает условия лицензии, поэтому их нельзя уточнить по доступным данным.

Сценарии применения

  • восстановление пропущенных иероглифов в китайском тексте
  • оценка контекстно подходящего китайского символа
  • адаптация модели для задач понимания китайского языка
  • различение китайских омографов по контексту и произношению

Ограничения

Контекст ограничен 512 токенами. README и метаданные не содержат сведений о лицензии или оценках качества модели.

Для каких профессий подходит3

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

ChineseBERT-large

This repository contains code, model, dataset for ChineseBERT at ACL2021.

paper:
ChineseBERT: Chinese Pretraining Enhanced by Glyph and Pinyin Information
Zijun Sun, Xiaoya Li, Xiaofei Sun, Yuxian Meng, Xiang Ao, Qing He, Fei Wu and Jiwei Li

code:
ChineseBERT github link

Model description

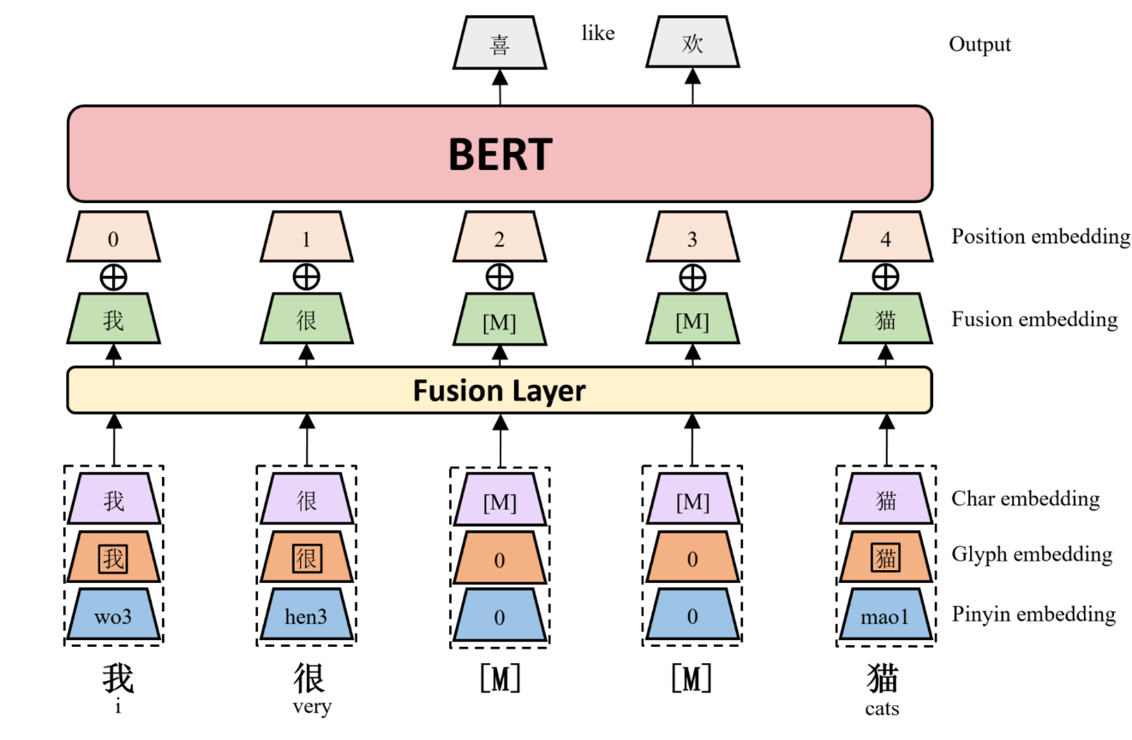
We propose ChineseBERT, which incorporates both the glyph and pinyin information of Chinese characters into language model pretraining.

First, for each Chinese character, we get three kind of embedding.

  • Char Embedding: the same as origin BERT token embedding.
  • Glyph Embedding: capture visual features based on different fonts of a Chinese character.
  • Pinyin Embedding: capture phonetic feature from the pinyin sequence ot a Chinese Character.

Then, char embedding, glyph embedding and pinyin embedding are first concatenated, and mapped to a D-dimensional embedding through a fully connected layer to form the fusion embedding.
Finally, the fusion embedding is added with the position embedding, which is fed as input to the BERT model.
The following image shows an overview architecture of ChineseBERT model.
MODEL

ChineseBERT leverages the glyph and pinyin information of Chinese characters to enhance the model's ability of capturing context semantics from surface character forms and disambiguating polyphonic characters in Chinese.

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм · fill-mask

Можно запустить

Подбираем GPU…

Класс архитектуры
GlyceBertForMaskedLM
Ревизия весов
2099e31

0 моделей