/ Модель

Характеристики

Контекст
32 768 токенов
Параметры
7,1 млрд
Размер весов
28,3 ГБ
Лицензия
Apache 2.0
Архитектура
qwen2 · dense
Базовая модель
Qwen2-7B-Instruct
Опубликована
22 окт 2024

ChatTCM-7B-Pretrain

Генерация текстаТекст → текст3 профессии

ChatTCM-7B-Pretrain — дообученная на материалах традиционной китайской медицины языковая модель для диалогов и генерации тематических текстов на китайском языке.

31скачиваний за 30 дней6лайковвеса обновлены2 авг 2026

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Тесты пользователейпока нет

Никто ещё не опубликовал тест этой модели. Соберите бенчмарк из своих задач — результат появится здесь.

  1. Добавьте модель в бенчмарк

    Вместе с другими моделями категории «Текст» — сравнение идёт внутри одной категории.

  2. Опишите свои задачи

    Напишите запросы, при необходимости приложите файлы и эталонные ответы.

  3. Запустите и опубликуйте

    Модели ответят на каждую задачу, судья оценит ответы. Опубликованный результат появится на этой странице.

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

SylvanL разработал ChatTCM-7B-Pretrain — языковую модель для генерации текста на основе Qwen2-7B-Instruct. Модель содержит 7,1 млрд параметров, использует архитектуру Qwen2 и принимает контекст длиной до 32 768 токенов. Её продолжили предварительно обучать в течение двух эпох на наборе Traditional-Chinese-Medicine-Dataset-Pretrain с помощью LLaMA Factory.

Модель сохраняет общие возможности исходной модели и лучше ориентируется в материалах традиционной китайской медицины. Она предназначена для диалоговых сценариев и генерации текстов, связанных с медицинскими опросниками, рецептами, диагнозами, историями болезни, учебниками и классическими текстами, лекарственными средствами, травами, формулами, терминами, заболеваниями, симптомами и диетотерапией. Основной язык карточки — китайский.

Модель опубликована в формате safetensors под лицензией Apache-2.0. Это языковая модель, а не проверенный медицинский инструмент: ответы о здоровье следует сверять со специалистом, особенно перед постановкой диагноза или назначением лечения.

Сценарии применения

  • ответы на вопросы о традиционной китайской медицине
  • составление и разбор текстов медицинских опросников и историй болезни
  • генерация текстов рецептов и описаний диагнозов
  • поиск сведений о китайских лекарственных средствах и травах
  • объяснение терминов, симптомов и заболеваний традиционной китайской медицины
  • обсуждение классических текстов и учебных материалов по китайской медицине

Ограничения

Карточка не приводит клинических оценок или подтверждений пригодности для диагностики и лечения; медицинские ответы требуют проверки специалистом. Основной заявленный языковой фокус — китайский.

Для каких профессий подходит3

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

国内首个从数据集到训练方式到模型权重完全开源的中医大模型.


在2张A800-80G上,

基于Qwen/Qwen2-7B-Instruct, 在llamafactory框架上,

使用SylvanL/Traditional-Chinese-Medicine-Dataset-Pretrain进行了2个epoch的继续预训练(Continue Pre-train).

在保留模型原有通用能力的前提下,使模型熟悉、记住,并更倾向于输出以下内容:

  1. 中医问诊单、处方笺、医生诊断及多种格式的病案、医案内容
  2. 中医领域教材与典籍
  3. 中成药、中药材、中医方剂、中医术语、中医疾病、中医症状、药膳食疗相关的知识点
epoch 1: 
{
    "num_input_tokens_seen": 442925056,
    "total_flos": 885678736932864.0,
    "train_loss": 1.658593576353242,
    "train_runtime": 133293.1729,
    "train_samples_per_second": 3.246,
    "train_steps_per_second": 0.014
}
average_perplexity: 7.2646328377141005

epoch 2:
{
    "num_input_tokens_seen": 442925056,
    "total_flos": 885678736932864.0,
    "train_loss": 1.3894652060929016,
    "train_runtime": 139124.2076,
    "train_samples_per_second": 3.11,
    "train_steps_per_second": 0.014
}
average_perplexity: 5.800355962033688
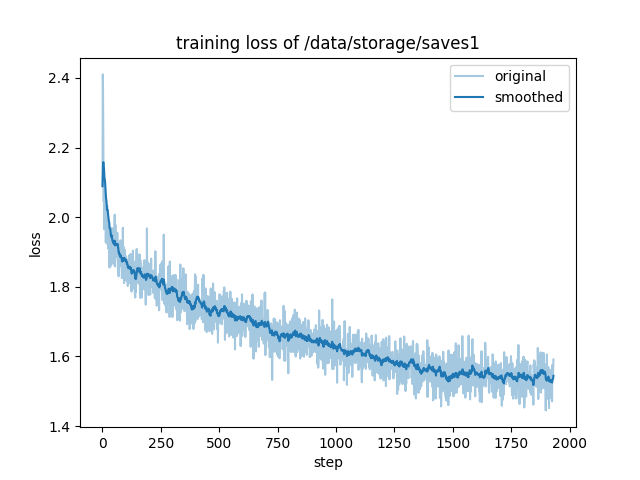
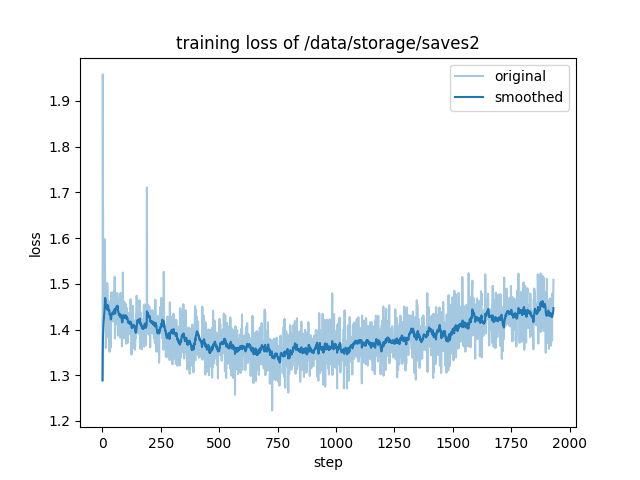
image/png image/png


llamafactory-cli train \
    --stage pt \
    --do_train True \
    --model_name_or_path Qwen/Qwen2-7B-Instruct \
    --preprocessing_num_workers 16 \
    --finetuning_type full \
    --template default \
    --flash_attn auto \
    --dataset_dir {dataset_dir} \
    --dataset CPT_generalMedical_362420,{shibing624/huatuo_medical_qa_sharegpt},CPT_medicalRecord_source1_61486,CPT_medicalRecord_source2_15307,CPT_medicalRecord_source3_230000,CPT_tcmKnowledge_source1_17921,CPT_tcmKnowledge_source2_12889,CPT_tcmBooks_source1_146244 \
    --cutoff_len 1024 \
    --learning_rate 6e-06 \
    --num_train_epochs 2.0 \
    --max_samples 1000000 \
    --per_device_train_batch_size 28 \
    --gradient_accumulation_steps 4 \
    --lr_scheduler_type cosine \
    --max_grad_norm 1.0 \
    --logging_steps 1 \
    --save_steps 1000 \
    --warmup_steps 0 \
    --optim adamw_torch \
    --packing True \
    --report_to none \
    --output_dir {output_dir} \
    --bf16 True \
    --plot_loss True \
    --ddp_timeout 180000000 \
    --include_num_input_tokens_seen True \
    --deepspeed cache/ds_z3_offload_config.json

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм

Можно запустить

Подбираем GPU…

Класс архитектуры
Qwen2Model
Ревизия весов
a325707

0 моделей