/ Модель

Характеристики

Размер весов
14,1 ГБ
Лицензия
Apache 2.0
Архитектура
llava · dense
Базовая модель
llava-1.5-7b-hf
Опубликована
13 апр 2024

Mantis-llava-7b

Изображение и текст → текст3 профессии

Mantis-llava-7b — дообученная мультимодальная модель для диалога и рассуждений по тексту и нескольким изображениям.

96скачиваний за 30 дней16лайковвеса обновлены18 мая 2024

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Тесты пользователейпока нет

Никто ещё не опубликовал тест этой модели. Соберите бенчмарк из своих задач — результат появится здесь.

  1. Добавьте модель в бенчмарк

    Вместе с другими моделями категории «Изображение → текст» — сравнение идёт внутри одной категории.

  2. Опишите свои задачи

    Напишите запросы, при необходимости приложите файлы и эталонные ответы.

  3. Запустите и опубликуйте

    Модели ответят на каждую задачу, судья оценит ответы. Опубликованный результат появится на этой странице.

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

Mantis-llava-7b — мультимодальная разговорная модель TIGER-Lab для ответов на вопросы по изображениям и тексту. Она дообучена на наборе Mantis-Instruct, содержащем примеры вопросов и ответов по нескольким изображениям, и рассчитана на рассуждения по чередующимся изображениям и тексту в одном запросе.

Модель основана на LLaVA-1.5-7B и использует архитектуру LlavaForConditionalGeneration. Она принимает текст и изображения, а ответы формирует текстом; в метаданных указан английский язык. Версия устарела: авторы отмечают, что более новая mantis-Siglip-llama3 лучше справляется как с задачами по нескольким изображениям, так и с одиночными изображениями. Лицензия — Apache-2.0.

Сценарии применения

  • ответы на вопросы о содержимом нескольких изображений
  • сравнение объектов и сцен на разных изображениях
  • анализ последовательности изображений с текстовыми инструкциями
  • диалог по одному изображению
  • мультимодальные вопросы и ответы на английском языке

Ограничения

Это устаревшая версия Mantis; авторы рекомендуют более новую mantis-Siglip-llama3, которая, по их словам, заметно лучше на задачах с одним и несколькими изображениями.

Для каких профессий подходит3

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

Mantis: Interleaved Multi-Image Instruction Tuning (Deprecated)

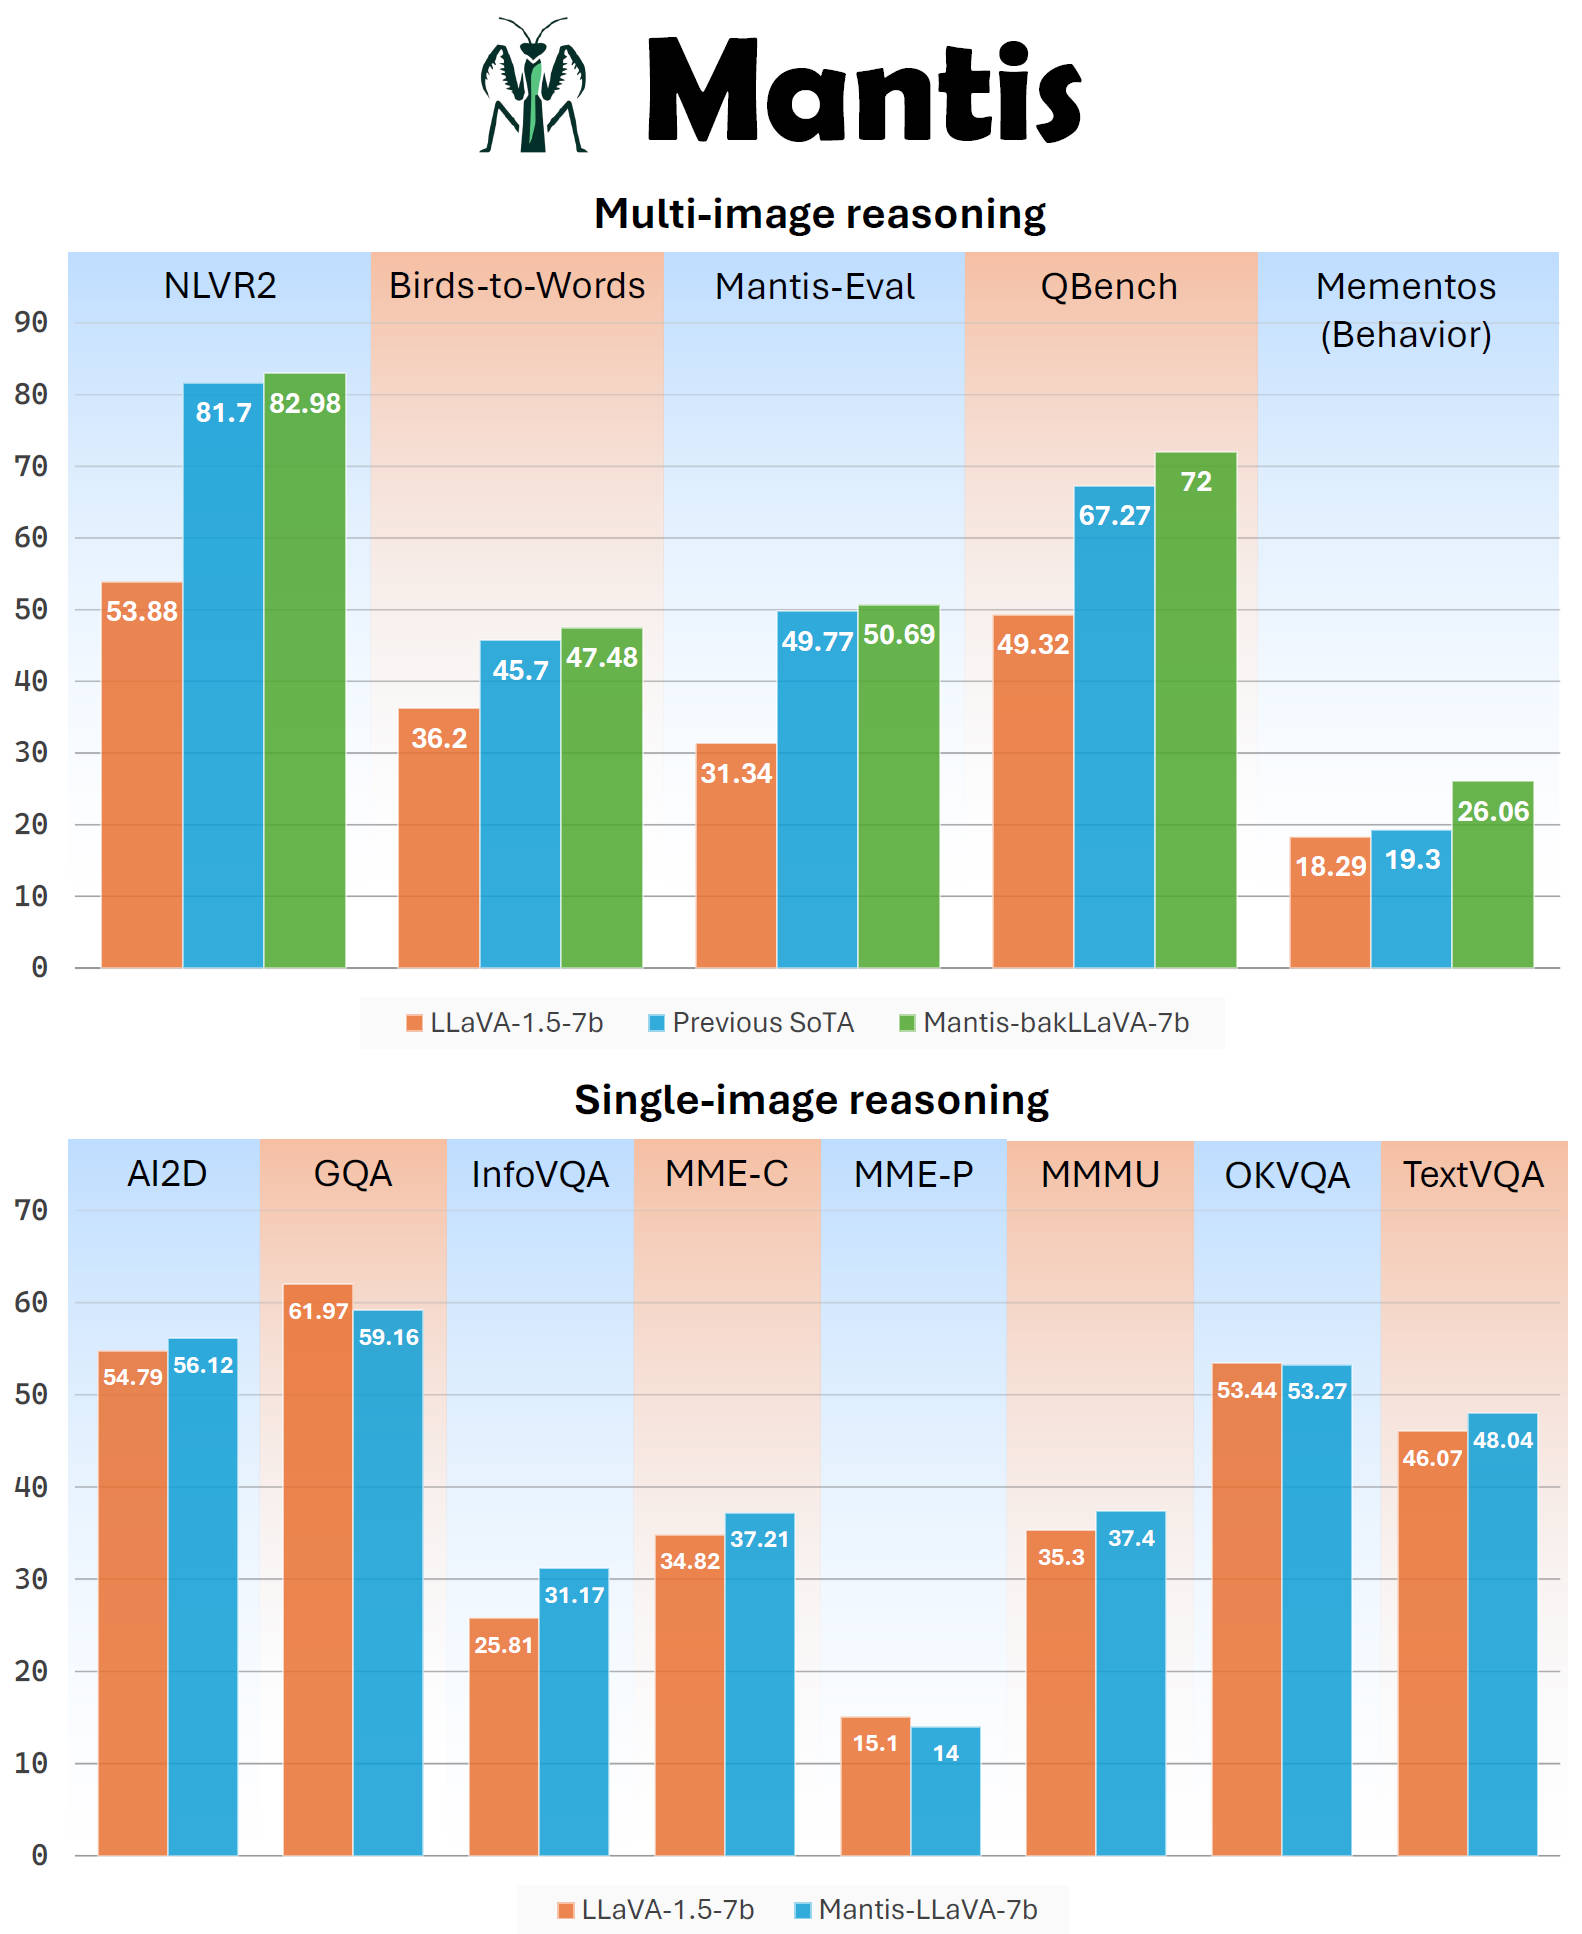
Mantis is a multimodal conversational AI model that can chat with users about images and text. It's optimized for multi-image reasoning, where interleaved text and images can be used to generate responses.

Note that this is an older version of Mantis, please refer to our newest version at mantis-Siglip-llama3. The newer version improves significantly over both multi-image and single-image tasks.

Mantis is trained on the newly curated dataset Mantis-Instruct, a large-scale multi-image QA dataset that covers various multi-image reasoning tasks.
|Demo | Github | Models |

Mantis

Inference

You can install Mantis's GitHub codes as a Python package

pip install git+https://github.com/TIGER-AI-Lab/Mantis.git

then run inference with codes here: examples/run_mantis.py

from mantis.models.mllava import chat_mllava
from PIL import Image
import torch


image1 = "image1.jpg"
image2 = "image2.jpg"
images = [Image.open(image1), Image.open(image2)]

# load processor and model
from mantis.models.mllava import MLlavaProcessor, LlavaForConditionalGeneration
processor = MLlavaProcessor.from_pretrained("TIGER-Lab/Mantis-bakllava-7b")
model = LlavaForConditionalGeneration.from_pretrained("TIGER-Lab/Mantis-bakllava-7b", device_map="auto", torch_dtype=torch.bfloat16, attn_implementation="flash_attention_2")

# chat
text = "<image> <image> What's the difference between these two images? Please describe as much as you can."
response, history = chat_mllava(text, images, model, processor)

print("USER: ", text)
print("ASSISTANT: ", response)
# The image on the right has a larger number of wallets displayed compared to the image on the left. The wallets in the right image are arranged in a grid pattern, while the wallets in the left image are displayed in a more scattered manner. The wallets in the right image have various colors, including red, purple, and brown, while the wallets in the left image are primarily brown.

text = "How many items are there in image 1 and image 2 respectively?"
response, history = chat_mllava(text, images, model, processor, history=history)

print("USER: ", text)
print("ASSISTANT: ", response)
# There are two items in image 1 and four items in image 2.

Or, you can run the model without relying on the mantis codes, using pure hugging face transformers. See examples/run_mantis_hf.py for details.

Training

Training codes will be released soon.

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм

Можно запустить

Подбираем GPU…

Класс архитектуры
LlavaForConditionalGeneration
Ревизия весов
0463319

0 моделей