T2I-Adapter-SDXL - Sketch
T2I Adapter is a network providing additional conditioning to stable diffusion. Each t2i checkpoint takes a different type of conditioning as input and is used with a specific base stable diffusion checkpoint.
This checkpoint provides conditioning on sketch for the StableDiffusionXL checkpoint. This was a collaboration between Tencent ARC and Hugging Face.
Model Details
-
Developed by: T2I-Adapter: Learning Adapters to Dig out More Controllable Ability for Text-to-Image Diffusion Models
-
Model type: Diffusion-based text-to-image generation model
-
Language(s): English
-
License: Apache 2.0
-
Resources for more information: GitHub Repository, Paper.
-
Model complexity: | | SD-V1.4/1.5 | SD-XL | T2I-Adapter | T2I-Adapter-SDXL | | --- | --- |--- |--- |--- | | Parameters | 860M | 2.6B |77 M | 77/79 M | |
-
Cite as:
@misc{ title={T2I-Adapter: Learning Adapters to Dig out More Controllable Ability for Text-to-Image Diffusion Models}, author={Chong Mou, Xintao Wang, Liangbin Xie, Yanze Wu, Jian Zhang, Zhongang Qi, Ying Shan, Xiaohu Qie}, year={2023}, eprint={2302.08453}, archivePrefix={arXiv}, primaryClass={cs.CV} }
Checkpoints
| Model Name | Control Image Overview | Control Image Example | Generated Image Example |
|---|---|---|---|
| TencentARC/t2i-adapter-canny-sdxl-1.0 Trained with canny edge detection | A monochrome image with white edges on a black background. | ||
| TencentARC/t2i-adapter-sketch-sdxl-1.0 Trained with PidiNet edge detection | A hand-drawn monochrome image with white outlines on a black background. | ||
| TencentARC/t2i-adapter-lineart-sdxl-1.0 Trained with lineart edge detection | A hand-drawn monochrome image with white outlines on a black background. | ||
| TencentARC/t2i-adapter-depth-midas-sdxl-1.0 Trained with Midas depth estimation | A grayscale image with black representing deep areas and white representing shallow areas. | ||
| TencentARC/t2i-adapter-depth-zoe-sdxl-1.0 Trained with Zoe depth estimation | A grayscale image with black representing deep areas and white representing shallow areas. | ||
| TencentARC/t2i-adapter-openpose-sdxl-1.0 Trained with OpenPose bone image | A OpenPose bone image. |
Demo:
Try out the model with your own hand-drawn sketches/doodles in the Doodly Space!
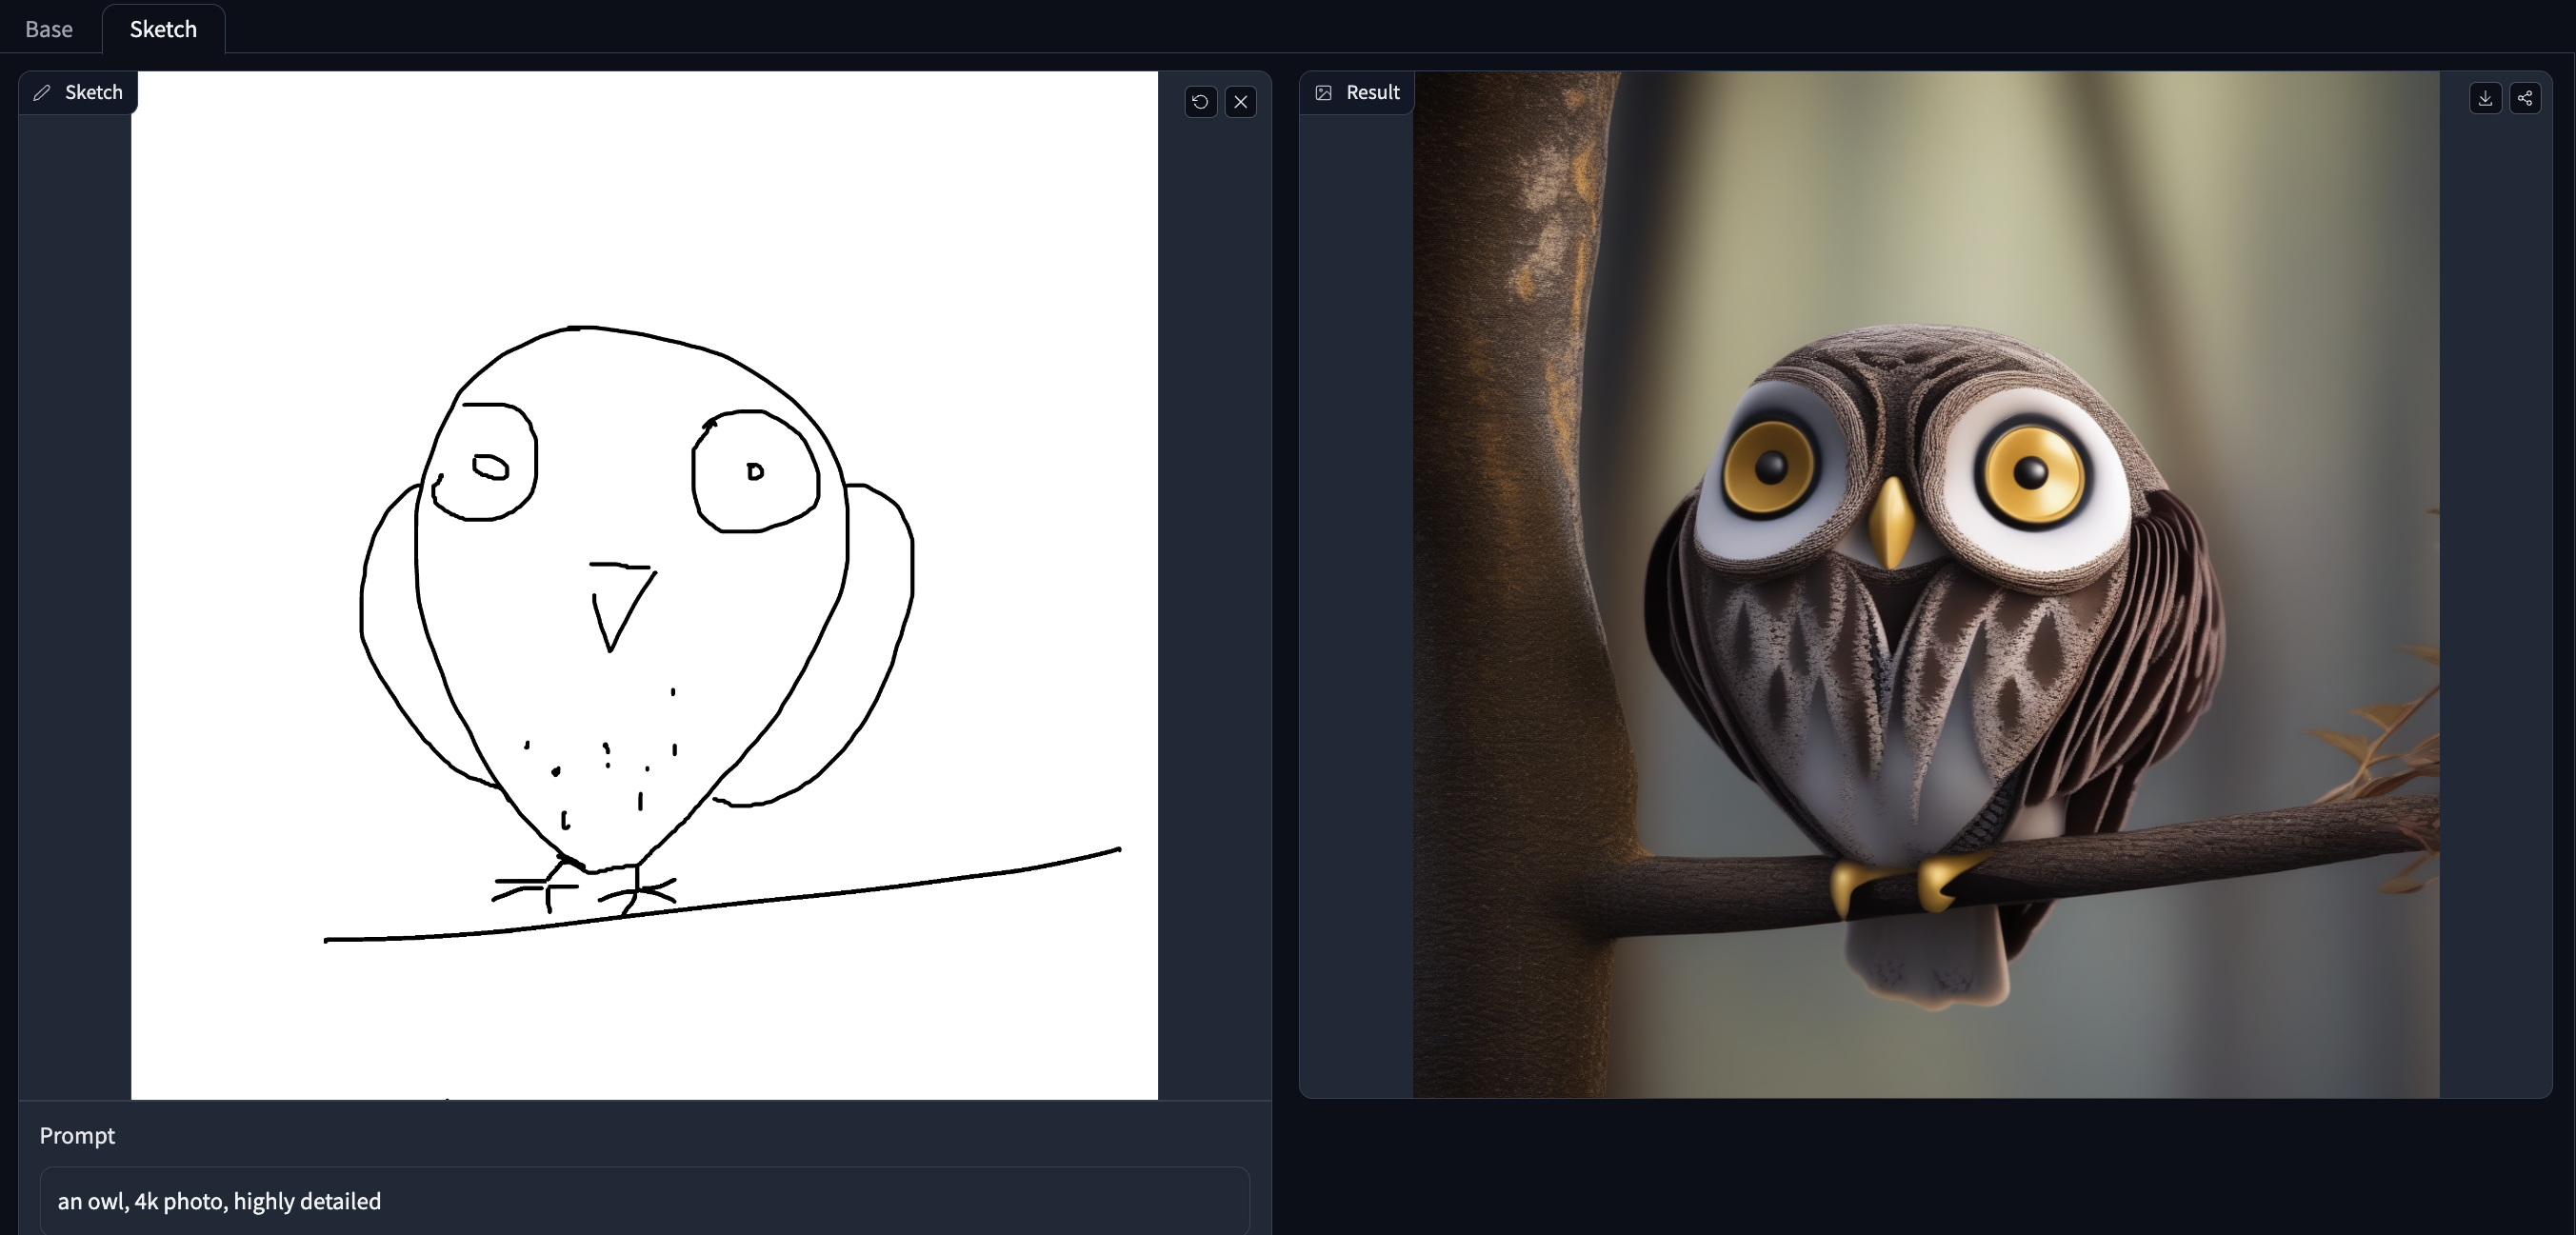
Example
To get started, first install the required dependencies:
pip install -U git+https://github.com/huggingface/diffusers.git
pip install -U controlnet_aux==0.0.7 # for conditioning models and detectors
pip install transformers accelerate safetensors
- Images are first downloaded into the appropriate control image format.
- The control image and prompt are passed to the
StableDiffusionXLAdapterPipeline.
Let's have a look at a simple example using the Canny Adapter.
- Dependency
from diffusers import StableDiffusionXLAdapterPipeline, T2IAdapter, EulerAncestralDiscreteScheduler, AutoencoderKL
from diffusers.utils import load_image, make_image_grid
from controlnet_aux.pidi import PidiNetDetector
import torch

# load adapter
adapter = T2IAdapter.from_pretrained(
  "TencentARC/t2i-adapter-sketch-sdxl-1.0", torch_dtype=torch.float16, varient="fp16"
).to("cuda")

# load euler_a scheduler
model_id = 'stabilityai/stable-diffusion-xl-base-1.0'
euler_a = EulerAncestralDiscreteScheduler.from_pretrained(model_id, subfolder="scheduler")
vae=AutoencoderKL.from_pretrained("madebyollin/sdxl-vae-fp16-fix", torch_dtype=torch.float16)
pipe = StableDiffusionXLAdapterPipeline.from_pretrained(
    model_id, vae=vae, adapter=adapter, scheduler=euler_a, torch_dtype=torch.float16, variant="fp16",
).to("cuda")
pipe.enable_xformers_memory_efficient_attention()

pidinet = PidiNetDetector.from_pretrained("lllyasviel/Annotators").to("cuda")
- Condition Image
url = "https://huggingface.co/Adapter/t2iadapter/resolve/main/figs_SDXLV1.0/org_sketch.png"
image = load_image(url)
image = pidinet(
  image, detect_resolution=1024, image_resolution=1024, apply_filter=True
)
- Generation
prompt = "a robot, mount fuji in the background, 4k photo, highly detailed"
negative_prompt = "extra digit, fewer digits, cropped, worst quality, low quality, glitch, deformed, mutated, ugly, disfigured"

gen_images = pipe(
    prompt=prompt,
    negative_prompt=negative_prompt,
    image=image,
    num_inference_steps=30,
    adapter_conditioning_scale=0.9,
    guidance_scale=7.5,
).images[0]
gen_images.save('out_sketch.png')
Training
Our training script was built on top of the official training script that we provide here.
The model is trained on 3M high-resolution image-text pairs from LAION-Aesthetics V2 with
- Training steps: 20000
- Batch size: Data parallel with a single gpu batch size of
16for a total batch size of256. - Learning rate: Constant learning rate of
1e-5. - Mixed precision: fp16