/ Модель

Характеристики

Лицензия
CreativeML OpenRAIL-M
Опубликована
5 фев 2023

everything-v1

Генерация изображенийТекст → изображение3 профессии

Everything V1 — дообученная на Anything V3 модель Stable Diffusion для генерации изображений в аниме-стиле по текстовым запросам и тегам Danbooru.

88скачиваний за 30 дней12лайковвеса обновлены12 мар 2023

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Тесты пользователейпока нет

Никто ещё не опубликовал тест этой модели. Соберите бенчмарк из своих задач — результат появится здесь.

  1. Добавьте модель в бенчмарк

    Вместе с другими моделями категории «Изображения» — сравнение идёт внутри одной категории.

  2. Опишите свои задачи

    Напишите запросы, при необходимости приложите файлы и эталонные ответы.

  3. Запустите и опубликуйте

    Модели сгенерируют результат по каждой задаче. Опубликованный тест появится на этой странице.

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

Everything V1 — модель генерации изображений на основе Stable Diffusion, дообученная и объединённая разработчиком TheRafal из Anything V3. Она предназначена для создания изображений в аниме-стиле по текстовым запросам и поддерживает теги Danbooru, например для описания внешности персонажей, окружения и сцены. Модель распространяется в форматах Diffusers, PyTorch и Safetensors и может использоваться через Stable Diffusion Pipeline; README также упоминает экспорт в ONNX и MPS.

Карточка указывает лицензию CreativeML OpenRAIL-M. Метаданные отмечают английский язык, но README не описывает языковую специализацию подробнее. Модель ориентирована на создание аниме-изображений; иных характеристик качества или ограничений карточка не раскрывает.

Сценарии применения

  • создание аниме-портретов персонажей по описанию
  • генерация изображений персонажей по тегам Danbooru
  • создание аниме-сцен с заданным окружением и деталями внешности

Ограничения

Карточка не приводит оценок качества, ограничений по промптам или сведений о поведении модели за пределами генерации изображений в аниме-стиле.

Для каких профессий подходит3

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

visitors


Everything V1

Everything V1 is a fine-tuned model based on Anything V3. It was trained using Dreambooth and merged using Merge Block Weighted. Like other anime-style Stable Diffusion models, it also supports danbooru tags to generate images.

e.g. 1girl, white hair, blue eyes, cat ears, outdoors, city


How to download

Batch download

  1. Install Git
  2. Create a folder of your choice and right click → "Git bash here" and open a gitbash on the folder's directory.
  3. Run the following commands in order.
git lfs install
git clone https://huggingface.co/TheRafal/everything-v1
  1. Complete

Select and download

  1. Go to the Files and versions tab
  2. Select the model you want to download
  3. Download
  4. Complete

Diffusers

This model can be used just like any other Stable Diffusion model.

You can also export the model to ONNX or MPS.

import torch
from torch import autocast
from diffusers import StableDiffusionPipeline

pipe = StableDiffusionPipeline.from_pretrained('TheRafal/everything-v1', torch_dtype=torch.float32).to('cuda')

prompt = "masterpiece, 1girl, blonde hair, blue eyes, colorful, cumulonimbus clouds, lighting, short hair, city, hoodie, night"
with autocast("cuda"):
    image = pipe(prompt, num_inference_steps=50, guidance_scale=7.5)["images"][0]  
    
image.save(prompt.replace(" ", "_") + ".png")

Anime Girl: Anime Girl
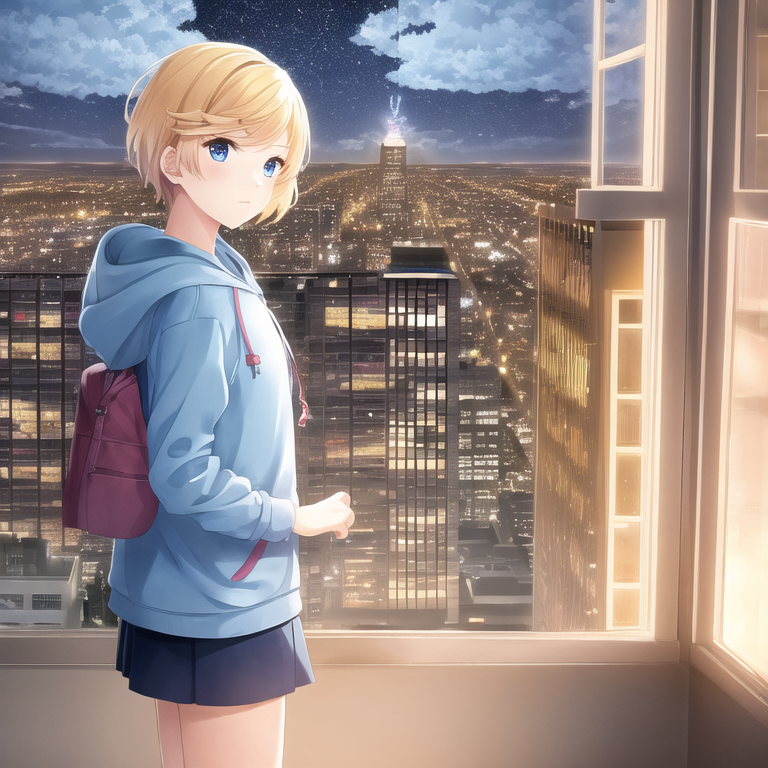

Examples

Below are some examples of images generated using this model:

Anime Girl: Anime Girl
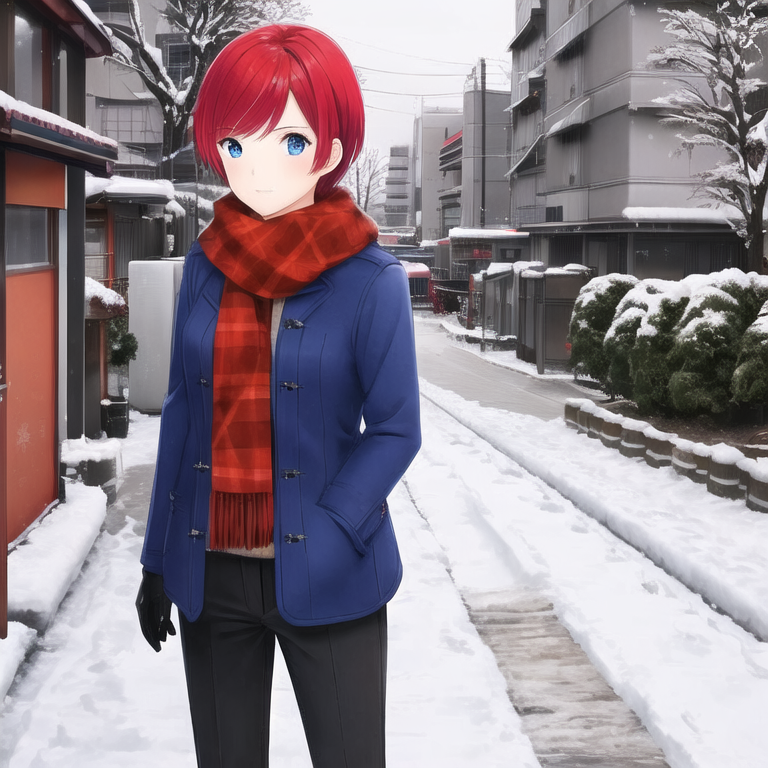
1girl, red hair, blue eyes, short hair, jacket, winter clothes, scarf, outdoors, tokyo \(city\), snow, snowing, gloves, pants, looking at viewer, cowboy shot
Steps: 50, Sampler: DPM++ 2M Karras, CFG scale: 7, Seed: 2436148258, Size: 768x768

Anime Boy: Anime Boy
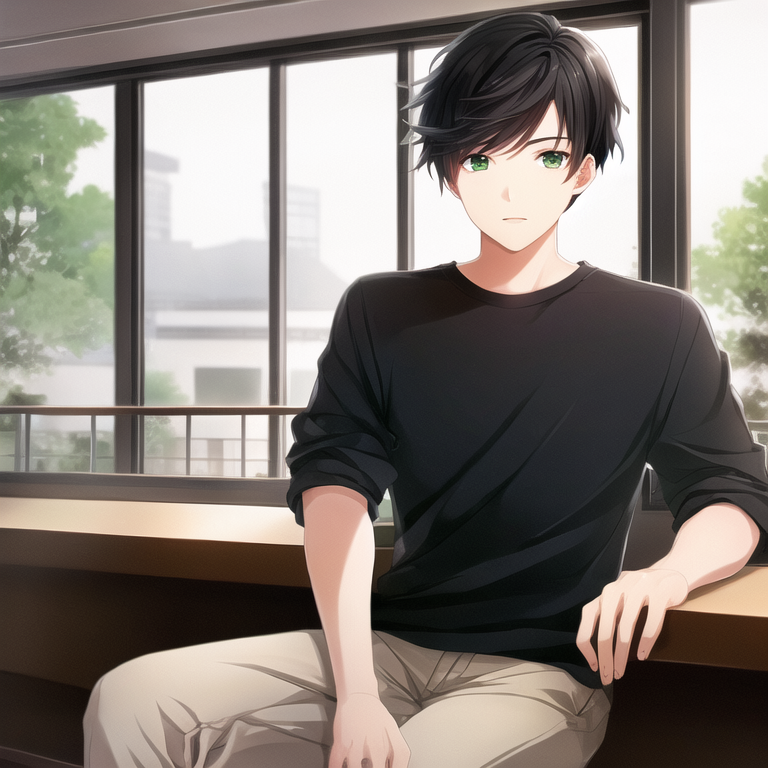
1boy, black hair, green eyes, bishounen, casual, indoors, sitting, coffee shop, sitting, bokeh
Steps: 50, Sampler: DPM++ 2M Karras, CFG scale: 7, Seed: 4225599226, Size: 768x768

License

This model is open access and available to all, with a CreativeML OpenRAIL-M license further specifying rights and usage. The CreativeML OpenRAIL License specifies:

  1. You can't use the model to deliberately produce nor share illegal or harmful outputs or content
  2. The authors claims no rights on the outputs you generate, you are free to use them and are accountable for their use which must not go against the provisions set in the license
  3. You may re-distribute the weights and use the model commercially and/or as a service. If you do, please be aware you have to include the same use restrictions as the ones in the license and share a copy of the CreativeML OpenRAIL-M to all your users (please read the license entirely and carefully) Please read the full license here

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм

Можно запустить

Подбираем GPU…

Ревизия весов
69e8453

0 моделей