/ Модель

Характеристики

Контекст
32 768 токенов
Параметры
32 млрд
Размер весов
65,5 ГБ
Лицензия
Apache 2.0
Архитектура
qwen2 · dense
Базовая модель
Qwen2.5-Coder-32B-Instruct
Опубликована
1 июл 2026

Qwen2.5-Coder-32B-abliterated

Генерация текстаТекст → текст7 профессий

32-миллиардная модель Qwen2.5-Coder с изменённым поведением отказов для генерации и анализа кода в локальном помощнике или агенте.

824скачиваний за 30 дней10лайковвеса обновлены6 июл 2026

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Тесты пользователейпока нет

Никто ещё не опубликовал тест этой модели. Соберите бенчмарк из своих задач — результат появится здесь.

  1. Добавьте модель в бенчмарк

    Вместе с другими моделями категории «Текст» — сравнение идёт внутри одной категории.

  2. Опишите свои задачи

    Напишите запросы, при необходимости приложите файлы и эталонные ответы.

  3. Запустите и опубликуйте

    Модели ответят на каждую задачу, судья оценит ответы. Опубликованный результат появится на этой странице.

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

TobiasLogic разработал Qwen2.5-Coder-32B-abliterated на основе Qwen/Qwen2.5-Coder-32B-Instruct. Это плотная причинно-языковая модель семейства Qwen2 с 32 млрд параметров для генерации кода и диалогового взаимодействия. В модели статически изменены веса, связанные с направлением отказа; адаптеры и дополнительные операции во время инференса не требуются. Контекст составляет 32 768 токенов.

Модель предназначена для локального помощника по программированию и агентных сценариев, включая анализ кода, отладку и задачи, в которых базовая модель может отказывать. В README приведены результаты EvalPlus: для вариантов HumanEval и MBPP показатели близки к базовой модели, однако опубликованные измерения включают квантизированную сборку GGUF Q4_K_M и не гарантируют такие же результаты для этого репозитория. Также заявлено снижение отказов на небольшом тестовом наборе.

Модель поддерживает английский язык и принимает текстовые запросы, выдавая текст и код. Удаление отказов может сопровождаться небольшим снижением качества, а часть отказов может сохраняться; метод не добавляет знаний и не устраняет унаследованные смещения. Лицензия — Apache-2.0.

Сценарии применения

  • генерация кода по текстовому запросу
  • поиск и исправление ошибок в коде
  • анализ кода и помощь при отладке
  • локальный диалоговый помощник программиста
  • создание кодового агента для работы с репозиторием

Ограничения

Изменение поведения отказов может немного снизить качество, а часть отказов может сохраниться. Заявленные результаты тестирования относятся к отдельной сборке GGUF Q4_K_M и небольшому набору для оценки отказов.

Для каких профессий подходит7

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Также подходит для

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

Qwen2.5-Coder-32B-abliterated

An abliterated (uncensored) build of Qwen/Qwen2.5-Coder-32B-Instruct. The model's refusal direction (Arditi et al. 2024, "Refusal in LLMs is mediated by a single direction") was estimated from contrasting harmful/harmless prompts and orthogonalized out of every residual-writing weight (all attention o_proj, all MLP down_proj, and token embeddings). This is a static weight edit — no LoRA, no runtime hooks, no inference-time cost. Coding ability is inherited from the base model.

Benchmarks

Coding capability scored with the official EvalPlus harness — greedy decoding, pass@1, every solution executed against unit tests. Both columns use the same harness, so it's a true apples-to-apples comparison against the full-precision base model.
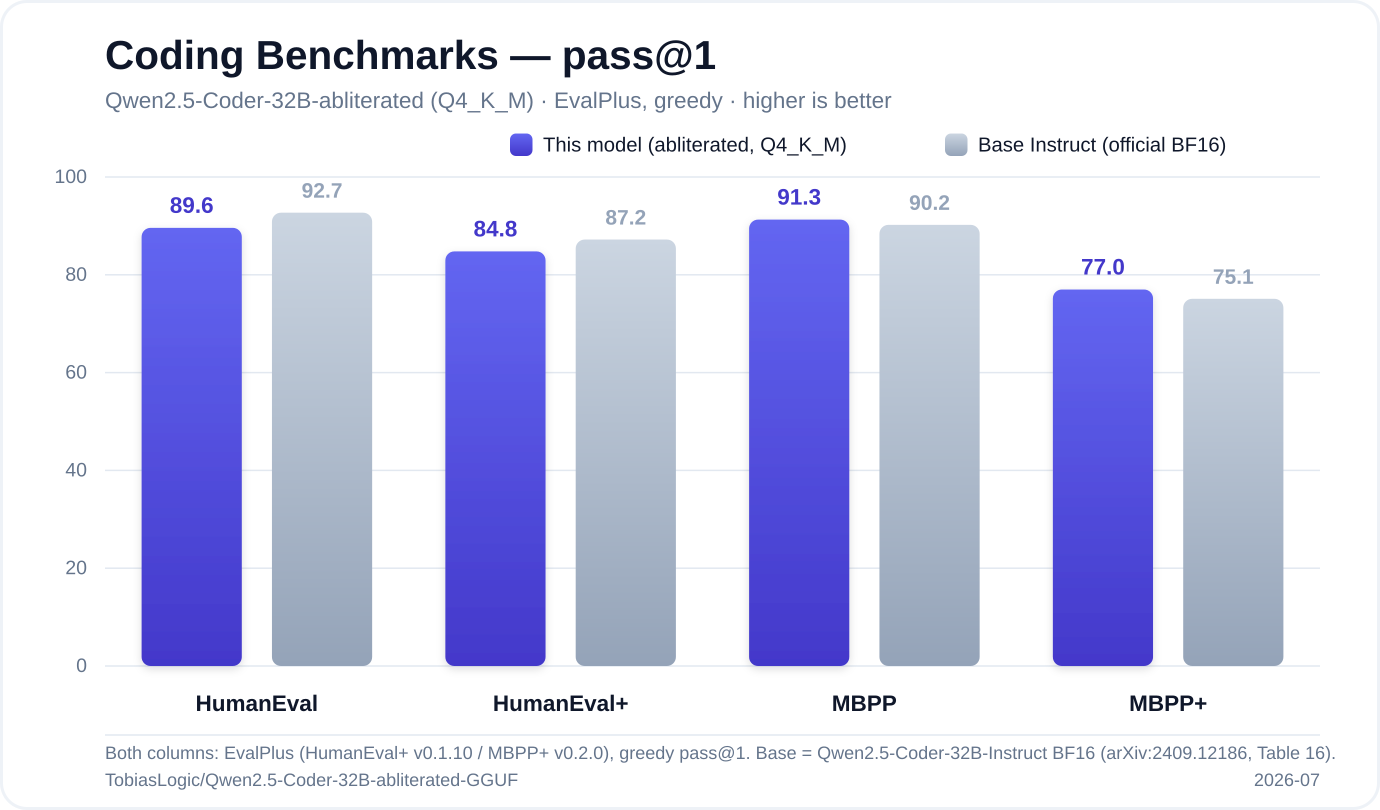
Coding benchmarks: pass@1

BenchmarkThis model (abliterated, Q4_K_M)Base Instruct (official BF16)
HumanEval89.6%92.7%
HumanEval+84.8%87.2%
MBPP91.3%90.2%
MBPP+77.0%75.1%

Abliteration removed refusals without breaking coding ability. The uncensored 4-bit build stays within ~3 points of the base on HumanEval and beats it on both MBPP variants — average delta ≈ −0.6 points across the four benchmarks. Not bad for a 19 GB GGUF you can run on a single 24 GB GPU.

Base numbers: Qwen2.5-Coder-32B-Instruct, tech report Table 16. Measured 2026-07, Q4_K_M via Ollama.

Refusal rate (held-out harmful eval)

refusal rate
base Qwen2.5-Coder-32B-Instruct96.9%
this model0.0%

Selected layer 42; direction estimated from 256 harmful/harmless contrast pairs and evaluated on a 32-prompt held-out harmful set. See abliteration_info.json in this repo for the exact run metadata.

Intended use

Local coding assistant / agent work where the base model's alignment layer refuses legitimate requests (security research, exploit analysis, red-teaming, uncensored creative writing). You are responsible for how you use it and for complying with applicable law.

Usage

Transformers:

from transformers import AutoModelForCausalLM, AutoTokenizer
m = "TobiasLogic/Qwen2.5-Coder-32B-abliterated"
tok = AutoTokenizer.from_pretrained(m)
model = AutoModelForCausalLM.from_pretrained(m, torch_dtype="bfloat16", device_map="auto")
msgs = [{"role": "user", "content": "Write a port scanner in Python."}]
ids = tok.apply_chat_template(msgs, add_generation_prompt=True, return_tensors="pt").to(model.device)
print(tok.decode(model.generate(ids, max_new_tokens=512)[0][ids.shape[1]:], skip_special_tokens=True))

GGUF (a Q4_K_M build is in the companion -GGUF repo) via Ollama:

ollama create qwen-coder-abliterated -f Modelfile
ollama run qwen-coder-abliterated

Limitations

  • Abliteration removes refusals but can slightly reduce quality vs. the base.
  • It does not add knowledge or change biases beyond the refusal behavior.
  • Some strongly-trained refusals may partially survive; a stronger system prompt closes the gap.

Method / reproducibility

Produced with the open pipeline abliterate.py. Base model is Apache-2.0, so this derivative is Apache-2.0.

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм

Можно запустить

Подбираем GPU…

Класс архитектуры
Qwen2ForCausalLM
Ревизия весов
cf52649

0 моделей