/ Модель

Характеристики

Лицензия
Apache 2.0
Архитектура
van · dense
Опубликована
16 мар 2022

van-base

Классификация изображенийИзображение → label3 профессии

Van-base — модель компьютерного зрения на архитектуре Visual Attention Network для классификации изображений.

238скачиваний за 30 дней1лайквеса обновлены31 мар 2022

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

Van-base — модель Visual Attention Network для классификации изображений, обученная на ImageNet-1k. Архитектура использует слой внимания на основе свёрток: обычные и крупные ядра, включая дилатированные свёртки, помогают учитывать локальные признаки и дальние зависимости на изображении.

Модель предназначена для отнесения изображения к категориям ImageNet-1k и может служить основой для дальнейшей настройки под другие задачи компьютерного зрения. Репозиторий содержит веса PyTorch; лицензия — Apache-2.0. Карточка не приводит размер модели и длину контекста.

Сценарии применения

  • классификация изображений по категориям ImageNet-1k
  • распознавание объектов и сцен на изображениях
  • извлечение визуальных признаков для последующей настройки модели

Ограничения

Модель обучена для классификации по ImageNet-1k; для других наборов классов или предметных областей может потребоваться дообучение.

Для каких профессий подходит3

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

Van

Van model trained on imagenet-1k. It was introduced in the paper Visual Attention Network and first released in this repository.

Disclaimer: The team releasing Van did not write a model card for this model so this model card has been written by the Hugging Face team.

Model description

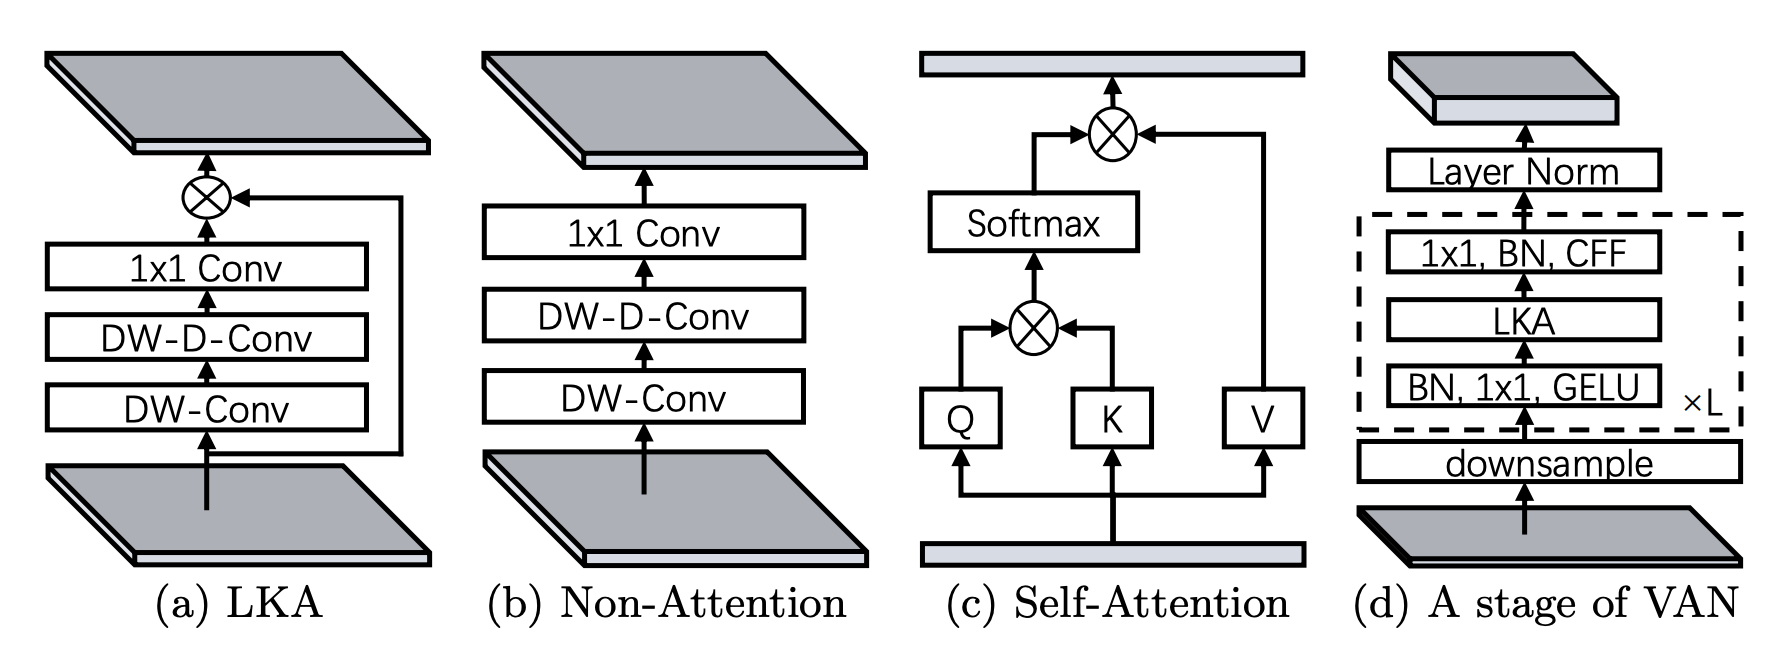
This paper introduces a new attention layer based on convolution operations able to capture both local and distant relationships. This is done by combining normal and large kernel convolution layers. The latter uses a dilated convolution to capture distant correlations.
model image

Intended uses & limitations

You can use the raw model for image classification. See the model hub to look for fine-tuned versions on a task that interests you.

How to use

Here is how to use this model:

>>> from transformers import AutoFeatureExtractor, VanForImageClassification
>>> import torch
>>> from datasets import load_dataset

>>> dataset = load_dataset("huggingface/cats-image")
>>> image = dataset["test"]["image"][0]

>>> feature_extractor = AutoFeatureExtractor.from_pretrained("Visual-Attention-Network/van-base")
>>> model = VanForImageClassification.from_pretrained("Visual-Attention-Network/van-base")

>>> inputs = feature_extractor(image, return_tensors="pt")

>>> with torch.no_grad():
...     logits = model(**inputs).logits

>>> # model predicts one of the 1000 ImageNet classes
>>> predicted_label = logits.argmax(-1).item()
>>> print(model.config.id2label[predicted_label])
tabby, tabby cat

For more code examples, we refer to the documentation.

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм · image-classification

Нельзя запустить

Архитектура van неизвестна transformers в образе рантайма.

Класс архитектуры
VanForImageClassification
Ревизия весов
569d1d8

0 моделей