/ Модель

Характеристики

Контекст
512 токенов
Параметры
434 млн
Лицензия
MIT
Архитектура
bert · dense
Опубликована
4 дек 2023

UAE-Large-V1

ЭмбеддингиТекст → embedding10 профессий

Англоязычная BERT-модель AnglE для создания эмбеддингов предложений, семантического поиска и сравнения текстов.

760 тыс.скачиваний за 30 дней237лайковвеса обновлены29 июл 2025

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Тесты пользователейпока нет

Никто ещё не опубликовал тест этой модели. Соберите бенчмарк из своих задач — результат появится здесь.

  1. Добавьте модель в бенчмарк

    Вместе с другими моделями категории «Эмбеддинги» — сравнение идёт внутри одной категории.

  2. Опишите свои задачи

    Напишите запросы, при необходимости приложите файлы и эталонные ответы.

  3. Запустите и опубликуйте

    Модели ответят на каждую задачу, судья оценит ответы. Опубликованный результат появится на этой странице.

Публичные оценки34

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

  • Tatoeba

    main_score

    Результат

    0,0094

    Общий результат 0,1005Общий результат 0,0824Общий результат 0,0351
    MTEB

    Публичная таблицадругая ревизия

  • SIB200ClusteringS2S

    main_score

    Результат

    0,0162

    Общий результат 0,2474
    MTEB

    Публичная таблицадругая ревизия

  • WikipediaRetrievalMultilingual

    main_score

    Результат

    0,7593

    MTEB

    Публичная таблицадругая ревизия

  • MultiEURLEXMultilabelClassification

    main_score

    Результат

    0,033

    Общий результат 0,0218
    MTEB

    Публичная таблицадругая ревизия

  • NusaXBitextMining

    main_score

    Результат

    0,2536

    MTEB

    Публичная таблицадругая ревизия

  • bBSARDNLRetrieval

    main_score

    Результат

    0,0506

    MTEB

    Публичная таблицадругая ревизия

  • CUREv1

    main_score

    Результат

    0,1855

    Общий результат 0,2557
    MTEB

    Публичная таблицадругая ревизия

  • STSBenchmarkMultilingualSTS

    main_score

    Результат

    0,414

    MTEB

    Публичная таблицадругая ревизия

  • IndicGenBenchFloresBitextMining

    main_score

    Результат

    0,0278

    Общий результат 0,0767Общий результат 0,0719Общий результат 0,0352
    MTEB

    Публичная таблицадругая ревизия

  • BrazilianToxicTweetsClassification

    main_score

    Результат

    0,2073

    MTEB

    Публичная таблицадругая ревизия

  • TempReasonL2Context

    main_score

    Результат

    0,1794

    MTEB

    Публичная таблицадругая ревизия

  • MLQARetrieval

    main_score

    Результат

    0,3596

    Общий результат 0,1379Общий результат 0,0213
    MTEB

    Публичная таблицадругая ревизия

  • MassiveIntentClassification

    main_score

    Результат

    0,3337

    MTEB

    Публичная таблицадругая ревизия

  • EPBench

    main_score

    Результат

    0,7442

    MTEB

    Публичная таблицадругая ревизия

  • AmazonReviewsClassification

    main_score

    Результат

    0,2738

    Общий результат 0,4804
    MTEB

    Публичная таблицадругая ревизия

  • VABBRetrieval

    main_score

    Результат

    0,5523

    MTEB

    Публичная таблицадругая ревизия

  • MemGovern

    main_score

    Результат

    0,845

    MTEB

    Публичная таблицадругая ревизия

  • MassiveScenarioClassification

    main_score

    Результат

    0,3361

    Общий результат 0,4915Общий результат 0,4147
    MTEB

    Публичная таблицадругая ревизия

  • XQuADRetrieval

    main_score

    Результат

    0,6328

    MTEB

    Публичная таблицадругая ревизия

  • SwedishSentimentClassification

    main_score

    Результат

    0,6606

    MTEB

    Публичная таблицадругая ревизия

  • STS22.v2

    main_score

    Результат

    0,4338

    Общий результат 0,5618
    MTEB

    Публичная таблицадругая ревизия

  • MultiHateClassification

    main_score

    Результат

    0,5655

    MTEB

    Публичная таблицадругая ревизия

  • TenKGnadClusteringP2P

    main_score

    Результат

    0,4379

    MTEB

    Публичная таблицадругая ревизия

  • WikipediaRerankingMultilingual

    main_score

    Результат

    0,7348

    MTEB

    Публичная таблицадругая ревизия

  • ReMe

    main_score

    Результат

    0,6074

    MTEB

    Публичная таблицадругая ревизия

  • PoemSentimentClassification

    main_score

    Результат

    0,5365

    MTEB

    Публичная таблицадругая ревизия

  • MIRACLRetrieval

    main_score

    Результат

    0,2184

    MTEB

    Публичная таблицадругая ревизия

  • NorwegianParliamentClassification

    main_score

    Результат

    0,5409

    MTEB

    Публичная таблицадругая ревизия

  • TweetSentimentClassification

    main_score

    Результат

    0,3957

    MTEB

    Публичная таблицадругая ревизия

  • LoCoMo

    main_score

    Результат

    0,2621

    MTEB

    Публичная таблицадругая ревизия

  • WebFAQRetrieval

    main_score

    Результат

    0,4457

    MTEB

    Публичная таблицадругая ревизия

  • MTOPIntentClassification

    main_score

    Результат

    0,4996

    MTEB

    Публичная таблицадругая ревизия

  • BigPatentClustering.v2

    main_score

    Результат

    0,2825

    MTEB

    Публичная таблицадругая ревизия

  • PpcPC

    main_score

    Результат

    0,7158

    MTEB

    Публичная таблицадругая ревизия

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

WhereIsAI/UAE-Large-V1 — англоязычная модель плотных текстовых эмбеддингов, разработанная командой AnglE. Она основана на архитектуре BERT и обучена с оптимизацией AnglE для получения векторных представлений предложений. Модель подходит для сравнения семантической близости текстов и поиска по смыслу; для задач извлечения информации в README рекомендуется использовать специальный prompt Prompts.C для запроса, но не для документов.

Модель содержит 433,9 млн параметров, принимает текст с контекстом до 512 токенов и возвращает эмбеддинги. В README заявлен результат 64,64 среднего балла на MTEB и лидерство в рейтинге на момент публикации. Поддерживаются форматы safetensors, ONNX и OpenVINO. Лицензия MIT разрешает использование в разных сценариях.

Сценарии применения

  • поиск документов по смыслу на английском языке
  • сравнение семантической близости предложений
  • поиск ответов и фрагментов для RAG
  • кластеризация английских текстов по смыслу
  • ранжирование текстов-кандидатов по релевантности

Ограничения

Контекст ограничен 512 токенами; модель рассчитана на английский язык. Заявленный результат на MTEB относится к моменту публикации README и не гарантирует качество на конкретных данных.

Для каких профессий подходит10

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Также подходит для

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

Universal AnglE Embedding

📢 WhereIsAI/UAE-Large-V1 is licensed under MIT. Feel free to use it in any scenario. If you use it for academic papers, you could cite us via 👉 citation info.

🤝 Follow us on:

Welcome to using AnglE to train and infer powerful sentence embeddings.

🏆 Achievements

  • 📅 May 16, 2024 | AnglE's paper is accepted by ACL 2024 Main Conference
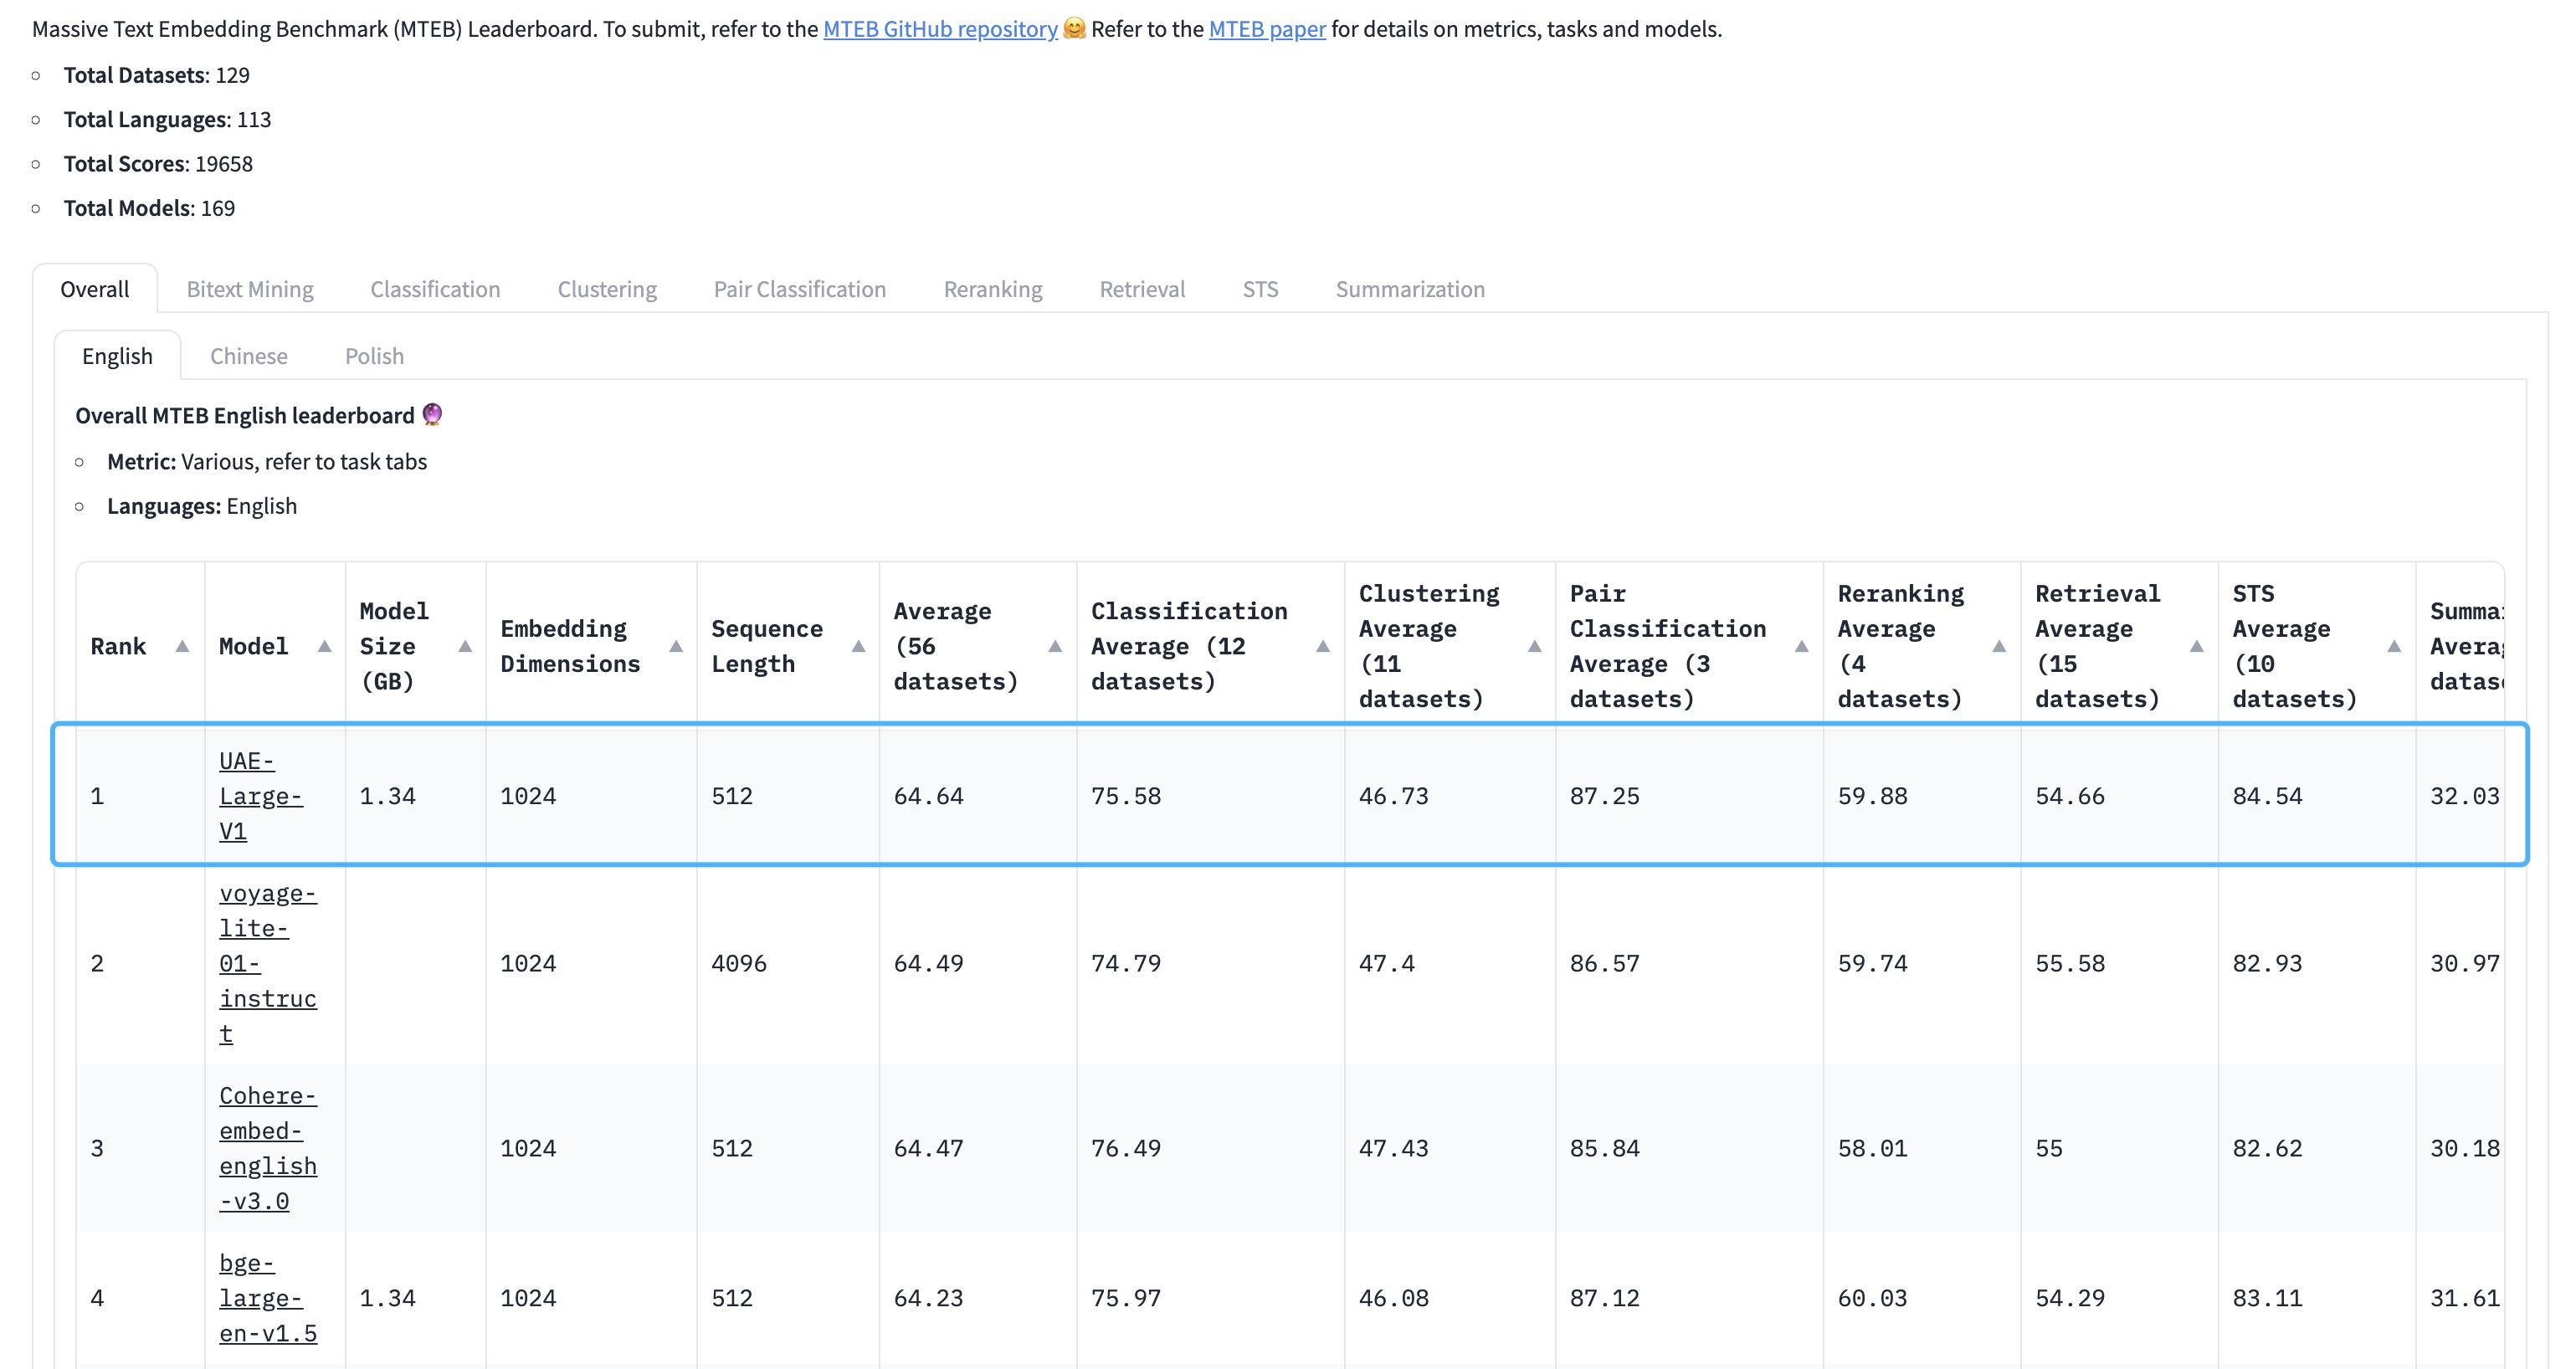
  • 📅 Dec 4, 2023 | 🔥 Our universal English sentence embedding WhereIsAI/UAE-Large-V1 achieves SOTA on the MTEB Leaderboard with an average score of 64.64!
image/jpeg

🧑‍🤝‍🧑 Siblings:

Usage

1. angle_emb

python -m pip install -U angle-emb
  1. Non-Retrieval Tasks

There is no need to specify any prompts.

from angle_emb import AnglE
from angle_emb.utils import cosine_similarity

angle = AnglE.from_pretrained('WhereIsAI/UAE-Large-V1', pooling_strategy='cls').cuda()
doc_vecs = angle.encode([
    'The weather is great!',
    'The weather is very good!',
    'i am going to bed'
], normalize_embedding=True)

for i, dv1 in enumerate(doc_vecs):
    for dv2 in doc_vecs[i+1:]:
        print(cosine_similarity(dv1, dv2))
  1. Retrieval Tasks

For retrieval purposes, please use the prompt Prompts.C for query (not for document).

from angle_emb import AnglE, Prompts
from angle_emb.utils import cosine_similarity

angle = AnglE.from_pretrained('WhereIsAI/UAE-Large-V1', pooling_strategy='cls').cuda()
qv = angle.encode(Prompts.C.format(text='what is the weather?'))
doc_vecs = angle.encode([
    'The weather is great!',
    'it is rainy today.',
    'i am going to bed'
])

for dv in doc_vecs:
    print(cosine_similarity(qv[0], dv))

2. sentence transformer

from angle_emb import Prompts
from sentence_transformers import SentenceTransformer

model = SentenceTransformer("WhereIsAI/UAE-Large-V1").cuda()

qv = model.encode(Prompts.C.format(text='what is the weather?'))
doc_vecs = model.encode([
    'The weather is great!',
    'it is rainy today.',
    'i am going to bed'
])

for dv in doc_vecs:
    print(1 - spatial.distance.cosine(qv, dv))

3. Infinity

Infinity is a MIT licensed server for OpenAI-compatible deployment.

docker run --gpus all -v $PWD/data:/app/.cache -p "7997":"7997" \
michaelf34/infinity:latest \
v2 --model-id WhereIsAI/UAE-Large-V1 --revision "369c368f70f16a613f19f5598d4f12d9f44235d4" --dtype float16 --batch-size 32 --device cuda --engine torch --port 7997

Citation

If you use our pre-trained models, welcome to support us by citing our work:

@article{li2023angle,
  title={AnglE-optimized Text Embeddings},
  author={Li, Xianming and Li, Jing},
  journal={arXiv preprint arXiv:2309.12871},
  year={2023}
}

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм

Можно запустить

Подбираем GPU…

Класс архитектуры
BertModel
Ревизия весов
9c9b2c9

0 моделей