SentenceTransformer based on BAAI/bge-m3
This is a sentence-transformers model finetuned from BAAI/bge-m3. It maps sentences & paragraphs to a 1024-dimensional dense vector space and can be used for semantic textual similarity, semantic search, paraphrase mining, text classification, clustering, and more.
Model Details
Model Description
- Model Type: Sentence Transformer
- Base model: BAAI/bge-m3
- Maximum Sequence Length: 8192 tokens
- Output Dimensionality: 1024 dimensions
- Similarity Function: Cosine Similarity
Model Sources
- Documentation: Sentence Transformers Documentation
- Repository: Sentence Transformers on GitHub
- Hugging Face: Sentence Transformers on Hugging Face
Full Model Architecture
SentenceTransformer(
  (0): Transformer({'max_seq_length': 8192, 'do_lower_case': False, 'architecture': 'XLMRobertaModel'})
  (1): Pooling({'word_embedding_dimension': 1024, 'pooling_mode_cls_token': True, 'pooling_mode_mean_tokens': False, 'pooling_mode_max_tokens': False, 'pooling_mode_mean_sqrt_len_tokens': False, 'pooling_mode_weightedmean_tokens': False, 'pooling_mode_lasttoken': False, 'include_prompt': True})
  (2): Normalize()
)
Usage
Direct Usage (Sentence Transformers)
First install the Sentence Transformers library:
pip install -U sentence-transformers
Then you can load this model and run inference.
from sentence_transformers import SentenceTransformer
# Download from the 🤗 Hub
model = SentenceTransformer("aaa961/finetuned-bge-m3-base-en")
# Run inference
sentences = [
'Shell integration: bash and zsh don\'t serialize \\n and ; characters Part of https://github.com/microsoft/vscode/issues/155639\r\n\r\nRepro:\r\n\r\n1. Open a bash or zsh session\r\n2. Run:\r\n ```sh\r\n echo "a\r\n … b"\r\n ```\r\n \r\n3. ctrl+alt+r to run recent command, select the last command, 🐛 it\'s run without the new line\r\n \r\n',
'TreeView state out of sync Testing #117304\r\n\r\nRepro: Not Sure\r\n\r\nTest state shows passed in file but still running in tree view.\r\n\r\n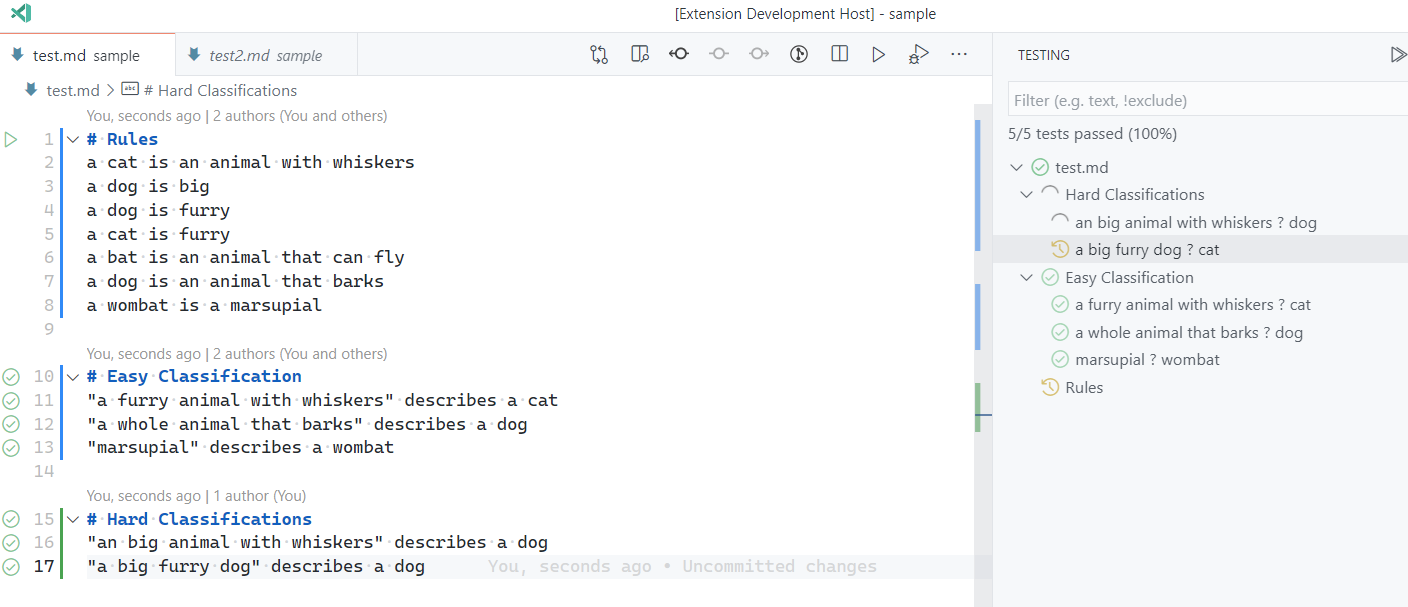\r\n',
'Setting icon and color in createTerminal API no longer works correctly See https://github.com/fabiospampinato/vscode-terminals/issues/77\r\n\r\nLooks like the default tab color/icon change probably regressed this.\r\n\r\n',
]
embeddings = model.encode(sentences)
print(embeddings.shape)
# [3, 1024]
# Get the similarity scores for the embeddings
similarities = model.similarity(embeddings, embeddings)
print(similarities)
# tensor([[1.0000, 0.4264, 0.4315],
# [0.4264, 1.0000, 0.4278],
# [0.4315, 0.4278, 1.0000]])
Evaluation
Metrics
Triplet
- Dataset:
bge-base-en-train - Evaluated with TripletEvaluator
| Metric | Value |
|---|---|
| cosine_accuracy | 1.0 |
Triplet
- Dataset:
bge-base-en-train - Evaluated with TripletEvaluator
| Metric | Value |
|---|---|
| cosine_accuracy | 0.9524 |
Training Details
Training Dataset
Unnamed Dataset
- Size: 336 training samples
- Columns: texts and label
- Approximate statistics based on the first 336 samples:
texts label type string int details min: 12 tokensmean: 340.9 tokensmax: 996 tokens 0: ~1.19%5: ~0.60%7: ~0.60%8: ~0.60%9: ~0.60%10: ~0.60%12: ~0.60%13: ~0.60%15: ~0.60%16: ~0.60%17: ~0.60%19: ~0.60%20: ~0.60%21: ~0.60%25: ~0.60%26: ~0.60%27: ~0.60%28: ~0.60%29: ~0.89%30: ~0.89%31: ~2.08%33: ~1.49%34: ~0.60%36: ~0.60%37: ~0.89%38: ~0.60%42: ~0.89%43: ~1.19%45: ~0.60%47: ~0.60%48: ~0.60%49: ~0.60%50: ~0.60%51: ~0.60%52: ~1.19%53: ~0.60%55: ~0.60%57: ~1.19%59: ~0.60%60: ~0.60%61: ~0.60%62: ~0.60%63: ~0.60%64: ~0.89%65: ~0.60%67: ~0.60%68: ~0.89%69: ~0.60%70: ~0.60%71: ~0.60%72: ~0.60%73: ~0.60%74: ~0.60%75: ~0.60%77: ~0.60%78: ~0.60%82: ~0.89%84: ~0.60%85: ~0.60%86: ~0.60%87: ~0.60%88: ~0.60%89: ~0.60%90: ~0.60%91: ~0.60%92: ~0.89%93: ~0.60%95: ~0.60%96: ~0.60%97: ~0.60%98: ~0.60%99: ~0.60%100: ~0.60%101: ~0.60%103: ~0.60%105: ~0.60%108: ~0.60%109: ~0.60%110: ~0.89%113: ~0.60%115: ~0.60%116: ~0.60%117: ~0.60%118: ~0.60%119: ~0.60%120: ~1.49%121: ~0.60%126: ~0.60%127: ~0.60%130: ~0.60%131: ~0.60%134: ~0.60%135: ~0.60%136: ~0.60%137: ~0.60%138: ~0.60%139: ~0.60%140: ~0.60%143: ~0.60%144: ~0.60%147: ~0.60%148: ~0.60%149: ~0.60%150: ~0.60%152: ~0.60%153: ~0.60%154: ~0.60%155: ~0.60%157: ~0.60%158: ~0.60%159: ~0.60%160: ~0.60%161: ~0.60%163: ~0.60%164: ~0.60%165: ~0.60%168: ~0.60%170: ~0.60%171: ~0.89%174: ~0.89%175: ~0.60%176: ~0.60%177: ~0.60%178: ~0.60%179: ~0.60%180: ~0.60%181: ~0.60%182: ~0.60%183: ~0.60%185: ~0.60%186: ~0.60%187: ~0.60%192: ~0.60%193: ~0.60%194: ~0.60%195: ~0.89%196: ~0.60%197: ~0.60%198: ~0.60%199: ~0.60%202: ~0.60%204: ~0.60%205: ~0.89%207: ~0.60%208: ~0.60%209: ~0.60%210: ~0.60%213: ~0.60%214: ~0.60%215: ~0.60%216: ~0.60%218: ~0.60% - Samples:
texts label Branch list is sometimes out of order Type: Bug - Loss: BatchSemiHardTripletLoss
Evaluation Dataset
Unnamed Dataset
- Size: 70 evaluation samples
- Columns: texts and label
- Approximate statistics based on the first 70 samples:
texts label type string int details min: 58 tokensmean: 303.57 tokensmax: 864 tokens 1: ~2.86%2: ~2.86%6: ~2.86%11: ~5.71%14: ~2.86%23: ~2.86%32: ~5.71%35: ~2.86%39: ~2.86%40: ~2.86%46: ~2.86%54: ~2.86%83: ~2.86%102: ~2.86%104: ~4.29%111: ~2.86%122: ~2.86%123: ~2.86%125: ~2.86%145: ~2.86%146: ~2.86%162: ~2.86%166: ~2.86%169: ~2.86%184: ~2.86%188: ~2.86%190: ~2.86%200: ~2.86%201: ~4.29%203: ~2.86%206: ~2.86%217: ~2.86% - Samples:
texts label Ctrl+I stopped working after first hold+talk+release Testing #213355 - Loss: BatchSemiHardTripletLoss
Training Hyperparameters
Non-Default Hyperparameters
eval_strategy: stepsper_device_train_batch_size: 1per_device_eval_batch_size: 1gradient_accumulation_steps: 8learning_rate: 2e-05num_train_epochs: 5warmup_ratio: 0.1fp16: Truebatch_sampler: no_duplicates
All Hyperparameters
overwrite_output_dir: Falsedo_predict: Falseeval_strategy: stepsprediction_loss_only: Trueper_device_train_batch_size: 1per_device_eval_batch_size: 1per_gpu_train_batch_size: Noneper_gpu_eval_batch_size: Nonegradient_accumulation_steps: 8eval_accumulation_steps: Nonetorch_empty_cache_steps: Nonelearning_rate: 2e-05weight_decay: 0.0adam_beta1: 0.9adam_beta2: 0.999adam_epsilon: 1e-08max_grad_norm: 1.0num_train_epochs: 5max_steps: -1lr_scheduler_type: linearlr_scheduler_kwargs: {}warmup_ratio: 0.1warmup_steps: 0log_level: passivelog_level_replica: warninglog_on_each_node: Truelogging_nan_inf_filter: Truesave_safetensors: Truesave_on_each_node: Falsesave_only_model: Falserestore_callback_states_from_checkpoint: Falseno_cuda: Falseuse_cpu: Falseuse_mps_device: Falseseed: 42data_seed: Nonejit_mode_eval: Falseuse_ipex: Falsebf16: Falsefp16: Truefp16_opt_level: O1half_precision_backend: autobf16_full_eval: Falsefp16_full_eval: Falsetf32: Nonelocal_rank: 0ddp_backend: Nonetpu_num_cores: Nonetpu_metrics_debug: Falsedebug: []dataloader_drop_last: Falsedataloader_num_workers: 0dataloader_prefetch_factor: Nonepast_index: -1disable_tqdm: Falseremove_unused_columns: Truelabel_names: Noneload_best_model_at_end: Falseignore_data_skip: Falsefsdp: []fsdp_min_num_params: 0fsdp_config: {'min_num_params': 0, 'xla': False, 'xla_fsdp_v2': False, 'xla_fsdp_grad_ckpt': False}fsdp_transformer_layer_cls_to_wrap: Noneaccelerator_config: {'split_batches': False, 'dispatch_batches': None, 'even_batches': True, 'use_seedable_sampler': True, 'non_blocking': False, 'gradient_accumulation_kwargs': None}deepspeed: Nonelabel_smoothing_factor: 0.0optim: adamw_torchoptim_args: Noneadafactor: Falsegroup_by_length: Falselength_column_name: lengthddp_find_unused_parameters: Noneddp_bucket_cap_mb: Noneddp_broadcast_buffers: Falsedataloader_pin_memory: Truedataloader_persistent_workers: Falseskip_memory_metrics: Trueuse_legacy_prediction_loop: Falsepush_to_hub: Falseresume_from_checkpoint: Nonehub_model_id: Nonehub_strategy: every_savehub_private_repo: Nonehub_always_push: Falsehub_revision: Nonegradient_checkpointing: Falsegradient_checkpointing_kwargs: Noneinclude_inputs_for_metrics: Falseinclude_for_metrics: []eval_do_concat_batches: Truefp16_backend: autopush_to_hub_model_id: Nonepush_to_hub_organization: Nonemp_parameters:auto_find_batch_size: Falsefull_determinism: Falsetorchdynamo: Noneray_scope: lastddp_timeout: 1800torch_compile: Falsetorch_compile_backend: Nonetorch_compile_mode: Noneinclude_tokens_per_second: Falseinclude_num_input_tokens_seen: Falseneftune_noise_alpha: Noneoptim_target_modules: Nonebatch_eval_metrics: Falseeval_on_start: Falseuse_liger_kernel: Falseliger_kernel_config: Noneeval_use_gather_object: Falseaverage_tokens_across_devices: Falseprompts: Nonebatch_sampler: no_duplicatesmulti_dataset_batch_sampler: proportionalrouter_mapping: {}learning_rate_mapping: {}
Training Logs
| Epoch | Step | Training Loss | Validation Loss | bge-base-en-train_cosine_accuracy |
|---|---|---|---|---|
| -1 | -1 | - | - | 1.0 |
| 2.3810 | 100 | 0.0 | nan | 0.9524 |
| 4.7619 | 200 | 0.0 | nan | 0.9524 |
| -1 | -1 | - | - | 1.0 |
Framework Versions
- Python: 3.10.10
- Sentence Transformers: 5.1.0
- Transformers: 4.55.3
- PyTorch: 2.7.1+cu128
- Accelerate: 1.10.0
- Datasets: 4.0.0
- Tokenizers: 0.21.4
Citation
BibTeX
Sentence Transformers
@inproceedings{reimers-2019-sentence-bert,
    title = "Sentence-BERT: Sentence Embeddings using Siamese BERT-Networks",
    author = "Reimers, Nils and Gurevych, Iryna",
    booktitle = "Proceedings of the 2019 Conference on Empirical Methods in Natural Language Processing",
    month = "11",
    year = "2019",
    publisher = "Association for Computational Linguistics",
    url = "https://arxiv.org/abs/1908.10084",
}
BatchSemiHardTripletLoss
@misc{hermans2017defense,
    title={In Defense of the Triplet Loss for Person Re-Identification},
    author={Alexander Hermans and Lucas Beyer and Bastian Leibe},
    year={2017},
    eprint={1703.07737},
    archivePrefix={arXiv},
    primaryClass={cs.CV}
}