/ Модель

Характеристики

Лицензия
MIT
Опубликована
2 июл 2023

InstructCV

Генерация изображенийТекст → изображение3 профессии

InstructCV — диффузионная модель на базе InstructPix2Pix для создания и редактирования изображений по текстовым инструкциям.

24скачиваний за 30 дней10лайковвеса обновлены19 фев 2024

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Тесты пользователейпока нет

Никто ещё не опубликовал тест этой модели. Соберите бенчмарк из своих задач — результат появится здесь.

  1. Добавьте модель в бенчмарк

    Вместе с другими моделями категории «Изображения» — сравнение идёт внутри одной категории.

  2. Опишите свои задачи

    Напишите запросы, при необходимости приложите файлы и эталонные ответы.

  3. Запустите и опубликуйте

    Модели сгенерируют результат по каждой задаче. Опубликованный тест появится на этой странице.

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

InstructCV — модель генерации и редактирования изображений по текстовым инструкциям, представленная проектом alaa-lab. Она основана на Stable Diffusion InstructPix2Pix и предназначена для сценариев, где нужно создать изображение по запросу или изменить предоставленное изображение, следуя инструкции. Модель распространяется в форматах Diffusers и PyTorch; лицензия — MIT.

Карточка связывает модель с датасетом InstructCV-Demo-Data и описывает её как instruction-tuned text-to-image diffusion model для широкого круга визуальных задач. Для использования в README приведён стек Diffusers, Accelerate, Safetensors и Transformers. Контекстная длина и поддерживаемые языки в доступных сведениях не определены.

Сценарии применения

  • создание изображения по текстовому описанию
  • редактирование изображения по текстовой инструкции
  • изменение визуальных элементов на исходном изображении
  • эксперименты с универсальным выполнением визуальных инструкций

Ограничения

В README указано, что на момент публикации для работы требовалась основная ветка Diffusers, а pipeline должен был появиться в следующем выпуске. Данных о качестве и ограничениях редактирования в карточке нет.

Для каких профессий подходит3

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

InstructCV: Instruction-Tuned Text-to-Image Diffusion Models as Vision Generalists

GitHub: https://github.com/AlaaLab/InstructCV
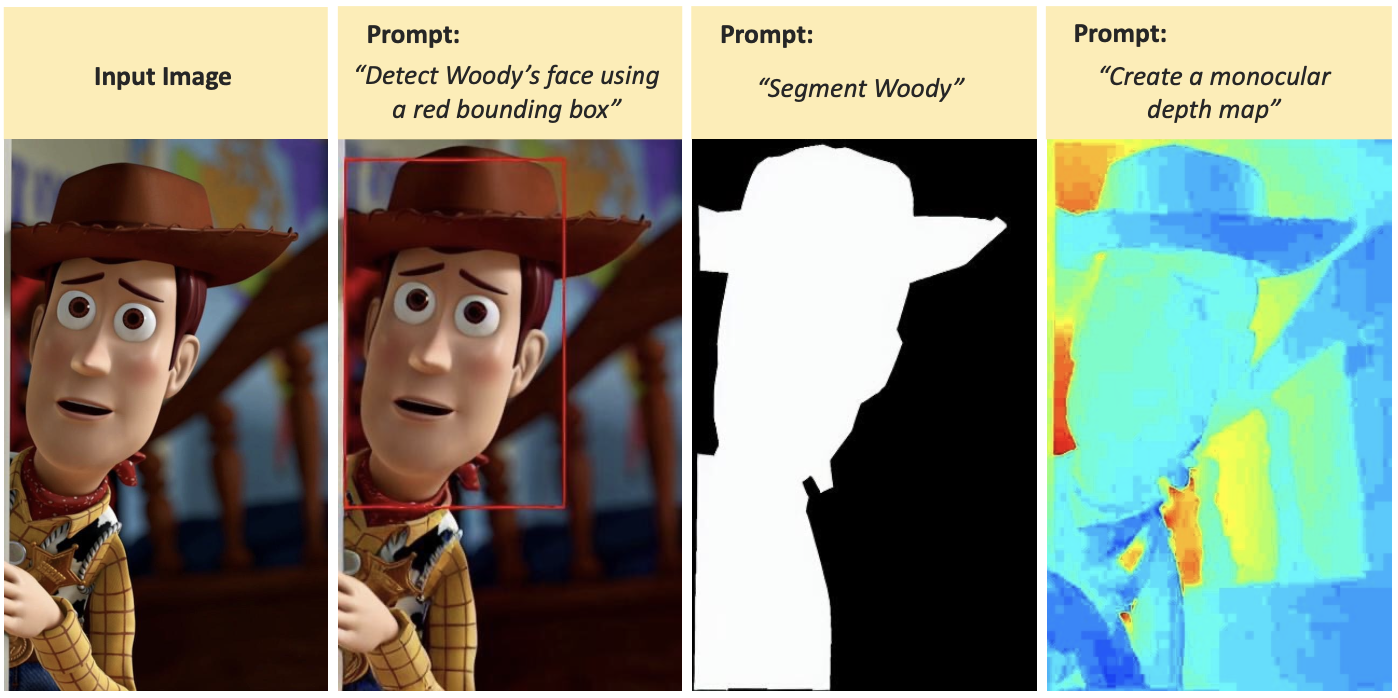
pCVB5B8.png

Example

To use InstructCV, install diffusers using main for now. The pipeline will be available in the next release

pip install diffusers accelerate safetensors transformers
import PIL
import requests
import torch
from diffusers import StableDiffusionInstructPix2PixPipeline, EulerAncestralDiscreteScheduler

model_id = "yulu2/InstructCV"
pipe = StableDiffusionInstructPix2PixPipeline.from_pretrained(model_id, torch_dtype=torch.float16, safety_checker=None, variant="ema")
pipe.to("cuda")
pipe.scheduler = EulerAncestralDiscreteScheduler.from_config(pipe.scheduler.config)

url = "put your url here"

def download_image(url):
    image = PIL.Image.open(requests.get(url, stream=True).raw)
    image = PIL.ImageOps.exif_transpose(image)
    image = image.convert("RGB")
    return image

image         = download_image(URL)
seed          = random.randint(0, 100000)
generator     = torch.manual_seed(seed)
width, height = image.size
factor        = 512 / max(width, height)
factor        = math.ceil(min(width, height) * factor / 64) * 64 / min(width, height)
width         = int((width * factor) // 64) * 64
height        = int((height * factor) // 64) * 64
image         = ImageOps.fit(image, (width, height), method=Image.Resampling.LANCZOS)

prompt        = "Detect the person."
images        = pipe(prompt, image=image, num_inference_steps=100, generator=generator).images[0]
images[0]

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм

Можно запустить

Подбираем GPU…

Ревизия весов
6b2d8eb

0 моделей