/ Модель

Характеристики

Лицензия
CreativeML OpenRAIL-M
Опубликована
10 фев 2023

onimai-characters

Генерация изображенийТекст → изображение3 профессии

Модель Stable Diffusion для генерации изображений персонажей и сцен из аниме ONIMAI по текстовым запросам.

61скачиваний за 30 дней32лайкавеса обновлены30 апр 2023

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Тесты пользователейпока нет

Никто ещё не опубликовал тест этой модели. Соберите бенчмарк из своих задач — результат появится здесь.

  1. Добавьте модель в бенчмарк

    Вместе с другими моделями категории «Изображения» — сравнение идёт внутри одной категории.

  2. Опишите свои задачи

    Напишите запросы, при необходимости приложите файлы и эталонные ответы.

  3. Запустите и опубликуйте

    Модели сгенерируют результат по каждой задаче. Опубликованный тест появится на этой странице.

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

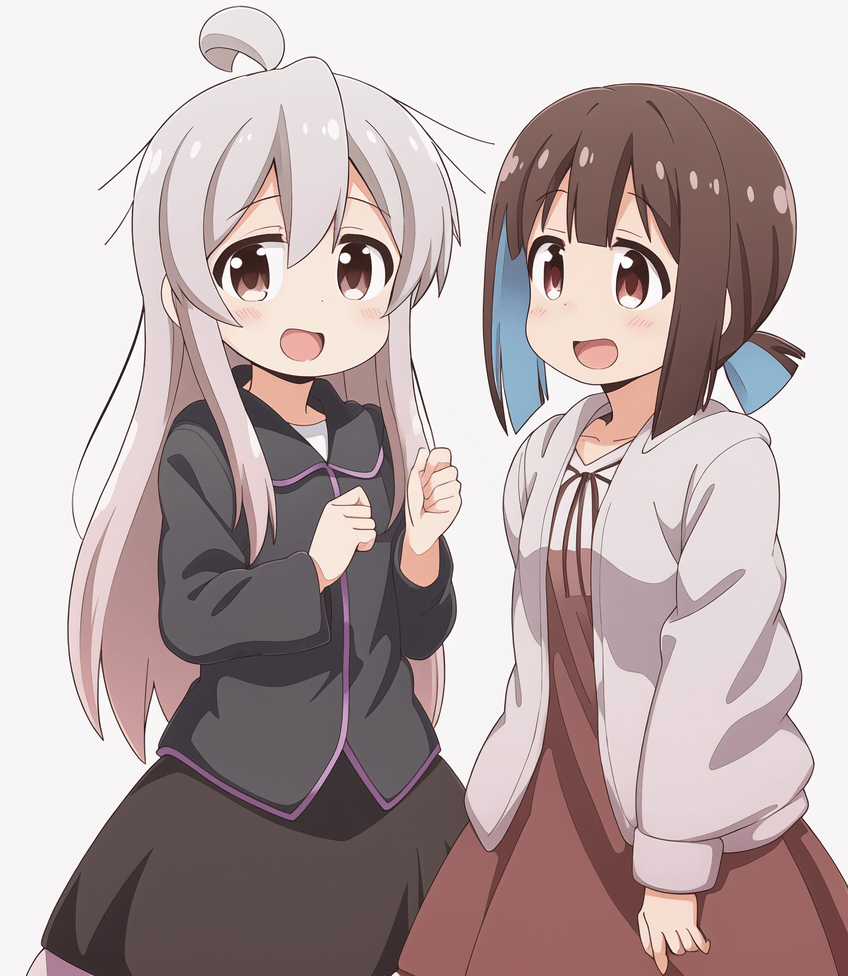
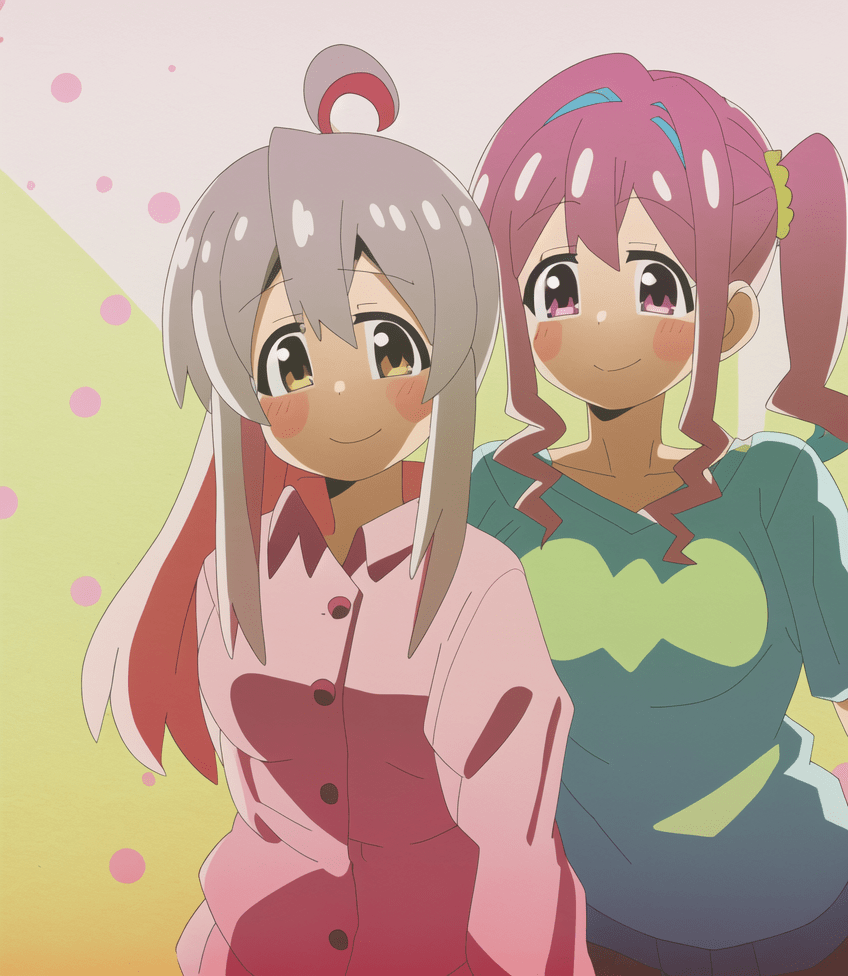
alea31415 разработал эту модель генерации изображений на основе Stable Diffusion, дообучив ACertainty на персонажах аниме «ONIMAI: I'm Now Your Sister!». Модель создаёт изображения по текстовым запросам и поддерживает три обученных стиля: aniscreen, edstyle и megazine. Для вызова персонажей используются триггерные слова OyamaMahiro, OyamaMihari, HozukiKaede, HozukiMomiji, OkaAsahi и MurosakiMiyo; TenkawaNayuta встречается в обучающих данных редко, поэтому качество её изображений может быть низким.

Модель предназначена для генерации иллюстраций с персонажами и сценами из ONIMAI. Она обучалась на разрешении 512 пикселей с clip skip 1; автор сообщает, что сложные сцены и сходство со стилями и одеждой лучше получаются у полной модели, чем у опубликованных LoRA. Модель доступна в форматах Diffusers и safetensors по лицензии CreativeML OpenRAIL-M.

Сценарии применения

  • генерация изображений Махиро Оямы из ONIMAI
  • создание иллюстраций с персонажами ONIMAI по триггерным словам
  • генерация сцен в стиле экранных кадров аниме ONIMAI
  • создание изображений в стилях aniscreen, edstyle и megazine

Ограничения

Автор отмечает, что TenkawaNayuta представлена менее чем десятью изображениями, поэтому качество генерации этого персонажа может быть низким. Несколько персонажей в одной сцене усложняют генерацию, особенно при числе от четырёх; LoRA хуже сохраняют стиль и одежду, чем полная модель.

Для каких профессий подходит3

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

This model is trained on 6(+1?) characters from ONIMAI: I'm Now Your Sister! (お兄ちゃんはおしまい!)

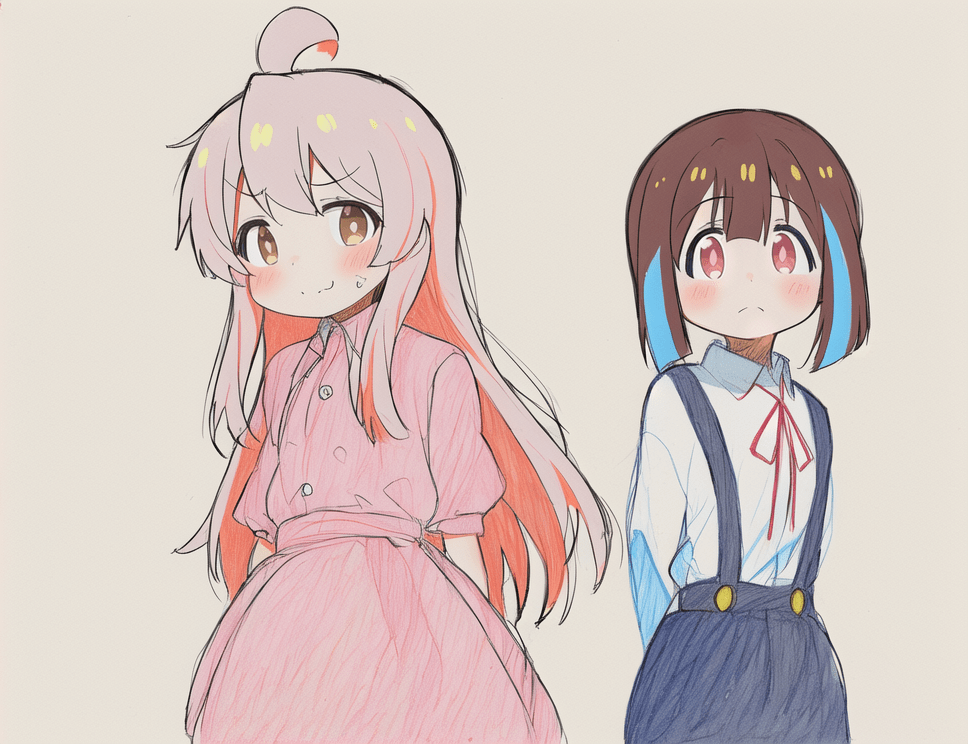
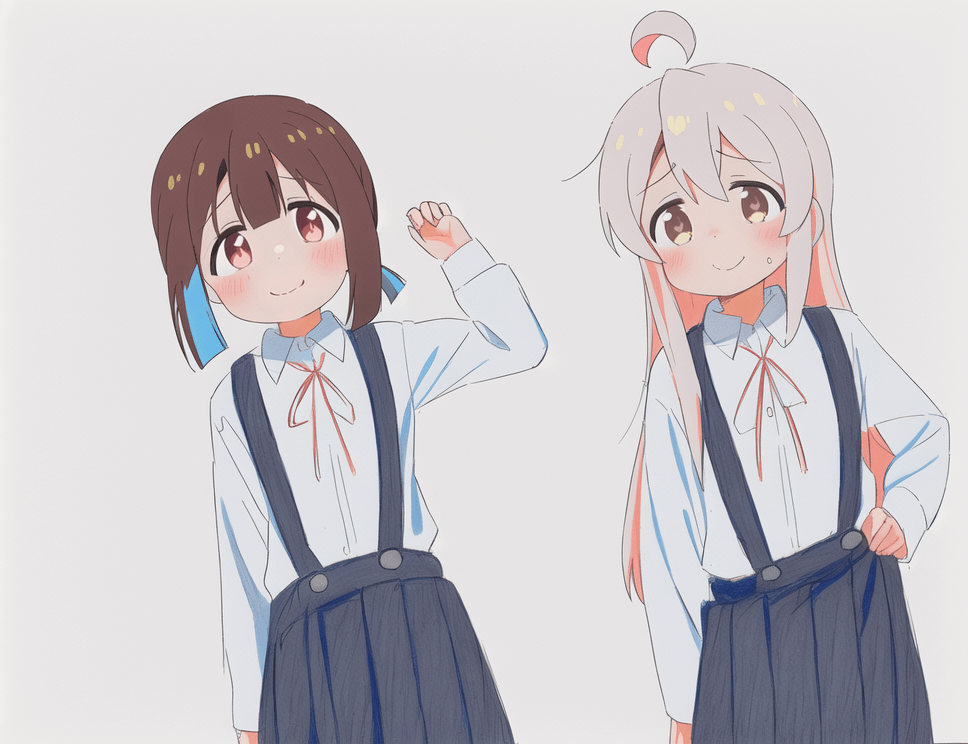
Example Generations
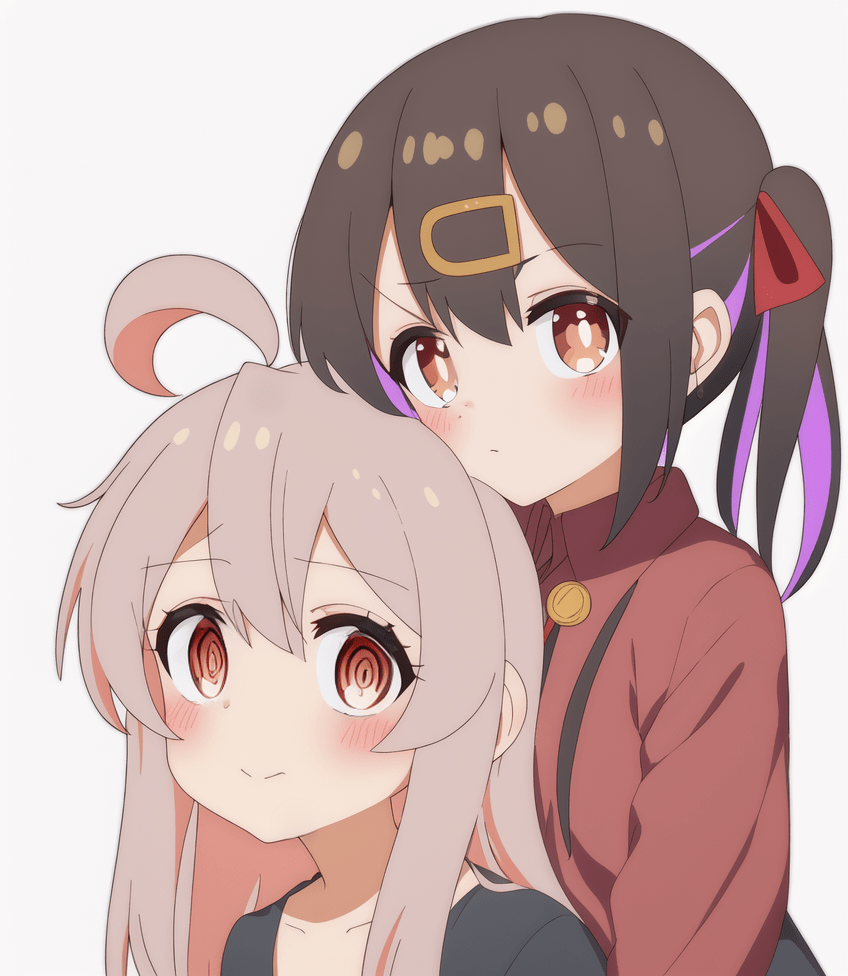
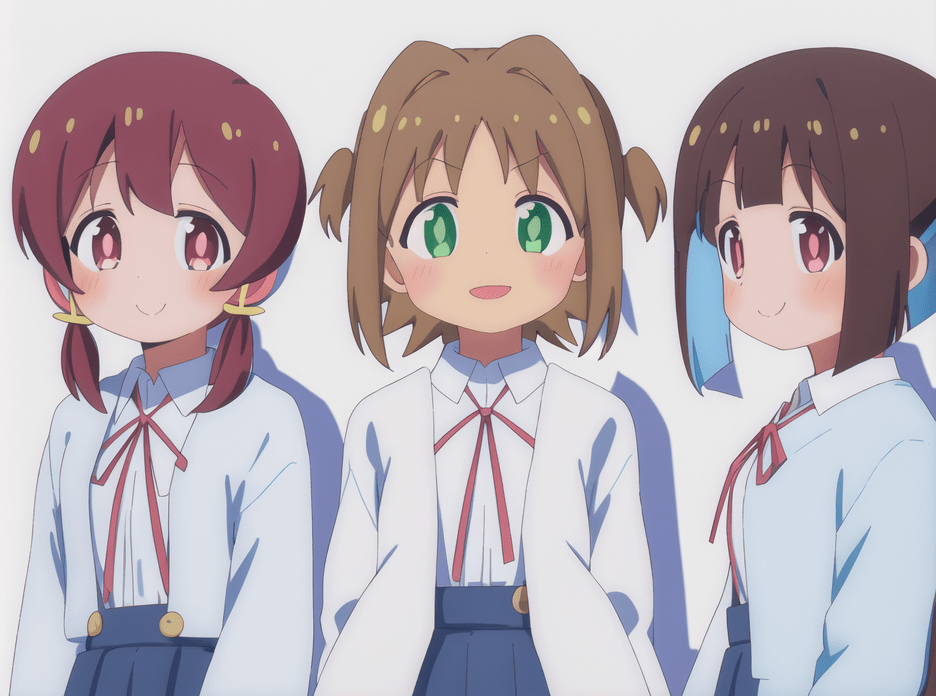
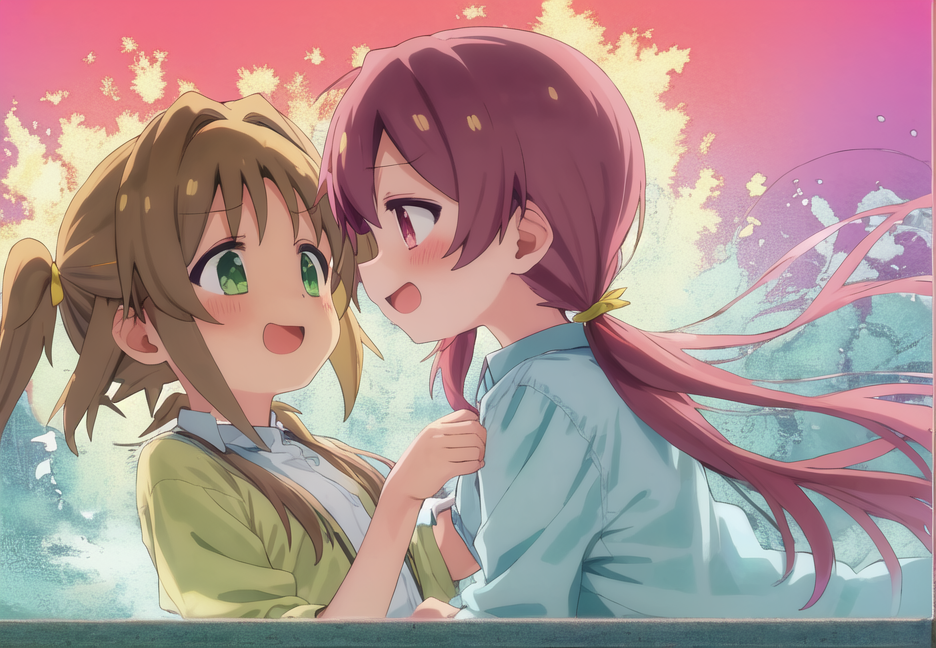
00009-20230210181727-min.png 00041-20230210195115-min.png

Update -- 2023.02.19

Two lora checkpoints trained with the same dataset are added to the loras subfolder. The first one seems to work already. The characters are learned but unfortunately not the styles nor the outfits. It is trained based on ACertainty and works fine on Orange and Anything, but not so well on models that are trained further such as MyneFactoryBase or my own models. I still cannot figure out when Loras get transferred correctly.

The lora has dimension 32, alpha 1, and is trained with learning rate 1e-4. Here are some example generations.
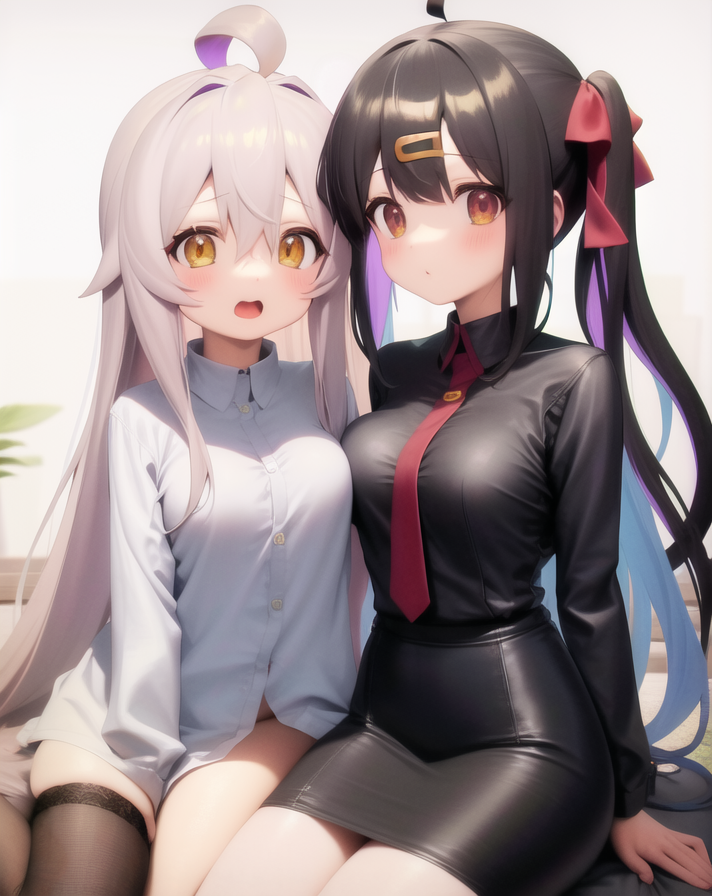
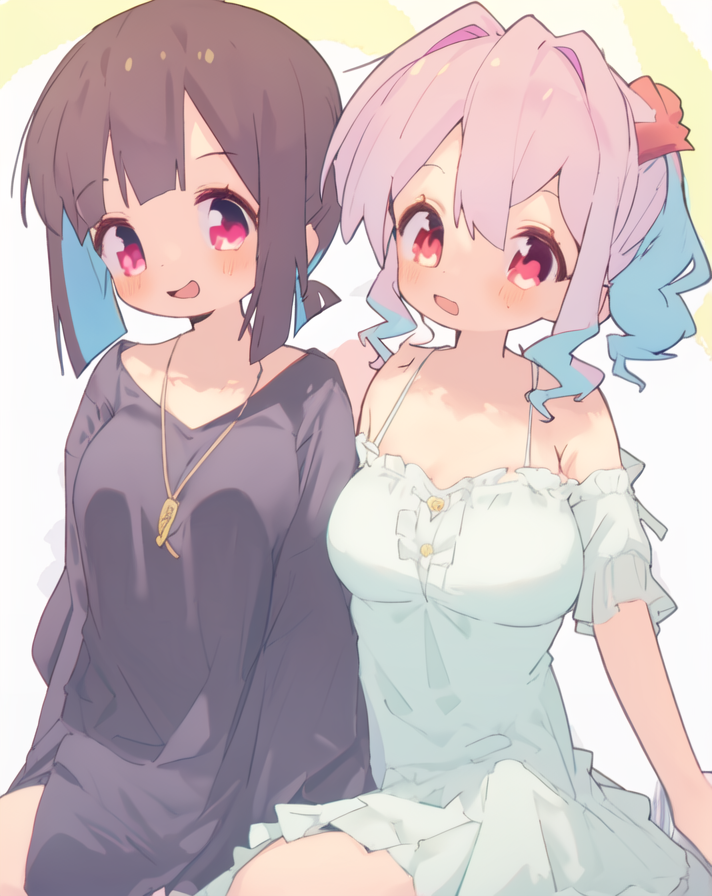
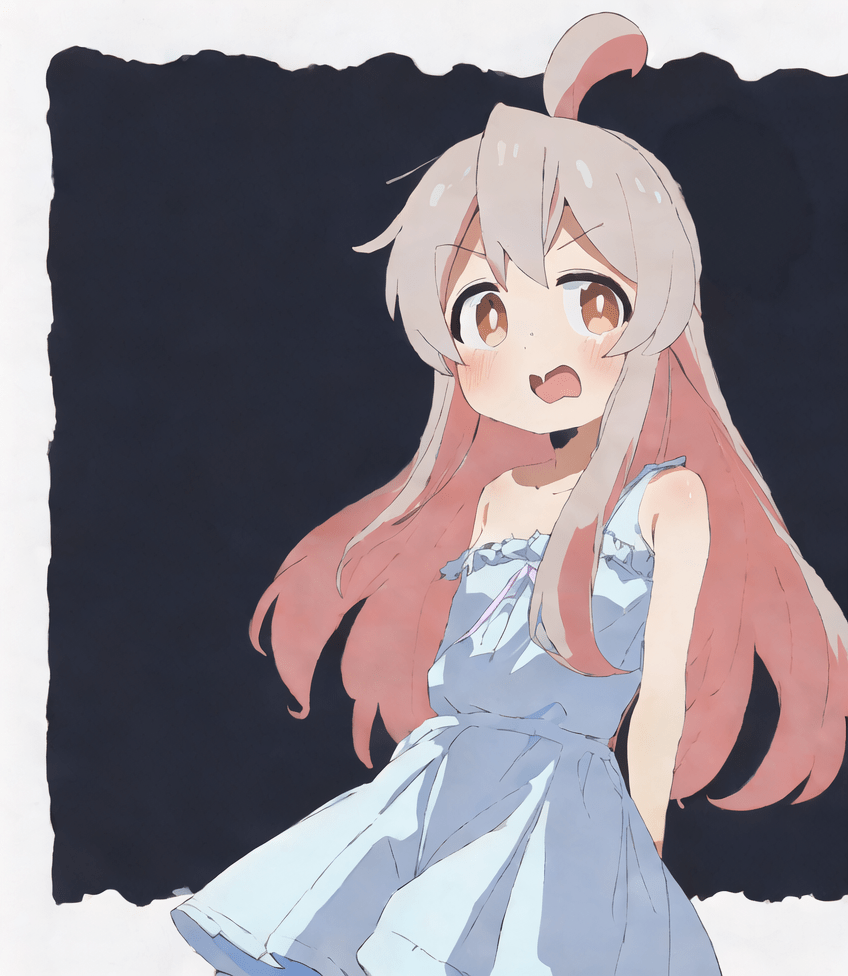
00119-20230220043346.png 00107-20230220042026.png 00131-20230220045301.png

P.S. I would still suggest using the full model if you want more complex scenes, or more fidelity to the styles and outfits. You can always alter the style by merging models.

Usage

The model is shared in both diffuser and safetensors formats. As for the trigger words, the six characters can be prompted with OyamaMahiro, OyamaMihari, HozukiKaede, HozukiMomiji, OkaAsahi, and MurosakiMiyo. TenkawaNayuta is tagged but she appears in fewer than 10 images so don't expect any good result. There are also three different styles trained into the model: aniscreen, edstyle, and megazine (yes, typo). As usual you can get multiple-character imagee but starting from 4 it is difficult. By the way, the model is trained at clip skip 1.

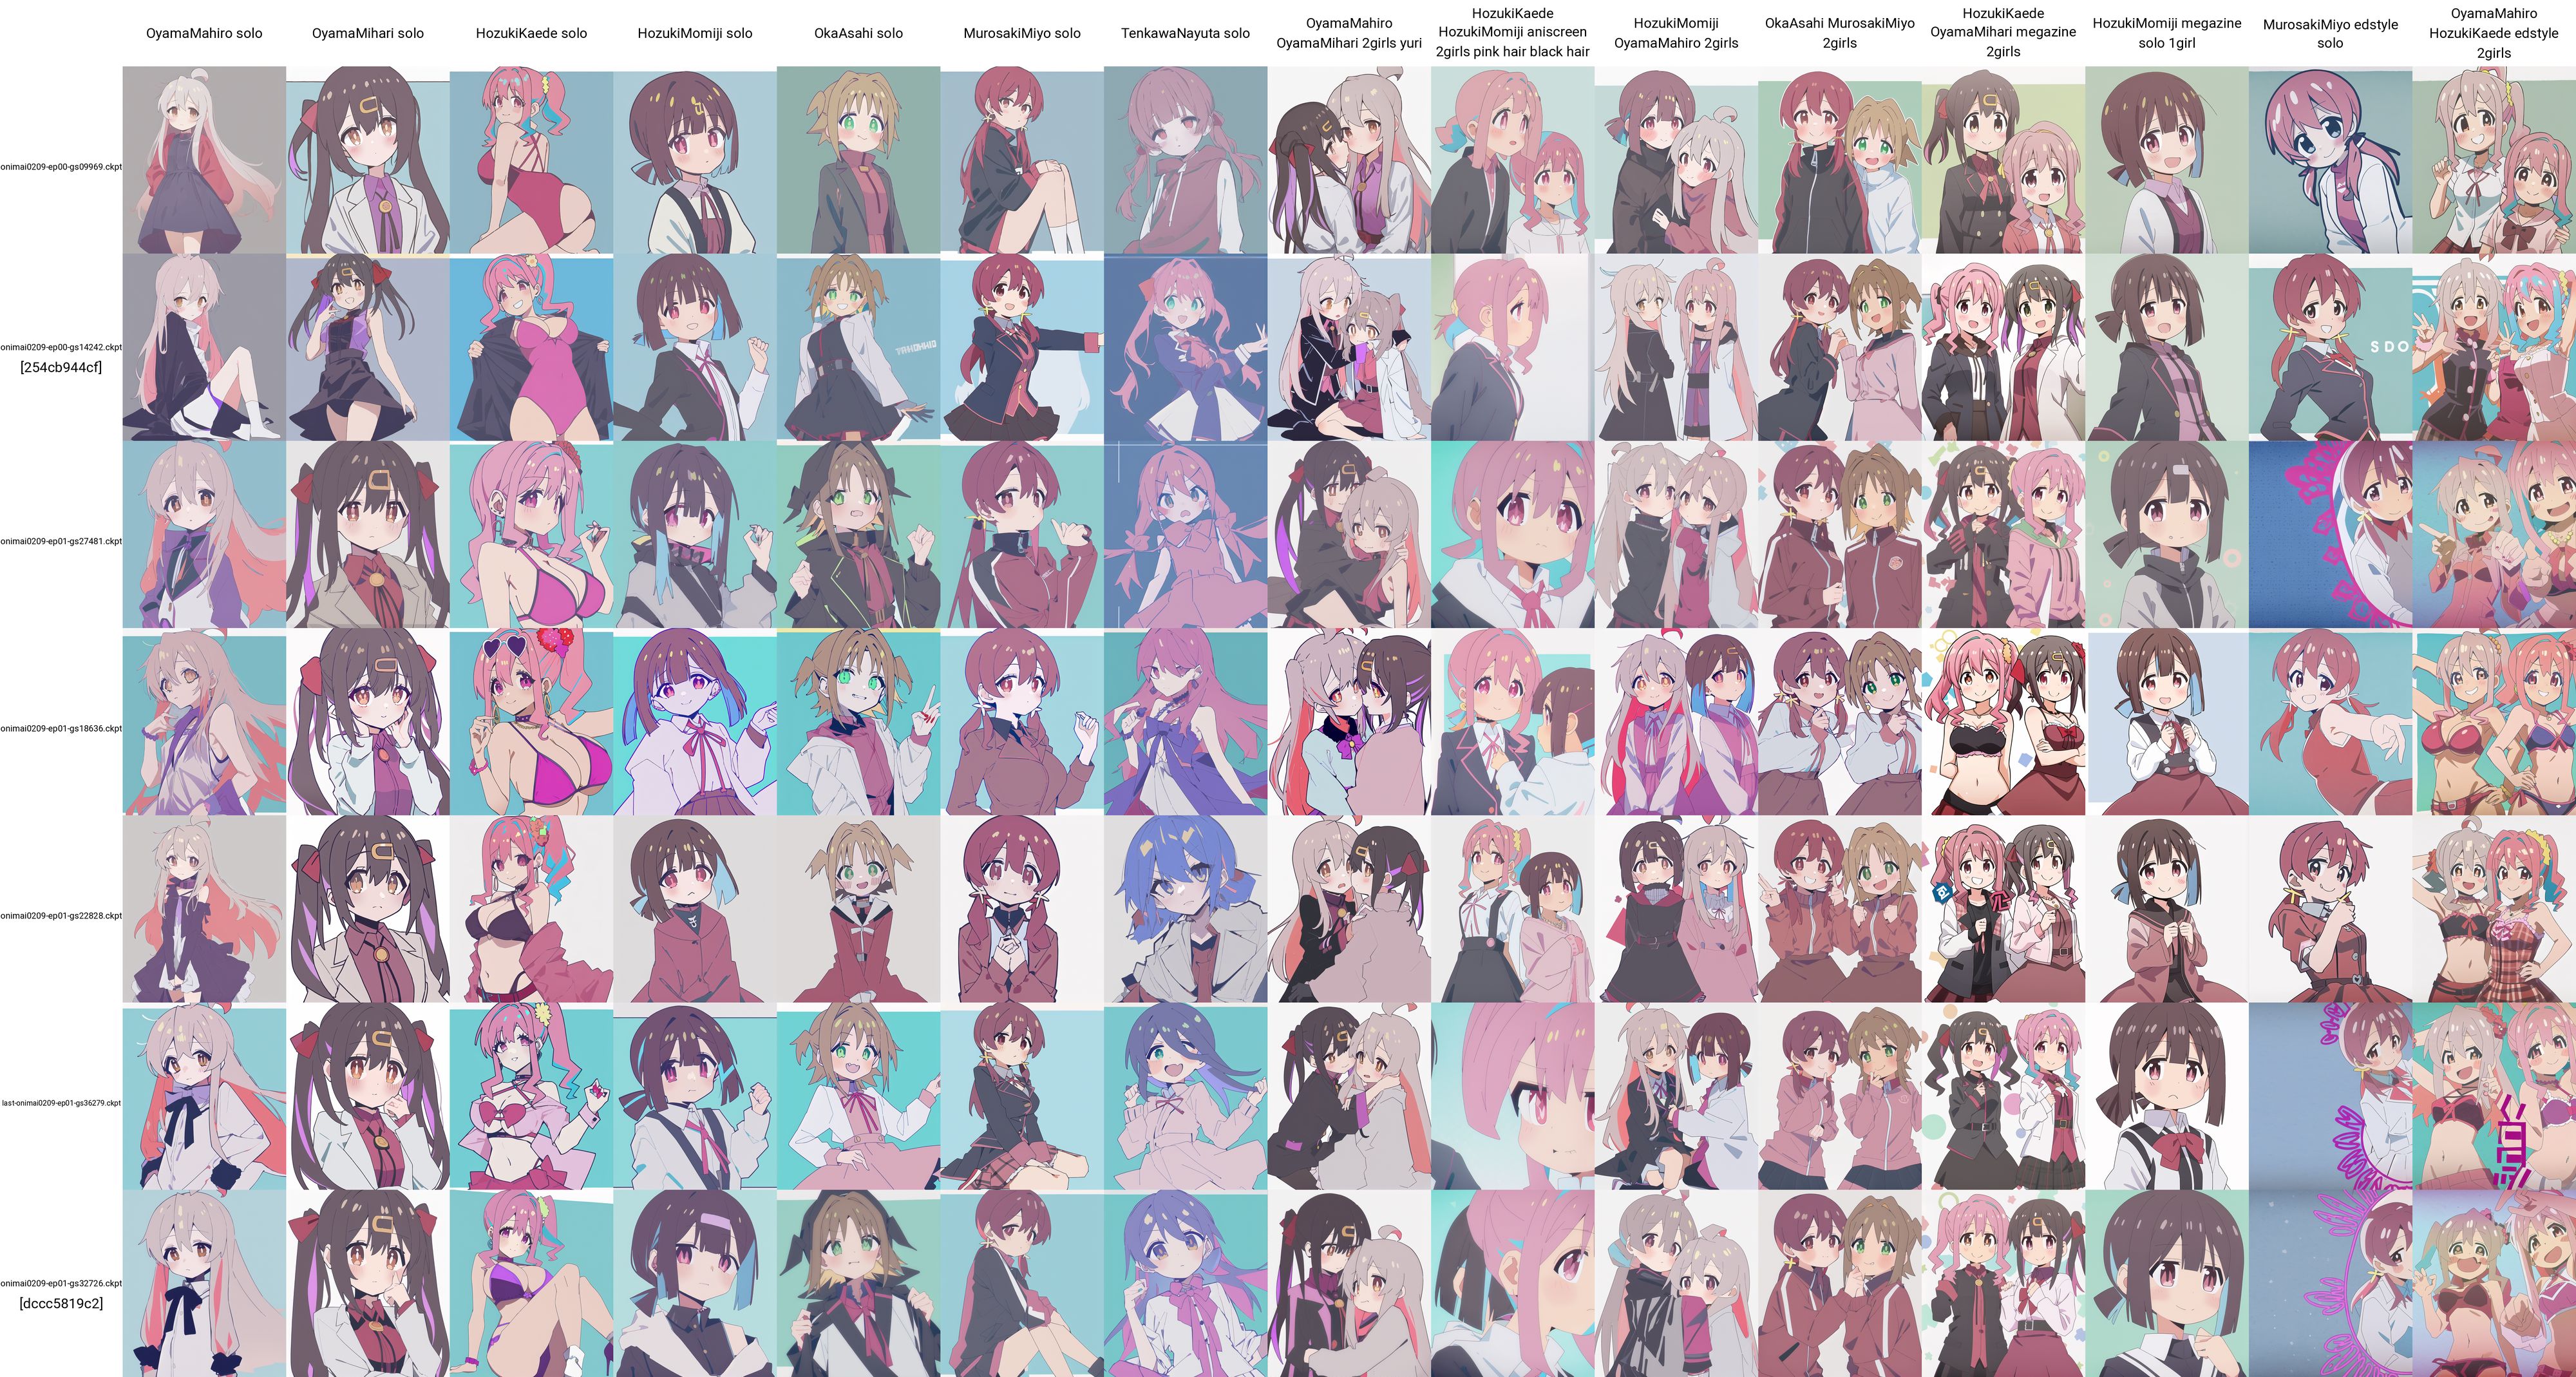
In the following images are shown the generations of different checkpoints. The default one is that of step 22828, but all the checkpoints starting from step 9969 can be found in the checkpoints directory. They are all sufficiently good at the six characters but later ones are better at megazine and edstyle (at the risk of overfitting, I don't really know).
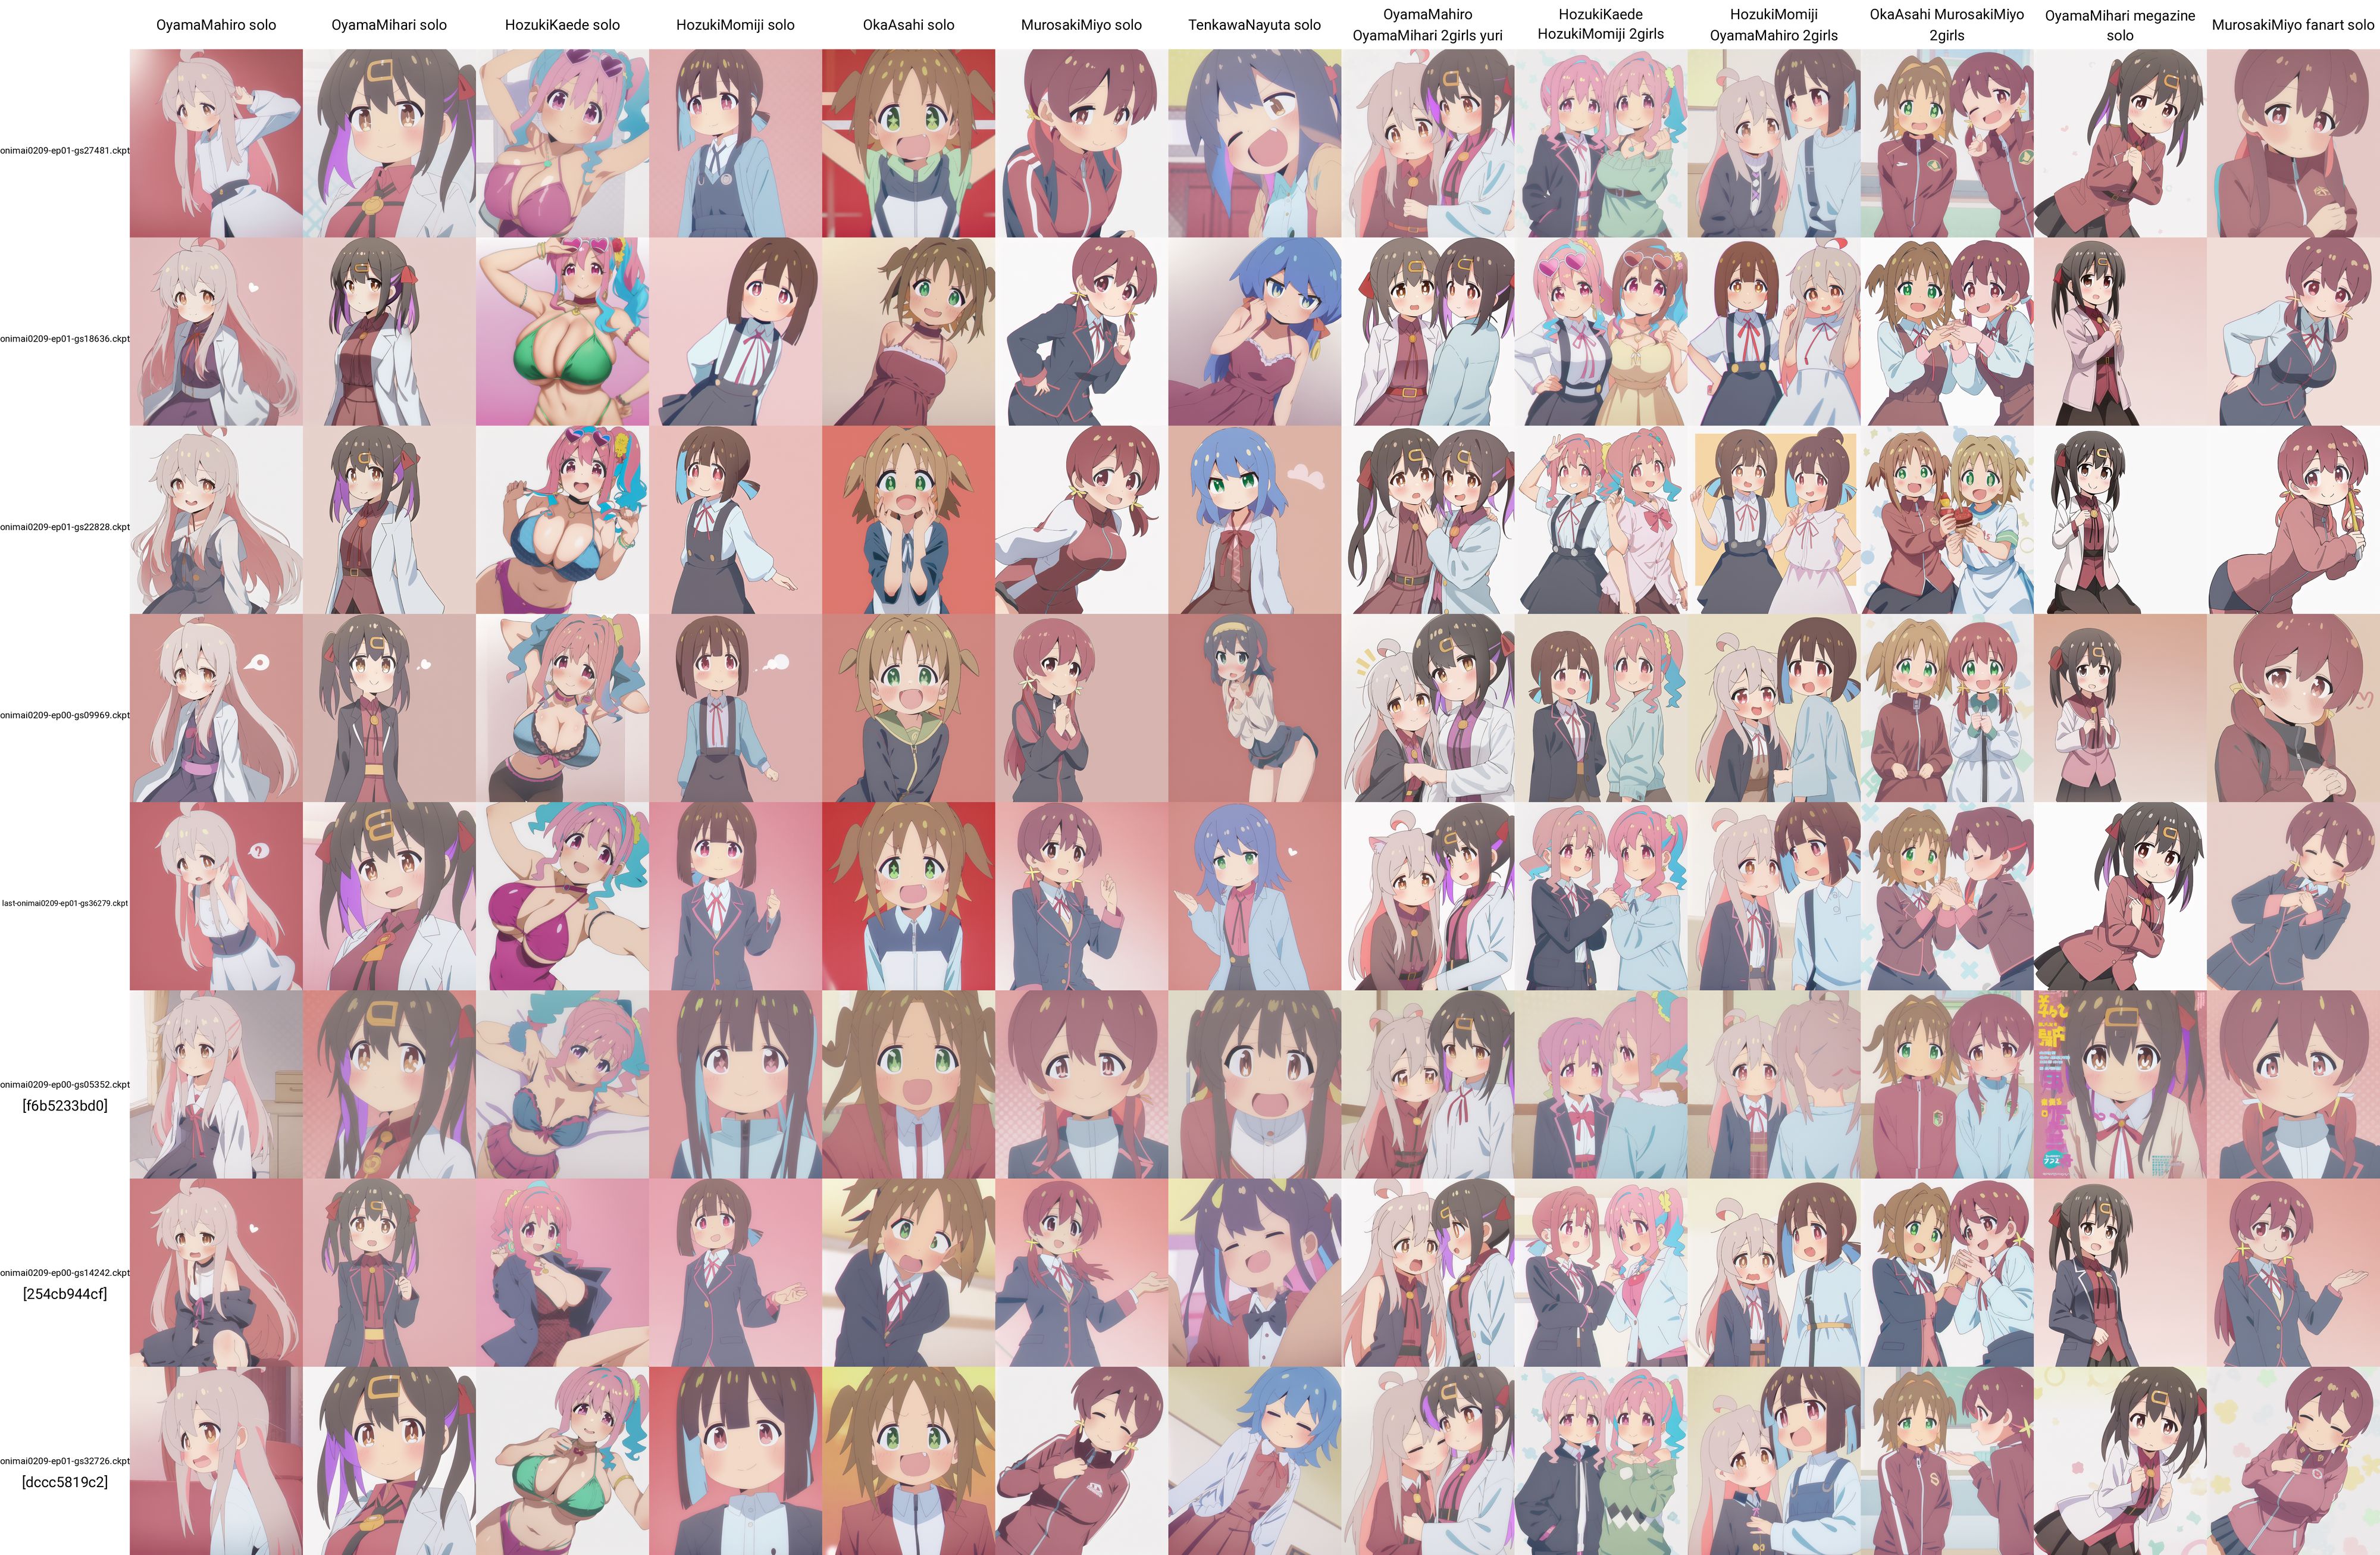
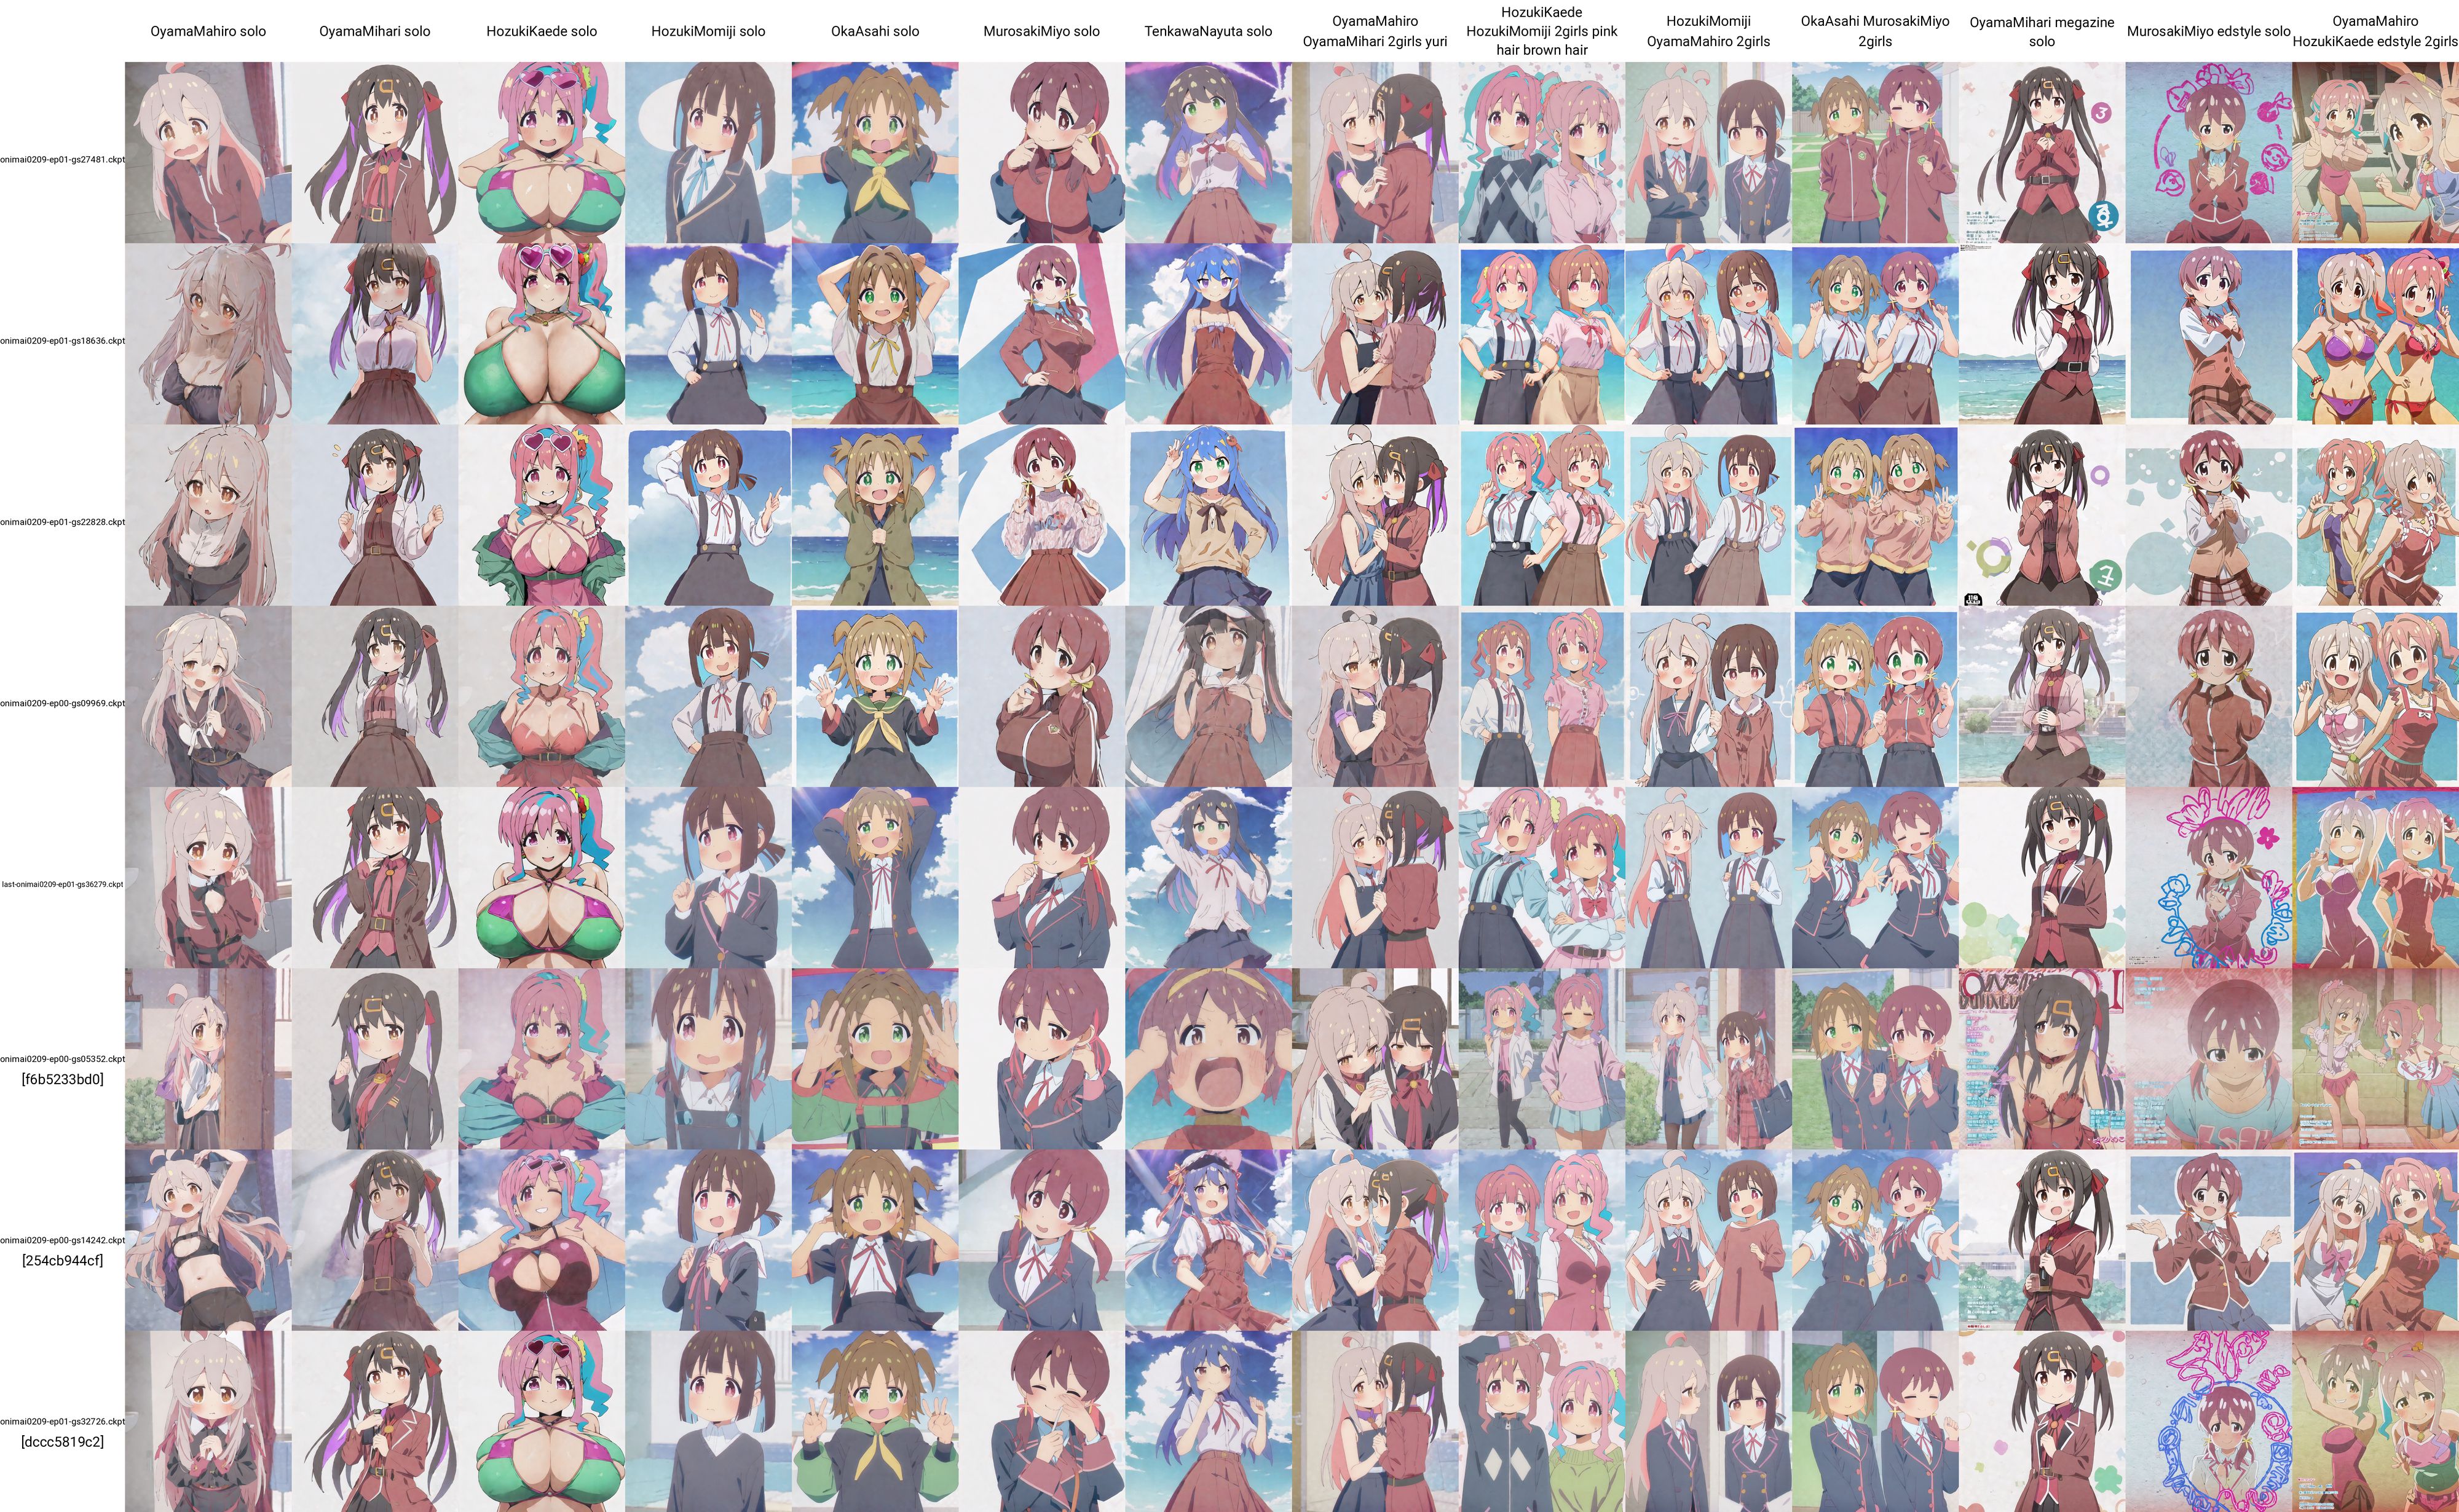
xyz_grid-0000-20230210154700.jpg xyz_grid-0001-20230210155723.jpg xyz_grid-0006-20230210163625.jpg

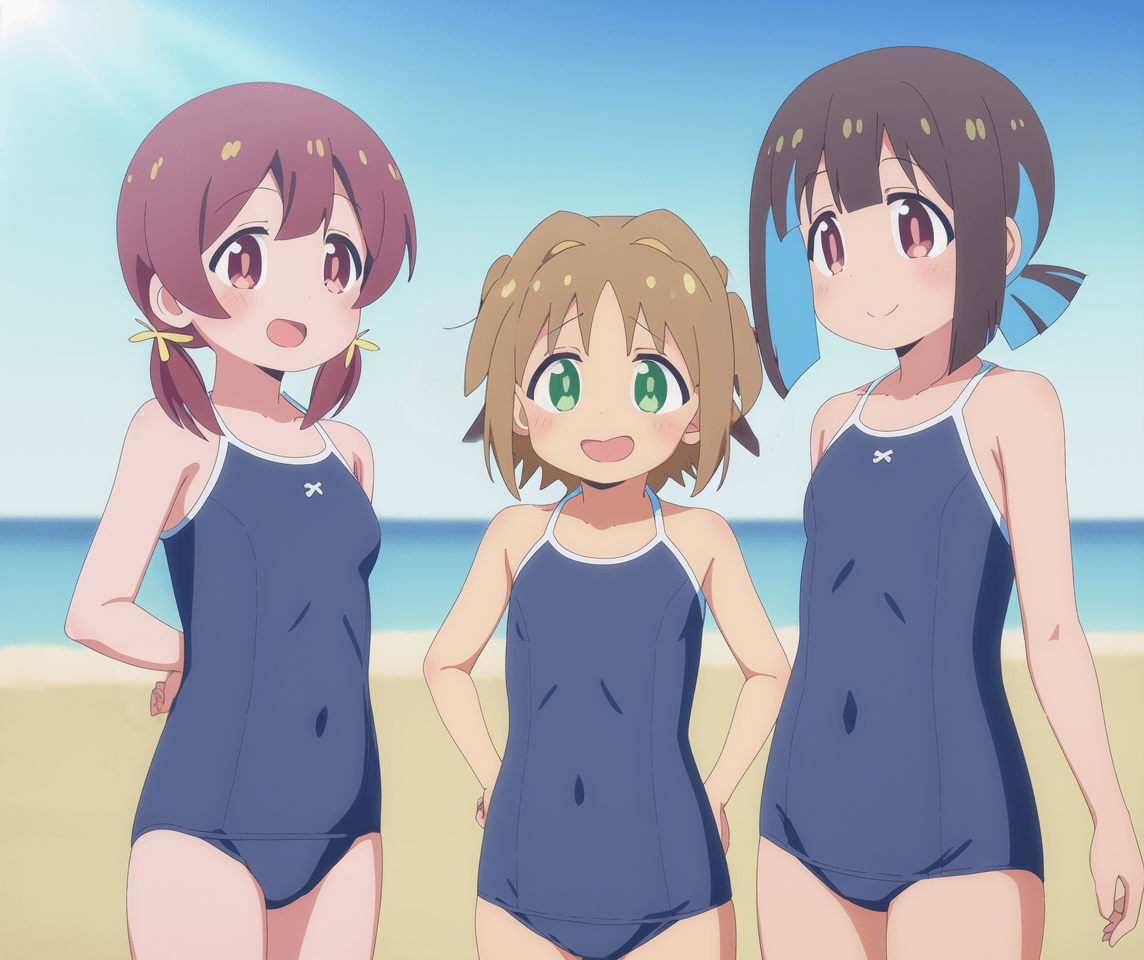
More Generations

00011-20230210182642-min.png 00003-20230210175009-min.png 00005-20230210175301-min.png 00016-20230210183918-min.png 00019-20230210184731-min.png 00038-20230210194326-min.png 00039-20230210194529-min.png 00043-20230210195945-min.png 00047-20230210202801-min.png

Dataset Description

The dataset is prepared via the workflow detailed here: https://github.com/cyber-meow/anime_screenshot_pipeline

It contains 21412 images with the following composition

  • 2133 onimai images separated in four types
    • 1496 anime screenshots from the first six episodes (for style aniscreen)
    • 70 screenshots of the ending of the anime (for style edstyle, not counted in the 1496 above)
    • 528 fan arts (or probably some official arts)
    • 39 scans of the covers of the mangas (for style megazine, don't ask me why I choose this name, it is bad but it turns out to work)
  • 19279 regularization images which intend to be as various as possible while being in anime style (i.e. no photorealistic image is used)

Note that the model is trained with a specific weighting scheme to balance between different concepts so that every image does not weight equally. After applying the per-image repeat we get around 145K images per epoch.

Training

Training is done with EveryDream2 trainer with ACertainty as base model. The following configuration is used

  • resolution 512
  • cosine learning rate scheduler, lr 2.5e-6
  • batch size 8
  • conditional dropout 0.08
  • change beta scheduler from scaler_linear to linear in config.json of the scheduler of the model
  • clip skip 1

I trained for two epochs wheareas the default release model was trained for 22828 steps as mentioned above.

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм

Можно запустить

Подбираем GPU…

Ревизия весов
ea05e3a

0 моделей