

简介
EasyAnimate是一个基于transformer结构的pipeline,可用于生成AI图片与视频、训练Diffusion Transformer的基线模型与Lora模型,我们支持从已经训练好的EasyAnimate模型直接进行预测,生成不同分辨率,6秒左右、fps8的视频(EasyAnimateV5.1,1 ~ 49帧),也支持用户训练自己的基线模型与Lora模型,进行一定的风格变换。
模型地址
EasyAnimateV5.1:
7B:
| 名称 | 种类 | 存储空间 | Hugging Face | Model Scope | 描述 |
|---|---|---|---|---|---|
| EasyAnimateV5.1-7b-zh-InP | EasyAnimateV5.1 | 30 GB | 🤗Link | 😄Link | 官方的图生视频权重。支持多分辨率(512,768,1024)的视频预测,支持多分辨率(512,768,1024)的视频预测,以49帧、每秒8帧进行训练,支持多语言预测 |
| EasyAnimateV5.1-7b-zh-Control | EasyAnimateV5.1 | 30 GB | 🤗Link | 😄Link | 官方的视频控制权重,支持不同的控制条件,如Canny、Depth、Pose、MLSD等,同时支持使用轨迹控制。支持多分辨率(512,768,1024)的视频预测,支持多分辨率(512,768,1024)的视频预测,以49帧、每秒8帧进行训练,支持多语言预测 |
| EasyAnimateV5.1-7b-zh-Control-Camera | EasyAnimateV5.1 | 30 GB | 🤗Link | 😄Link | 官方的视频相机控制权重,支持通过输入相机运动轨迹控制生成方向。支持多分辨率(512,768,1024)的视频预测,支持多分辨率(512,768,1024)的视频预测,以49帧、每秒8帧进行训练,支持多语言预测 |
| EasyAnimateV5.1-7b-zh | EasyAnimateV5.1 | 30 GB | 🤗Link | 😄Link | 官方的文生视频权重。支持多分辨率(512,768,1024)的视频预测,支持多分辨率(512,768,1024)的视频预测,以49帧、每秒8帧进行训练,支持多语言预测 |
12B:
| 名称 | 种类 | 存储空间 | Hugging Face | Model Scope | 描述 |
|---|---|---|---|---|---|
| EasyAnimateV5.1-12b-zh-InP | EasyAnimateV5.1 | 39 GB | 🤗Link | 😄Link | 官方的图生视频权重。支持多分辨率(512,768,1024)的视频预测,支持多分辨率(512,768,1024)的视频预测,以49帧、每秒8帧进行训练,支持多语言预测 |
| EasyAnimateV5.1-12b-zh-Control | EasyAnimateV5.1 | 39 GB | 🤗Link | 😄Link | 官方的视频控制权重,支持不同的控制条件,如Canny、Depth、Pose、MLSD等,同时支持使用轨迹控制。支持多分辨率(512,768,1024)的视频预测,支持多分辨率(512,768,1024)的视频预测,以49帧、每秒8帧进行训练,支持多语言预测 |
| EasyAnimateV5.1-12b-zh-Control-Camera | EasyAnimateV5.1 | 39 GB | 🤗Link | 😄Link | 官方的视频相机控制权重,支持通过输入相机运动轨迹控制生成方向。支持多分辨率(512,768,1024)的视频预测,支持多分辨率(512,768,1024)的视频预测,以49帧、每秒8帧进行训练,支持多语言预测 |
| EasyAnimateV5.1-12b-zh | EasyAnimateV5.1 | 39 GB | 🤗Link | 😄Link | 官方的文生视频权重。支持多分辨率(512,768,1024)的视频预测,支持多分辨率(512,768,1024)的视频预测,以49帧、每秒8帧进行训练,支持多语言预测 |
视频作品
图生视频 EasyAnimateV5.1-12b-zh-InP
文生视频 EasyAnimateV5.1-12b-zh
控制生视频 EasyAnimateV5.1-12b-zh-Control
轨迹控制
普通控制生视频(Canny、Pose、Depth等)
相机镜头控制 EasyAnimateV5.1-12b-zh-Control-Camera
如何使用
a、显存节省方案
由于EasyAnimateV5和V5.1的参数非常大,我们需要考虑显存节省方案,以节省显存适应消费级显卡。我们给每个预测文件都提供了GPU_memory_mode,可以在model_cpu_offload,model_cpu_offload_and_qfloat8,sequential_cpu_offload中进行选择。
- model_cpu_offload代表整个模型在使用后会进入cpu,可以节省部分显存。
- model_cpu_offload_and_qfloat8代表整个模型在使用后会进入cpu,并且对transformer模型进行了float8的量化,可以节省更多的显存。
- sequential_cpu_offload代表模型的每一层在使用后会进入cpu,速度较慢,节省大量显存。
qfloat8会降低模型的性能,但可以节省更多的显存。如果显存足够,推荐使用model_cpu_offload。
b、通过comfyui
具体查看ComfyUI README。
c、运行python文件
- 步骤1:下载对应权重放入models文件夹。
- 步骤2:根据不同的权重与预测目标使用不同的文件进行预测。
- 文生视频:
- 使用predict_t2v.py文件中修改prompt、neg_prompt、guidance_scale和seed。
- 而后运行predict_t2v.py文件,等待生成结果,结果保存在samples/easyanimate-videos文件夹中。
- 图生视频:
- 使用predict_i2v.py文件中修改validation_image_start、validation_image_end、prompt、neg_prompt、guidance_scale和seed。
- validation_image_start是视频的开始图片,validation_image_end是视频的结尾图片。
- 而后运行predict_i2v.py文件,等待生成结果,结果保存在samples/easyanimate-videos_i2v文件夹中。
- 视频生视频:
- 使用predict_v2v.py文件中修改validation_video、validation_image_end、prompt、neg_prompt、guidance_scale和seed。
- validation_video是视频生视频的参考视频。您可以使用以下视频运行演示:演示视频
- 而后运行predict_v2v.py文件,等待生成结果,结果保存在samples/easyanimate-videos_v2v文件夹中。
- 普通控制生视频(Canny、Pose、Depth等):
- 使用predict_v2v_control.py文件中修改control_video、validation_image_end、prompt、neg_prompt、guidance_scale和seed。
- control_video是控制生视频的控制视频,是使用Canny、Pose、Depth等算子提取后的视频。您可以使用以下视频运行演示:演示视频
- 而后运行predict_v2v_control.py文件,等待生成结果,结果保存在samples/easyanimate-videos_v2v_control文件夹中。
- 轨迹控制视频:
- 相机控制视频:
- 使用predict_v2v_control.py文件中修改control_video、ref_image、validation_image_end、prompt、neg_prompt、guidance_scale和seed。
- control_camera_txt是相机控制视频的控制文件,ref_image是参考的首帧图片。您可以使用以下图片和控制视频运行演示:演示图像,演示文件(来自于CameraCtrl)
- 而后运行predict_v2v_control.py文件,等待生成结果,结果保存在samples/easyanimate-videos_v2v_control文件夹中。
- 推荐使用ComfyUI进行交互。
- 文生视频:
- 步骤3:如果想结合自己训练的其他backbone与Lora,则看情况修改predict_t2v.py中的predict_t2v.py和lora_path。


d、通过ui界面
webui支持文生视频、图生视频、视频生视频和普通控制生视频(Canny、Pose、Depth等)
- 步骤1:下载对应权重放入models文件夹。
- 步骤2:运行app.py文件,进入gradio页面。
- 步骤3:根据页面选择生成模型,填入prompt、neg_prompt、guidance_scale和seed等,点击生成,等待生成结果,结果保存在sample文件夹中。
快速启动
1. 云使用: AliyunDSW/Docker
a. 通过阿里云 DSW
DSW 有免费 GPU 时间,用户可申请一次,申请后3个月内有效。
阿里云在Freetier提供免费GPU时间,获取并在阿里云PAI-DSW中使用,5分钟内即可启动EasyAnimate
b. 通过ComfyUI
我们的ComfyUI界面如下,具体查看ComfyUI README。
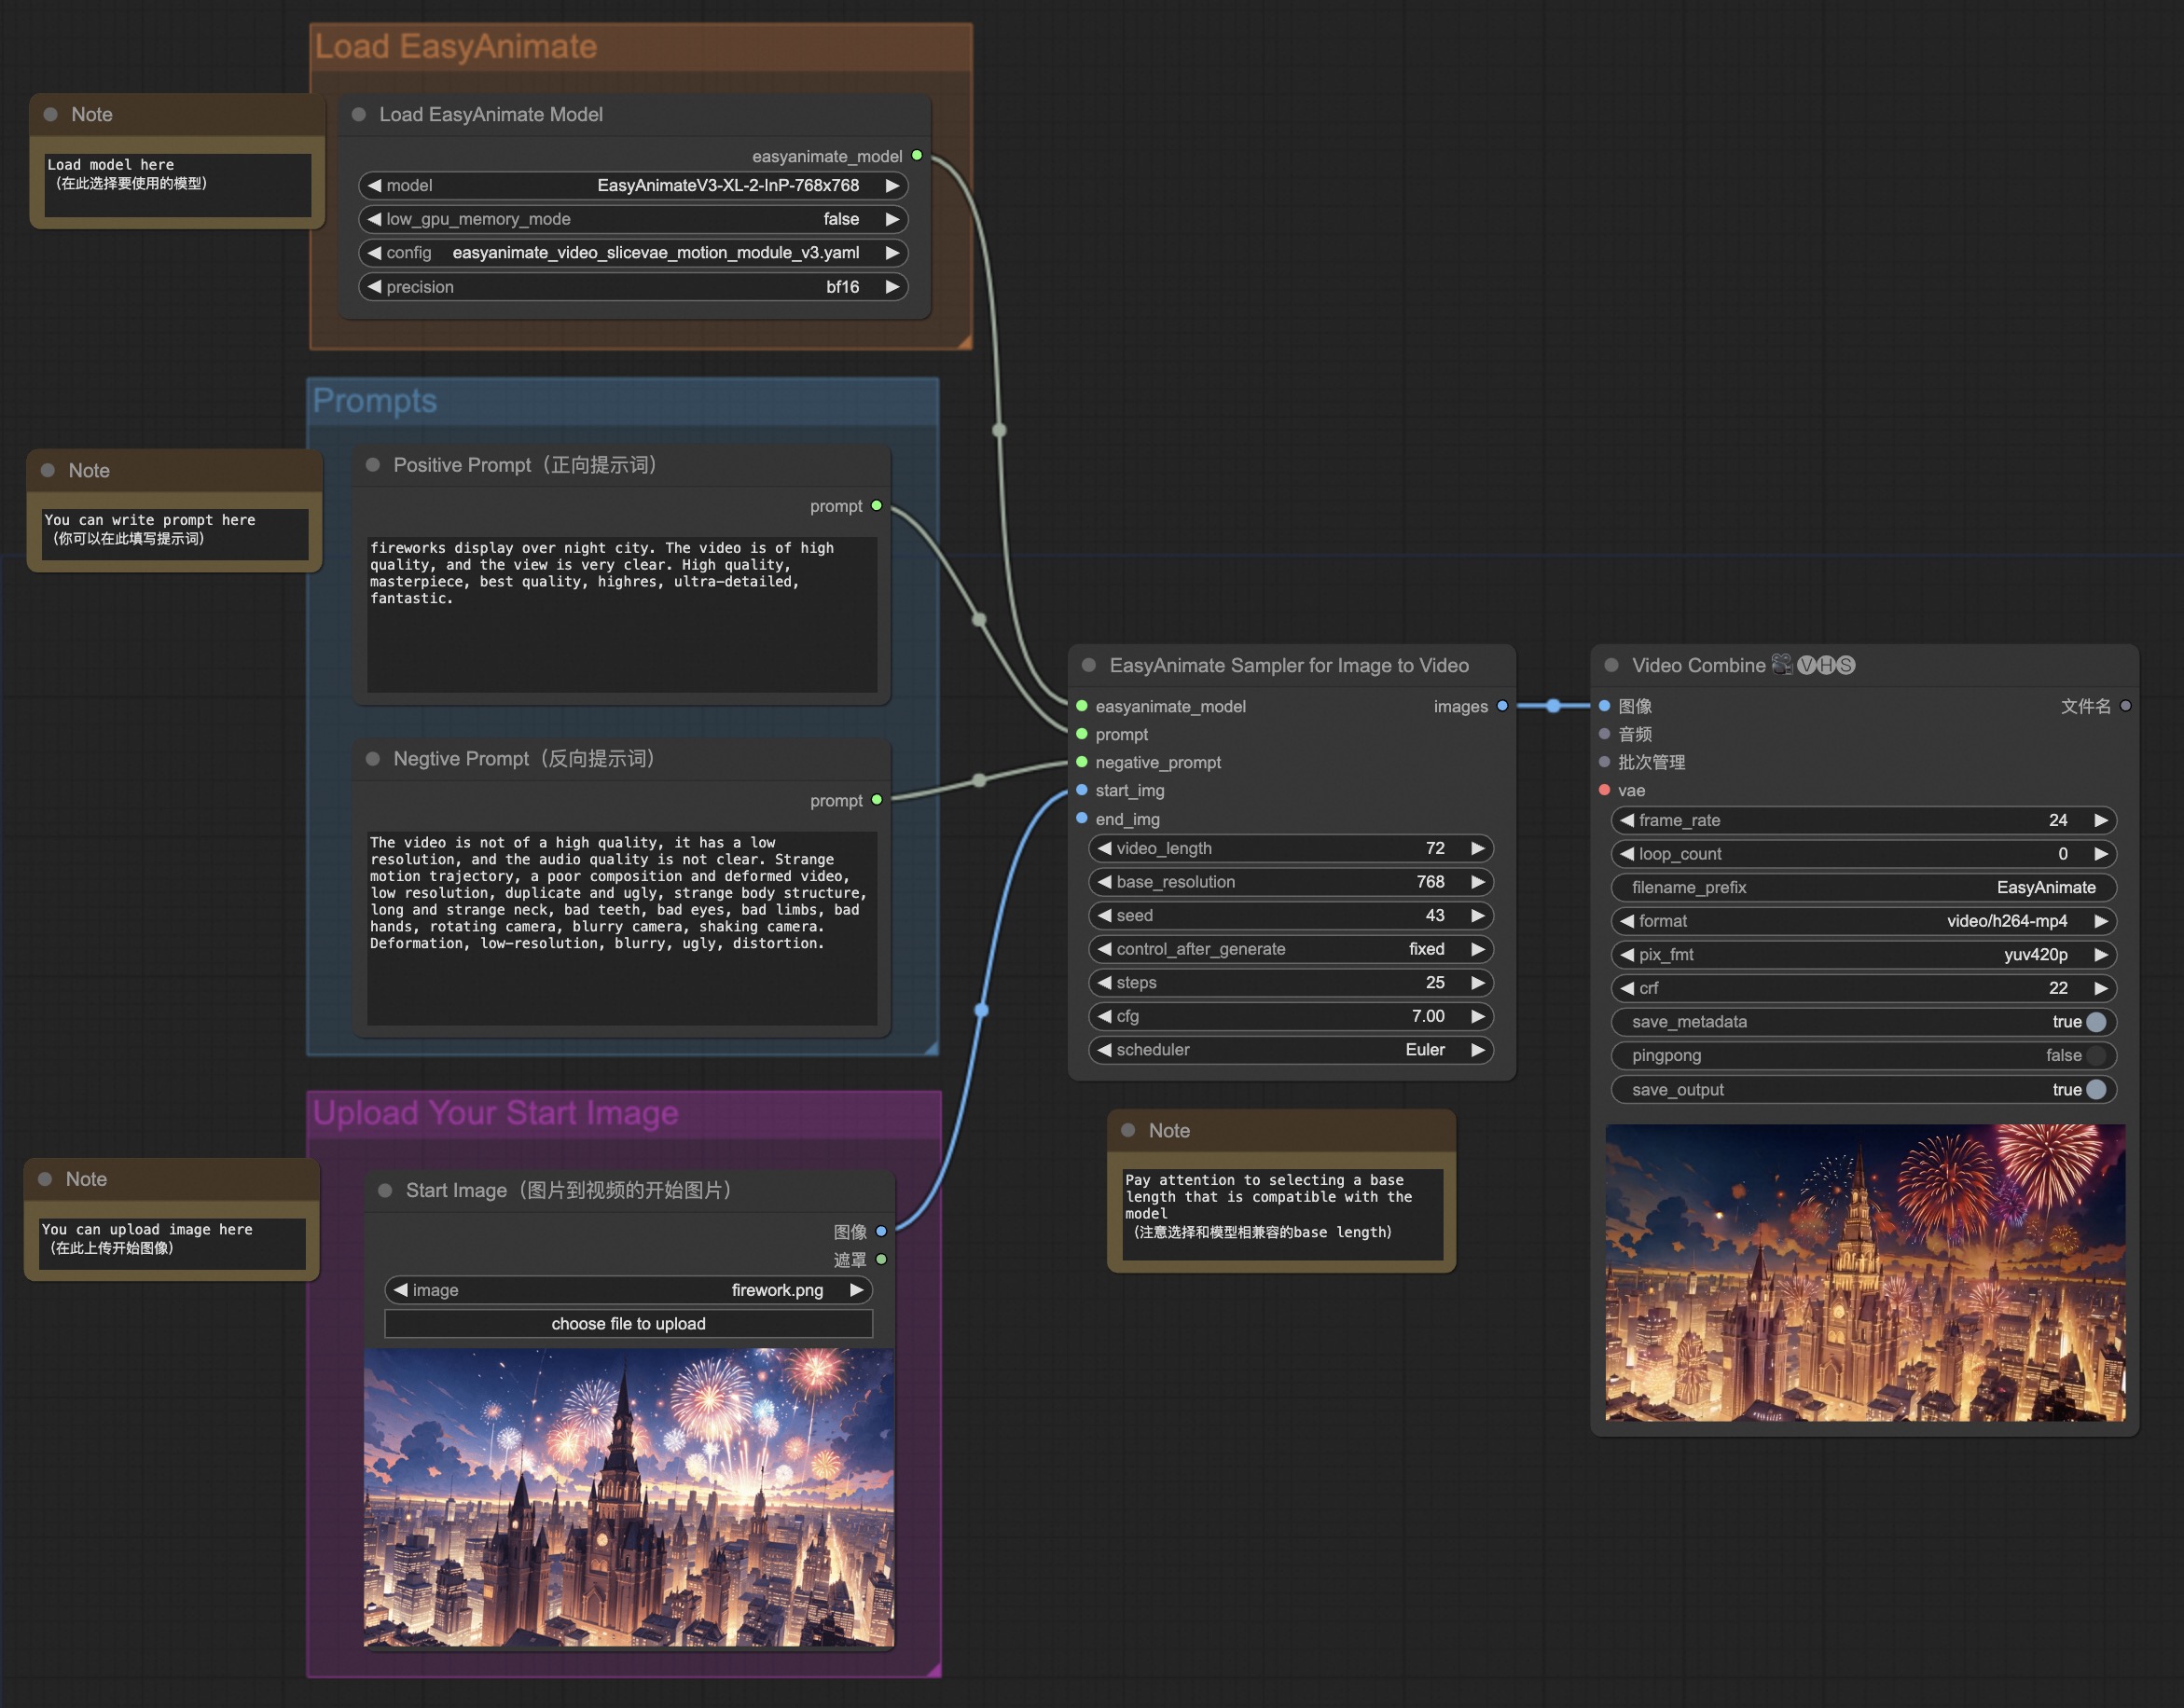
c. 通过docker
使用docker的情况下,请保证机器中已经正确安装显卡驱动与CUDA环境,然后以此执行以下命令:
# pull image
docker pull mybigpai-public-registry.cn-beijing.cr.aliyuncs.com/easycv/torch_cuda:easyanimate

# enter image
docker run -it -p 7860:7860 --network host --gpus all --security-opt seccomp:unconfined --shm-size 200g mybigpai-public-registry.cn-beijing.cr.aliyuncs.com/easycv/torch_cuda:easyanimate

# clone code
git clone https://github.com/aigc-apps/EasyAnimate.git

# enter EasyAnimate's dir
cd EasyAnimate

# download weights
mkdir models/Diffusion_Transformer
mkdir models/Motion_Module
mkdir models/Personalized_Model

# Please use the hugginface link or modelscope link to download the EasyAnimateV5.1 model.
# https://huggingface.co/alibaba-pai/EasyAnimateV5.1-12b-zh-InP
# https://modelscope.cn/models/PAI/EasyAnimateV5.1-12b-zh-InP
2. 本地安装: 环境检查/下载/安装
a. 环境检查
我们已验证EasyAnimate可在以下环境中执行:
Windows 的详细信息:
- 操作系统 Windows 10
- python: python3.10 & python3.11
- pytorch: torch2.2.0
- CUDA: 11.8 & 12.1
- CUDNN: 8+
- GPU: Nvidia-3060 12G
Linux 的详细信息:
- 操作系统 Ubuntu 20.04, CentOS
- python: python3.10 & python3.11
- pytorch: torch2.2.0
- CUDA: 11.8 & 12.1
- CUDNN: 8+
- GPU:Nvidia-V100 16G & Nvidia-A10 24G & Nvidia-A100 40G & Nvidia-A100 80G
我们需要大约 60GB 的可用磁盘空间,请检查!
EasyAnimateV5.1-12B的视频大小可以由不同的GPU Memory生成,包括:
| GPU memory | 384x672x25 | 384x672x49 | 576x1008x25 | 576x1008x49 | 768x1344x25 | 768x1344x49 |
|---|---|---|---|---|---|---|
| 16GB | 🧡 | ⭕️ | ⭕️ | ⭕️ | ❌ | ❌ |
| 24GB | 🧡 | 🧡 | 🧡 | 🧡 | 🧡 | ❌ |
| 40GB | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| 80GB | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
EasyAnimateV5.1-7B的视频大小可以由不同的GPU Memory生成,包括:
| GPU memory | 384x672x25 | 384x672x49 | 576x1008x25 | 576x1008x49 | 768x1344x25 | 768x1344x49 |
|---|---|---|---|---|---|---|
| 16GB | 🧡 | 🧡 | ⭕️ | ⭕️ | ❌ | ❌ |
| 24GB | ✅ | ✅ | ✅ | 🧡 | 🧡 | ❌ |
| 40GB | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| 80GB | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
✅ 表示它可以在"model_cpu_offload"的情况下运行,🧡代表它可以在"model_cpu_offload_and_qfloat8"的情况下运行,⭕️ 表示它可以在"sequential_cpu_offload"的情况下运行,❌ 表示它无法运行。请注意,使用sequential_cpu_offload运行会更慢。
有一些不支持torch.bfloat16的卡型,如2080ti、V100,需要将app.py、predict文件中的weight_dtype修改为torch.float16才可以运行。
EasyAnimateV5.1-12B使用不同GPU在25个steps中的生成时间如下:
| GPU | 384x672x72 | 384x672x49 | 576x1008x25 | 576x1008x49 | 768x1344x25 | 768x1344x49 |
|---|---|---|---|---|---|---|
| A10 24GB | 约120秒 (4.8s/it) | 约240秒 (9.6s/it) | 约320秒 (12.7s/it) | 约750秒 (29.8s/it) | ❌ | ❌ |
| A100 80GB | 约45秒 (1.75s/it) | 约90秒 (3.7s/it) | 约120秒 (4.7s/it) | 约300秒 (11.4s/it) | 约265秒 (10.6s/it) | 约710秒 (28.3s/it) |
b. 权重放置
我们最好将权重按照指定路径进行放置:
EasyAnimateV5.1:
📦 models/
├── 📂 Diffusion_Transformer/
│   ├── 📂 EasyAnimateV5.1-12b-zh-InP/
│   ├── 📂 EasyAnimateV5.1-12b-zh-Control/
│   ├── 📂 EasyAnimateV5.1-12b-zh-Control-Camera/
│   └── 📂 EasyAnimateV5.1-12b-zh/
├── 📂 Personalized_Model/
│   └── your trained trainformer model / your trained lora model (for UI load)
联系我们
- 扫描下方二维码或搜索群号:77450006752 来加入钉钉群。
- 扫描下方二维码来加入微信群(如果二维码失效,可扫描最右边同学的微信,邀请您入群)
参考文献
- CogVideo: https://github.com/THUDM/CogVideo/
- Flux: https://github.com/black-forest-labs/flux
- magvit: https://github.com/google-research/magvit
- PixArt: https://github.com/PixArt-alpha/PixArt-alpha
- Open-Sora-Plan: https://github.com/PKU-YuanGroup/Open-Sora-Plan
- Open-Sora: https://github.com/hpcaitech/Open-Sora
- Animatediff: https://github.com/guoyww/AnimateDiff
- HunYuan DiT: https://github.com/tencent/HunyuanDiT
- ComfyUI-KJNodes: https://github.com/kijai/ComfyUI-KJNodes
- ComfyUI-EasyAnimateWrapper: https://github.com/kijai/ComfyUI-EasyAnimateWrapper
- ComfyUI-CameraCtrl-Wrapper: https://github.com/chaojie/ComfyUI-CameraCtrl-Wrapper
- CameraCtrl: https://github.com/hehao13/CameraCtrl
- DragAnything: https://github.com/showlab/DragAnything
许可证
本项目采用 Apache License (Version 2.0).