/ Модель

Характеристики

Контекст
512 токенов
Параметры
40,9 млн
Лицензия
MIT
Архитектура
bert · dense
Базовая модель
multilingual-e5-small
Библиотека
sentence-transformers
Опубликована
19 окт 2025

multilingual-e5-small-fra-32768

ЭмбеддингиТекст → embedding9 профессий

multilingual-e5-small-fra-32768 — текстовая модель эмбеддингов, опубликованная alphaedge-ai на основе intfloat/multilingual-e5-small.

4 410скачиваний за 30 дней0лайковвеса обновлены20 мая 2026

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Тесты пользователейпока нет

Никто ещё не опубликовал тест этой модели. Соберите бенчмарк из своих задач — результат появится здесь.

  1. Добавьте модель в бенчмарк

    Вместе с другими моделями категории «Эмбеддинги» — сравнение идёт внутри одной категории.

  2. Опишите свои задачи

    Напишите запросы, при необходимости приложите файлы и эталонные ответы.

  3. Запустите и опубликуйте

    Модели ответят на каждую задачу, судья оценит ответы. Опубликованный результат появится на этой странице.

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

Она предназначена для задач семантического сравнения предложений, поиска и ранжирования документов, сопоставления запросов с фрагментами текста и других сценариев, где требуется преобразование текста в векторные представления. Модель интегрируется с библиотекой sentence-transformers и поддерживает раздельное кодирование запросов и документов.

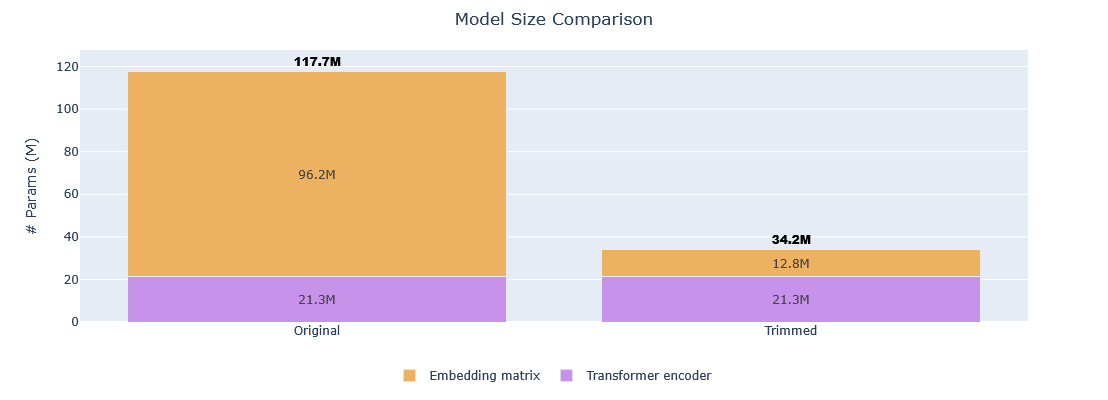
Модель оптимизирована для французского языка за счёт сокращения словаря методом trimming. Размер словаря уменьшен с 250 037 до 32 768 токенов, а количество параметров — с 117 653 760 до 34 222 464, что соответствует уменьшению размера примерно на 70,91%. По заявлению авторов, при французских текстах она должна демонстрировать результаты, близкие к исходной multilingual-e5-small, при существенно меньшем потреблении памяти. Архитектурные детали, размер контекста и поддержка других модальностей в README не указаны; заявлена только работа с текстом.

Главное ограничение — возможное заметное ухудшение качества на языках, отличных от французского, поскольку редко используемые для выбранного языка токены были удалены. Модель распространяется по лицензии MIT.

Для каких профессий подходит9

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Также подходит для

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

multilingual-e5-small-fra-32768

This model is a 70.91% smaller version of intfloat/multilingual-e5-small optimized for French language via vocabulary size reduction using the trimming method.
This trimmed model should perform similarly to the original model with only 32,768 tokens and a much smaller memory footprint. However, it may not perform well for other languages as tokens not commonly used in the selected languages were removed from the vocabulary.

Model Statistics

MetricOriginalTrimmedReduction
Vocabulary size250,037 tokens32,768 tokens86.89%
Model size117,653,760 params34,222,464 params70.91%

image

Mining Dataset Statistics

Usage

from sentence_transformers import SentenceTransformer
# Download from the 🤗 Hub
model = SentenceTransformer("alphaedge-ai/multilingual-e5-small-fra-32768")
# Run inference with queries and documents
query = "My query in French"
documents = [
    "Chunk in French",
    "Chunk in French",
    "Chunk in French",
]
query_embeddings = model.encode_query(query)
document_embeddings = model.encode_document(documents)
print(query_embeddings.shape, document_embeddings.shape)
# Compute similarities to determine a ranking
similarities = model.similarity(query_embeddings, document_embeddings)
print(similarities)

Citations

Multilingual E5

@article{wang2024multilingual,
  title={Multilingual E5 Text Embeddings: A Technical Report},
  author={Wang, Liang and Yang, Nan and Huang, Xiaolong and Yang, Linjun and Majumder, Rangan and Wei, Furu},
  journal={arXiv preprint arXiv:2402.05672},
  year={2024}
}

Trimming blog post

@misc{hf_blogpost_trimming,
      title={Introduction to Trimming}, 
      author={Loïck BOURDOIS and Tom AARSEN and Bram VANROY and Christopher AKIKI and Woojun JUNG and Manuel ROMERO and Prithiv SAKTHI},
      year={2026},
      url={https://huggingface.co/blog/lbourdois/introduction-to-trimming}, 
}

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм · sentence-transformers

Можно запустить

Подбираем GPU…

Класс архитектуры
BertModel
Ревизия весов
4da62c2

0 моделей