/ Модель

Характеристики

Лицензия
CreativeML OpenRAIL-M
Базовая модель
stable-diffusion-v1-5
Библиотека
diffusers
Опубликована
1 фев 2025

stable-diffusion-1.5_io16_amdgpu

Генерация изображенийТекст → изображение3 профессии

Вариант Stable Diffusion 1.5 от AMD для генерации изображений по текстовым запросам с вычислениями и вводом-выводом в fp16.

149скачиваний за 30 дней1лайквеса обновлены3 апр 2025

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

amd/stable-diffusion-1.5_io16_amdgpu — вариант Stable Diffusion 1.5, опубликованный AMD для генерации изображений по текстовым запросам. Модель предназначена для запуска через Diffusers и ONNX; суффикс io16 означает, что она принимает входные данные в fp16, выполняет операции в fp16 и выдаёт результат в fp16. Карточка также описывает вариант io32 для приложения Amuse, но он не является этим репозиторием.

Модель подходит для создания изображений по текстовым описаниям. Она основана на stable-diffusion-v1-5/stable-diffusion-v1-5; лицензия — CreativeML Open RAIL-M. Сведения о размере модели, контекстном окне и поддерживаемых естественных языках в предоставленных данных отсутствуют.

Сценарии применения

  • создание иллюстраций по текстовому описанию
  • генерация концепт-арта по запросу
  • создание изображений для графических макетов

Ограничения

Вариант io16 ожидает входные данные fp16 и работает в fp16, поэтому запуск требует совместимого программного окружения и аппаратной поддержки. README не приводит сведений о качестве генерации или ограничениях по темам.

Для каких профессий подходит3

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

stable-diffusion-1.5 optimized for AMD GPU

Original Model

https://huggingface.co/stable-diffusion-v1-5/stable-diffusion-v1-5

_io32/16

_io32: model input is fp32, model will convert the input to fp16, perform ops in fp16 and write the final result in fp32

_io16: model input is fp16, perform ops in fp16 and write the final result in fp16

Running

1. Using Amuse GUI Application

Use Amuse GUI application to run it: https://www.amuse-ai.com/ use _io32 model to run with Amuse application

2. Inference Demo

Use the code below to get started with the model.

With Python using Diffusers OnnxStableDiffusionPipeline

Required Modules

accelerate
numpy==1.26.4 # Due to newer version of numpy changing dtype when multiplying
diffusers
torch
transformers
onnxruntime-directml

Python Script

import onnxruntime as ort
from diffusers import OnnxStableDiffusionPipeline

model_dir = "D:\\Models\\stable-diffusion-v1-5_io32"

batch_size = 1
num_inference_steps = 30
image_size = 512
guidance_scale = 7.5
prompt = "a beautiful cabin in the mountains of Lake Tahoe"

ort.set_default_logger_severity(3)

sess_options = ort.SessionOptions()
sess_options.enable_mem_pattern = False

sess_options.add_free_dimension_override_by_name("unet_sample_batch", batch_size * 2)
sess_options.add_free_dimension_override_by_name("unet_sample_channels", 4)
sess_options.add_free_dimension_override_by_name("unet_sample_height", image_size // 8)
sess_options.add_free_dimension_override_by_name("unet_sample_width", image_size // 8)
sess_options.add_free_dimension_override_by_name("unet_time_batch", batch_size)
sess_options.add_free_dimension_override_by_name("unet_hidden_batch", batch_size * 2)
sess_options.add_free_dimension_override_by_name("unet_hidden_sequence", 77)

pipeline = OnnxStableDiffusionPipeline.from_pretrained(
    model_dir, provider="DmlExecutionProvider", sess_options=sess_options
)

result = pipeline(
        [prompt] * batch_size,
        num_inference_steps=num_inference_steps,
        callback=None,
        height=image_size,
        width=image_size,
        guidance_scale=guidance_scale,
        generator=None
    )

output_path = "output.png"
result.images[0].save(output_path)

print(f"Generated {output_path}")

Inference Results
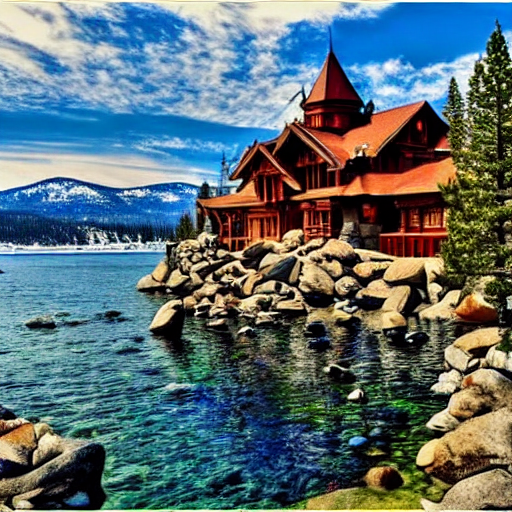
image/png

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм · diffusers

Нельзя запустить

В компонентах пайплайна нет весов PyTorch/safetensors.

Ревизия весов
45f8d76

0 моделей