/ Модель

Характеристики

Лицензия
CreativeML OpenRAIL-M
Опубликована
18 янв 2024

virtual-dress-try-on

Генерация изображенийТекст → изображение3 профессии

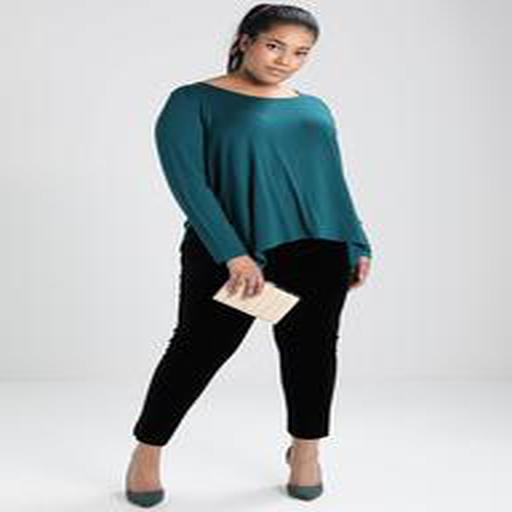
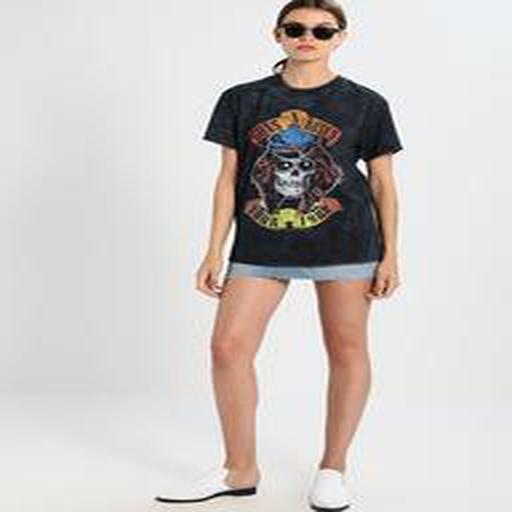
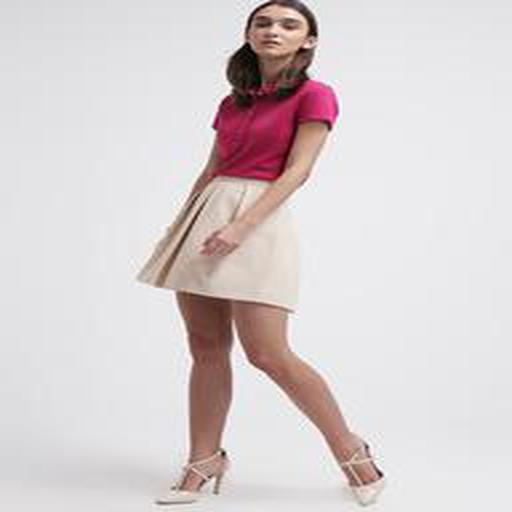
Модель на основе Stable Diffusion 1.5 для создания изображений виртуальной примерки одежды.

50скачиваний за 30 дней27лайковвеса обновлены18 янв 2024

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Тесты пользователейпока нет

Никто ещё не опубликовал тест этой модели. Соберите бенчмарк из своих задач — результат появится здесь.

  1. Добавьте модель в бенчмарк

    Вместе с другими моделями категории «Изображения» — сравнение идёт внутри одной категории.

  2. Опишите свои задачи

    Напишите запросы, при необходимости приложите файлы и эталонные ответы.

  3. Запустите и опубликуйте

    Модели сгенерируют результат по каждой задаче. Опубликованный тест появится на этой странице.

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

ares1123/virtual-dress-try-on — модель виртуальной примерки одежды, размещённая пользователем ares1123 на Hugging Face. В README описана система на основе Stable Diffusion 1.5 с U-Net и DreamBooth; для извлечения признаков используется EfficientNetB3, а OpenPose оценивает ключевые точки человека. В метаданных указан pipeline text-to-image и формат Diffusers с весами safetensors.

Модель предназначена для создания изображений, показывающих одежду на человеке, и для прототипирования сценариев виртуальной примерки в онлайн-торговле и исследованиях. README указывает требования к оборудованию и ПО: GPU A100, большой объём оперативной памяти, PyTorch и компоненты Stable Diffusion, OpenPose и EfficientNetB3. Лицензия — CreativeML Open RAIL-M.

Сценарии применения

  • визуализация одежды на человеке для онлайн-магазина
  • создание прототипа сервиса виртуальной примерки
  • генерация изображений образов для fashion-каталога

Ограничения

Для оптимальной работы README указывает GPU A100 и большой объём оперативной памяти. В карточке не описаны точные ограничения по типам одежды, позам или качеству результата.

Для каких профессий подходит3

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

This VTO trained by Hideki Okamura with stable-diffusion/DreamBooth/feature extraction (EfficientNetB3 CNN model)/OpenPose for estimating person keypoints/

stable diffusion and vector embeddings concepts used to build a virtual try-on system that provides a realistic and visually appealing virtual try-on experience for users

Hardware and software Requirements : GPU A100 , High RAM , pytorch ,stable-diffusion-v1-5 , python 3.0 , U-Net Architecture , Dreambooth , OpenPose , EfficienNetB3 pre-trained CNN model

The VTO model is hosted on the Hugging Face Model Hub. (https://huggingface.co/ares1123/virtual-dress-try-on) This model leverages a combination of advanced deep learning techniques and architectures, including stable-diffusion, DreamBooth, feature extraction using the EfficientNetB3 CNN model, and OpenPose for estimating person keypoints. These techniques are harmoniously integrated to provide a realistic and visually appealing virtual try-on experience for users.

The VTO model is built on the principles of stable diffusion and vector embeddings, which are critical in creating a high-quality virtual try-on system. The model is trained using the DreamBooth model, which is a stable-diffusion model, and the feature extraction is performed using the EfficientNetB3 CNN model. OpenPose, a real-time multi-person system to jointly detect human body, hand, facial, and foot keypoints, is used for estimating person keypoints.

The model requires specific hardware and software for optimal performance. The hardware requirements include a GPU A100 and high RAM. The software requirements include PyTorch, stable-diffusion-v1-5, Python 3.0, U-Net Architecture, Dreambooth, OpenPose, and the EfficientNetB3 pre-trained CNN model.

The VTO model is a testament to the potential of deep learning in the fashion retail industry. It showcases how advanced machine learning techniques can be used to enhance the online shopping experience, making it more interactive and personalized. This model serves as a valuable resource for researchers and practitioners in the field, providing a practical example of a high-quality virtual try-on system.

The model also provides a foundation for future research and development in the field of virtual try-on systems. It highlights the potential of deep learning techniques in addressing the challenges associated with virtual try-on systems, such as the accuracy of virtual representations and the scalability of the system. By leveraging advanced deep learning techniques, the VTO model paves the way for the development of more sophisticated and effective virtual try-on systems in the future.

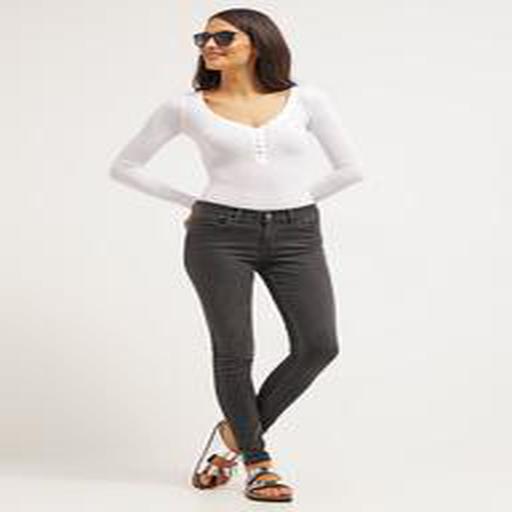
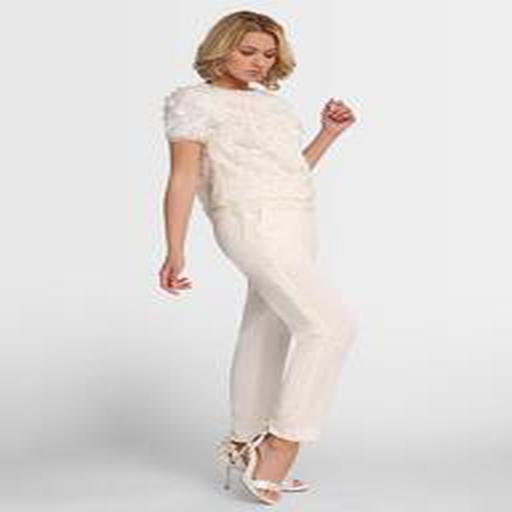
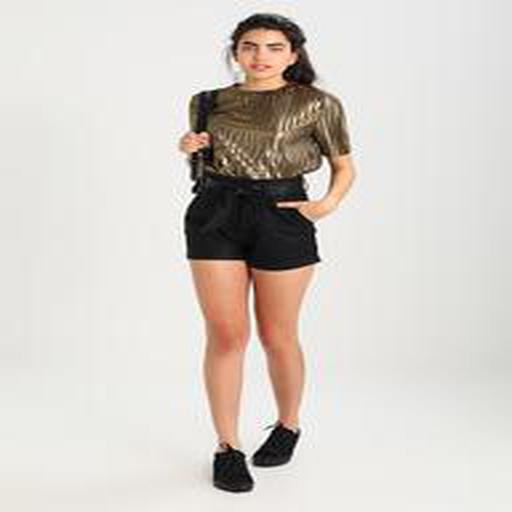
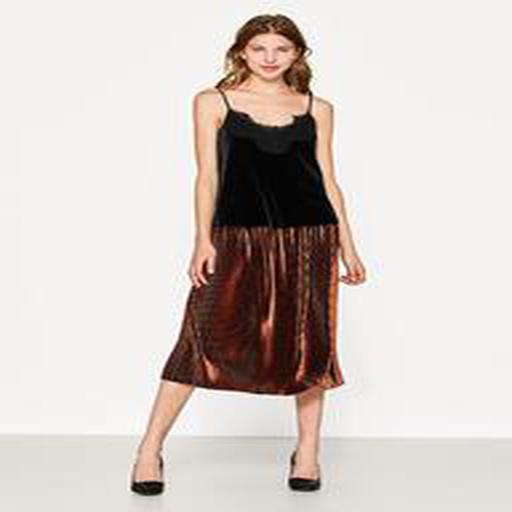
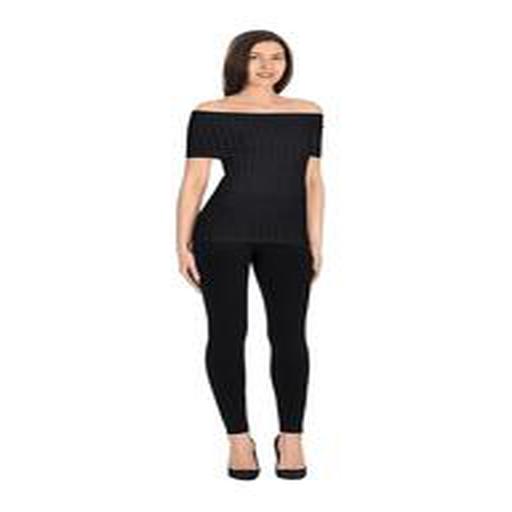
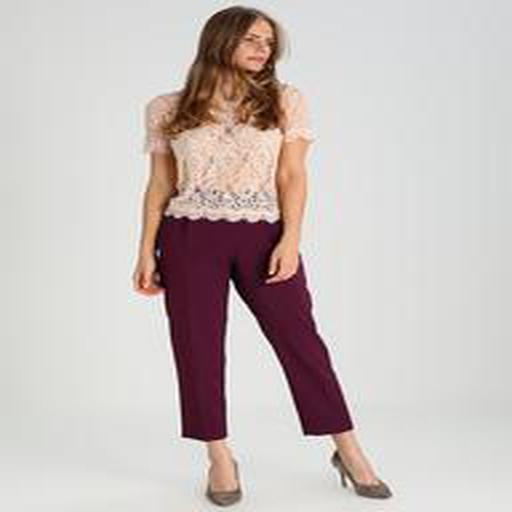
Sample pictures of this concept:
0 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 118 119 120 121 122 123 124 125 126 127 128 129 130 131 132 133 134 135 136 137 138 139 140 141 142 143 144 145 146 147 148 149 150 151 152 153 154 155 156 157 158 159 160 161 162 163 164 165 166 167 168 169 170 171 172 173 174 175 176 177 178 179 180 181 182 183 184 185 186 187 188 189 190 191 192 193 194 195 196 197 198 199 200 201 202 203 204 205 206 207 208 209 210 211 212 213 214 215 216 217 218 219 220 221 222 223 224 225 226 227 228 229 230 231 232 233 234 235 236 237 238 239 240 241 242 243 244 245 246 247 248 249 250 251 252 253 254 255 256 257 258 259 260 261 262 263 264 265 266 267 268 269 270 271

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм

Можно запустить

Подбираем GPU…

Ревизия весов
2acf067

0 моделей