/ Модель

Характеристики

Контекст
2 048 токенов
Параметры
12,9 млрд
Размер весов
52,1 ГБ
Лицензия
OpenRAIL
Архитектура
llama · dense
Опубликована
28 авг 2023

PMC_LLaMA_13B

Генерация текстаТекст → текст3 профессии

Медицинская языковая модель на базе LLaMA-13B для генерации текста и ответов на вопросы в медицинской области.

156скачиваний за 30 дней32лайкавеса обновлены28 авг 2023

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Тесты пользователейпока нет

Никто ещё не опубликовал тест этой модели. Соберите бенчмарк из своих задач — результат появится здесь.

  1. Добавьте модель в бенчмарк

    Вместе с другими моделями категории «Текст» — сравнение идёт внутри одной категории.

  2. Опишите свои задачи

    Напишите запросы, при необходимости приложите файлы и эталонные ответы.

  3. Запустите и опубликуйте

    Модели ответят на каждую задачу, судья оценит ответы. Опубликованный результат появится на этой странице.

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

PMC_LLaMA_13B — языковая модель семейства LLaMA, разработанная авторами проекта PMCLLaMA для задач в медицинской области. Модель содержит 12,9 млрд параметров, использует архитектуру LlamaForCausalLM и принимает текст. Максимальная длина контекста — 2048 токенов; веса представлены в формате PyTorch.

Модель предназначена для генерации текста и ответов на медицинские вопросы. По карточке, она показывает сопоставимые с ChatGPT результаты на медицинских бенчмарках вопросов и ответов. В описании проекта указано, что MedLLaMA_13B получила медицинские знания в ходе дополнительного предобучения на медицинском корпусе, а PMC_LLaMA_13B была настроена на наборе инструкций; базовой моделью названа LLaMA-13B.

Лицензия модели — OpenRAIL. Карточка не приводит подробностей о медицинских ограничениях или пригодности ответов для клинических решений.

Сценарии применения

  • ответы на медицинские вопросы
  • поиск ответов на вопросы по медицинским знаниям
  • генерация медицинских текстовых ответов

Ограничения

Контекст ограничен 2048 токенами. Карточка не описывает клиническую валидацию или безопасность ответов для принятия медицинских решений.

Для каких профессий подходит3

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

PMC_LLaMA

To obtain the foundation model in medical field, we propose MedLLaMA_13B and PMC_LLaMA_13B.

MedLLaMA_13B is initialized from LLaMA-13B and further pretrained with medical corpus. Despite the expert knowledge gained, it lacks instruction-following ability. Hereby we construct a instruction-tuning dataset and evaluate the tuned model.

As shown in the table, PMC_LLaMA_13B achieves comparable results to ChatGPT on medical QA benchmarks.
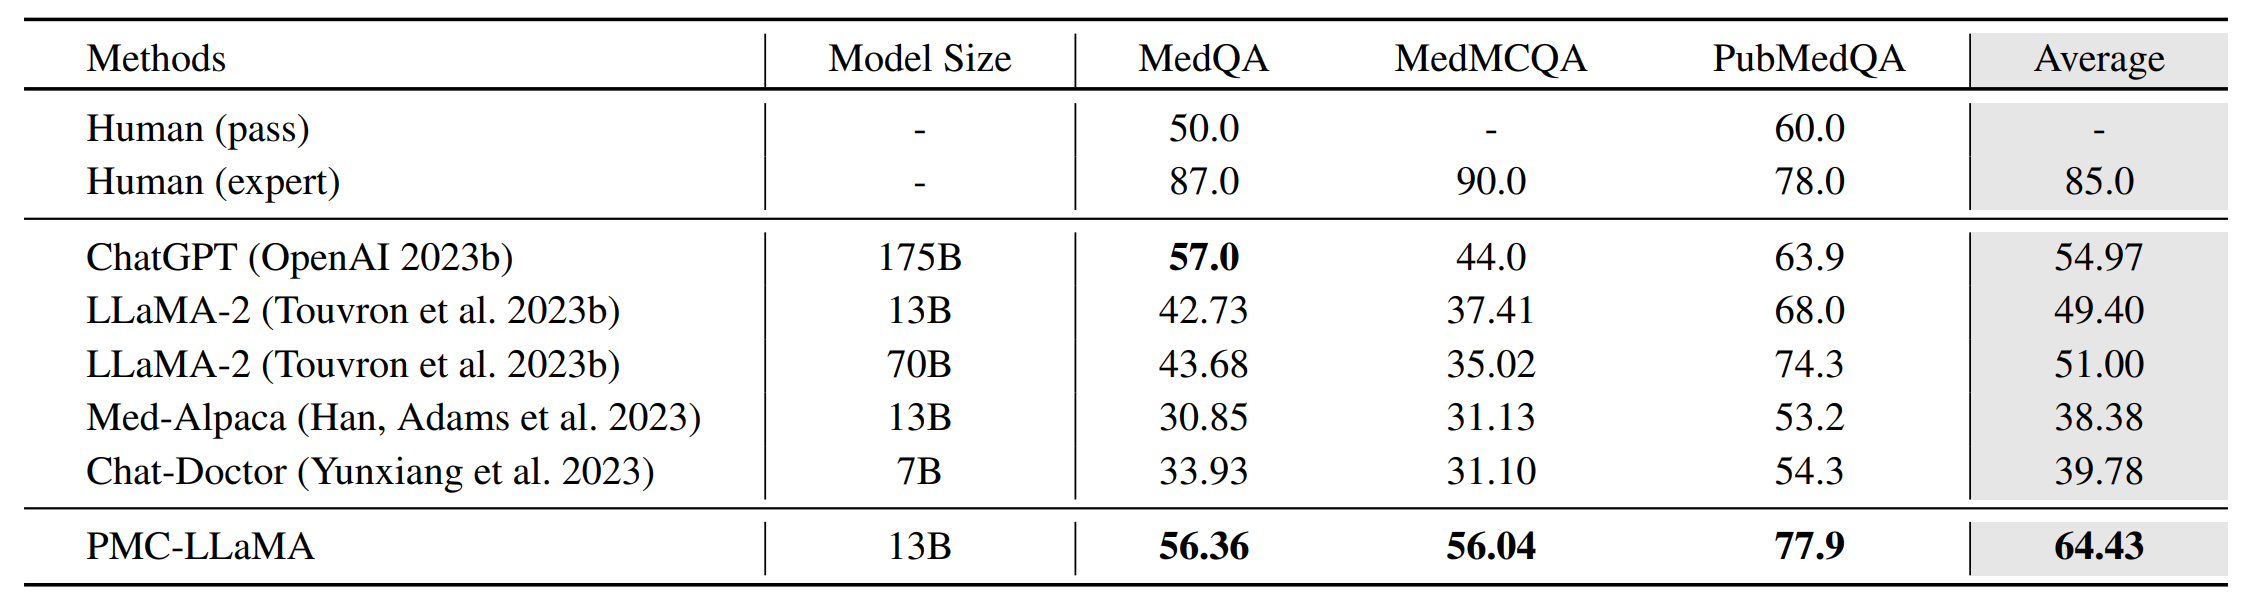
medical_qa

Usage

import transformers
import torch

tokenizer = transformers.LlamaTokenizer.from_pretrained('axiong/PMC_LLaMA_13B')
model = transformers.LlamaForCausalLM.from_pretrained('axiong/PMC_LLaMA_13B')

sentence = 'Hello, doctor' 
batch = tokenizer(
    sentence,
    return_tensors="pt", 
    add_special_tokens=False
)
with torch.no_grad():
    generated = model.generate(
        inputs = batch["input_ids"],
        max_length=200,
        do_sample=True,
        top_k=50
    )
    print('model predict: ',tokenizer.decode(generated[0]))

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм

Можно запустить

Подбираем GPU…

Класс архитектуры
LlamaForCausalLM
Ревизия весов
265afcd

0 моделей