/ Модель

Характеристики

Лицензия
Apache 2.0
Базовая модель
Wan2.1-VACE-1.3B
Опубликована
14 апр 2026

wan-1.3b-gguf

Генерация видеоТекст → видео3 профессии

bykhan/wan-1.3b-gguf — квантованная в формате GGUF версия моделей Wan2.1-T2V-1.3B и Wan2.1-VACE-1.3B, разработанных Wan-AI и адаптированных для запуска через gguf-node, gguf-connector и ComfyUI.

2 598скачиваний за 30 дней2лайкавеса обновлены14 апр 2026

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

Модель предназначена прежде всего для генерации видео по текстовому описанию, а вариант VACE также рекомендован для сценариев image-to-video и video-to-video без отдельного vision CLIP.

Доступны варианты квантования Q4_0 и Q8_0 для моделей T2V и VACE. В состав рабочего набора входят модель Wan, текстовый энкодер UMT5 и VAE; для запуска требуется совместимое окружение ComfyUI и соответствующие узлы. В карточке указана поддержка английского языка. Архитектурные детали, точная длина контекста, разрешение и длительность генерируемого видео не приведены.

Ключевое преимущество — возможность запуска уменьшенных GGUF-версий и совместимость с несколькими инструментами, что может снизить требования к ресурсам по сравнению с исходными моделями. Ограничения включают зависимость от специализированных узлов и компонентов, необходимость обновления узла для поддержки GGUF-энкодера UMT5, а также возможную нехватку памяти при первоначальной сборке токенизатора. Модель распространяется по лицензии Apache-2.0.

Для каких профессий подходит3

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

gguf quantized version of wan 1.3b models

  • run it straight with gguf-connector
  • opt a gguf file in the current directory to interact with by:
ggc w2

GGUF file(s) available. Select which one to use:

  1. wan2.1-t2v-1.3b-q4_0.gguf
  2. wan2.1-t2v-1.3b-q8_0.gguf
  3. wan2.1-vace-1.3b-q4_0.gguf
  4. wan2.1-vace-1.3b-q8_0.gguf

Enter your choice (1 to 4): _

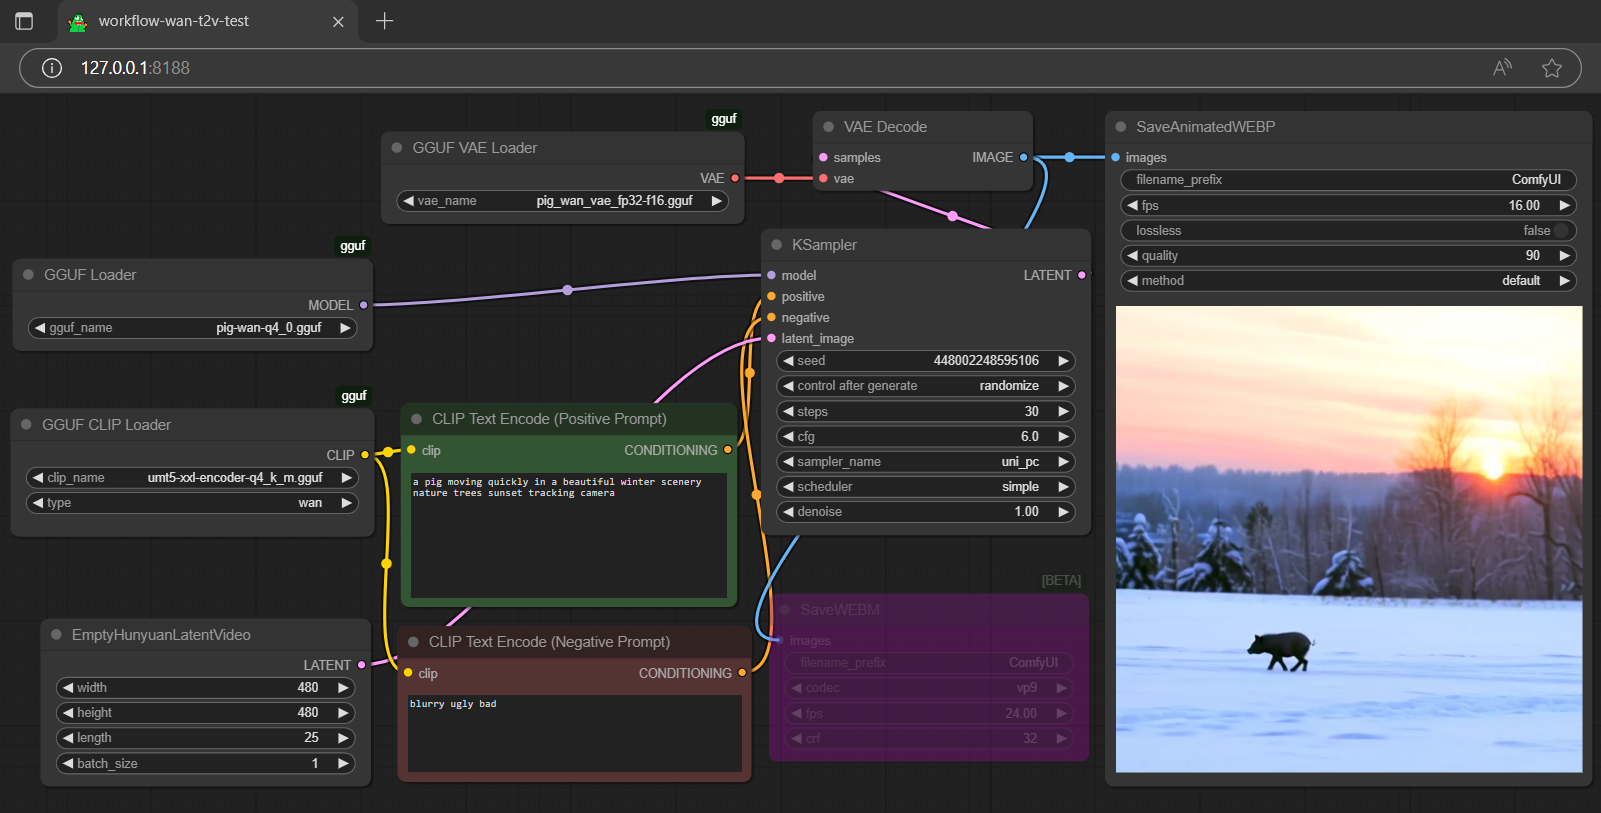
run it with gguf-node via comfyui

  • drag wan to > ./ComfyUI/models/diffusion_models
  • drag umt5 to > ./ComfyUI/models/text_encoders
  • drag pig to > ./ComfyUI/models/vae

review

  • wan architecture; should work on both comfyui-gguf and gguf nodes
  • full set gguf works right away (model + encoder + vae); gguf node is recommended for full gguf
  • vace model is recommended, since it doesn't need vision clip to work (for i2v and v2v) and run faster than fun model a lot, according to the initial test results
  • upgrade your node for umt5 gguf encoder support
  • note: for umt5 gguf, you might encounter oom after rebuilding your tokenizer in the first prompt (once built the tokenizer alive during the session; before you kill it); don't panic, prompt again it should work screenshot
reference

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм

Нельзя запустить

GGUF-версии diffusion-моделей не запускаются: нужен репозиторий diffusers.

Ревизия весов
868f8ed

0 моделей