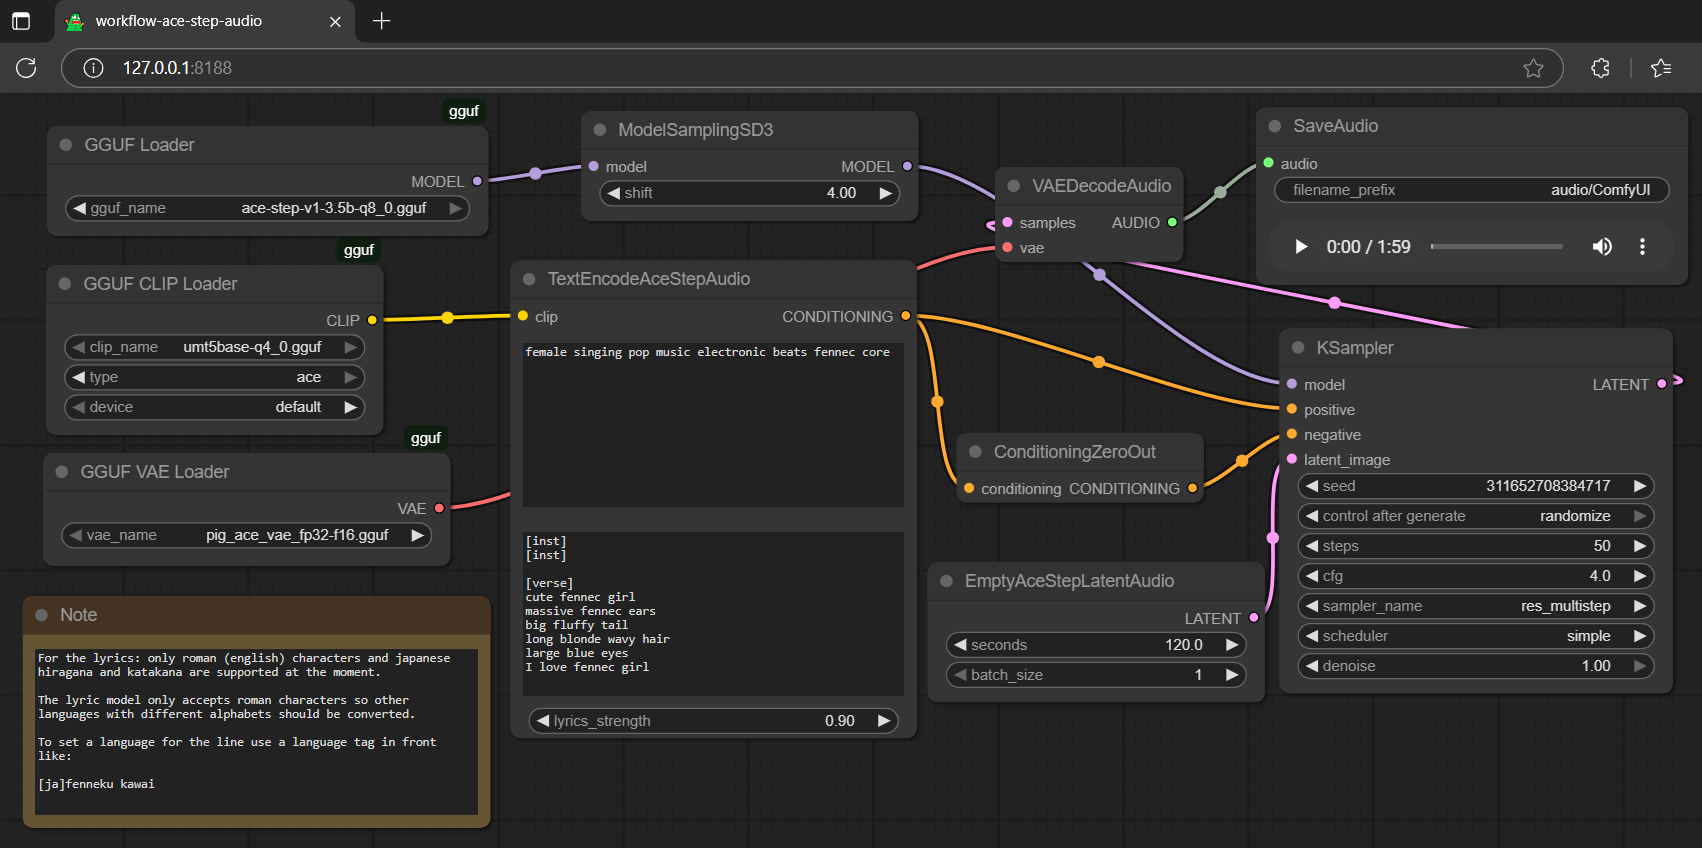
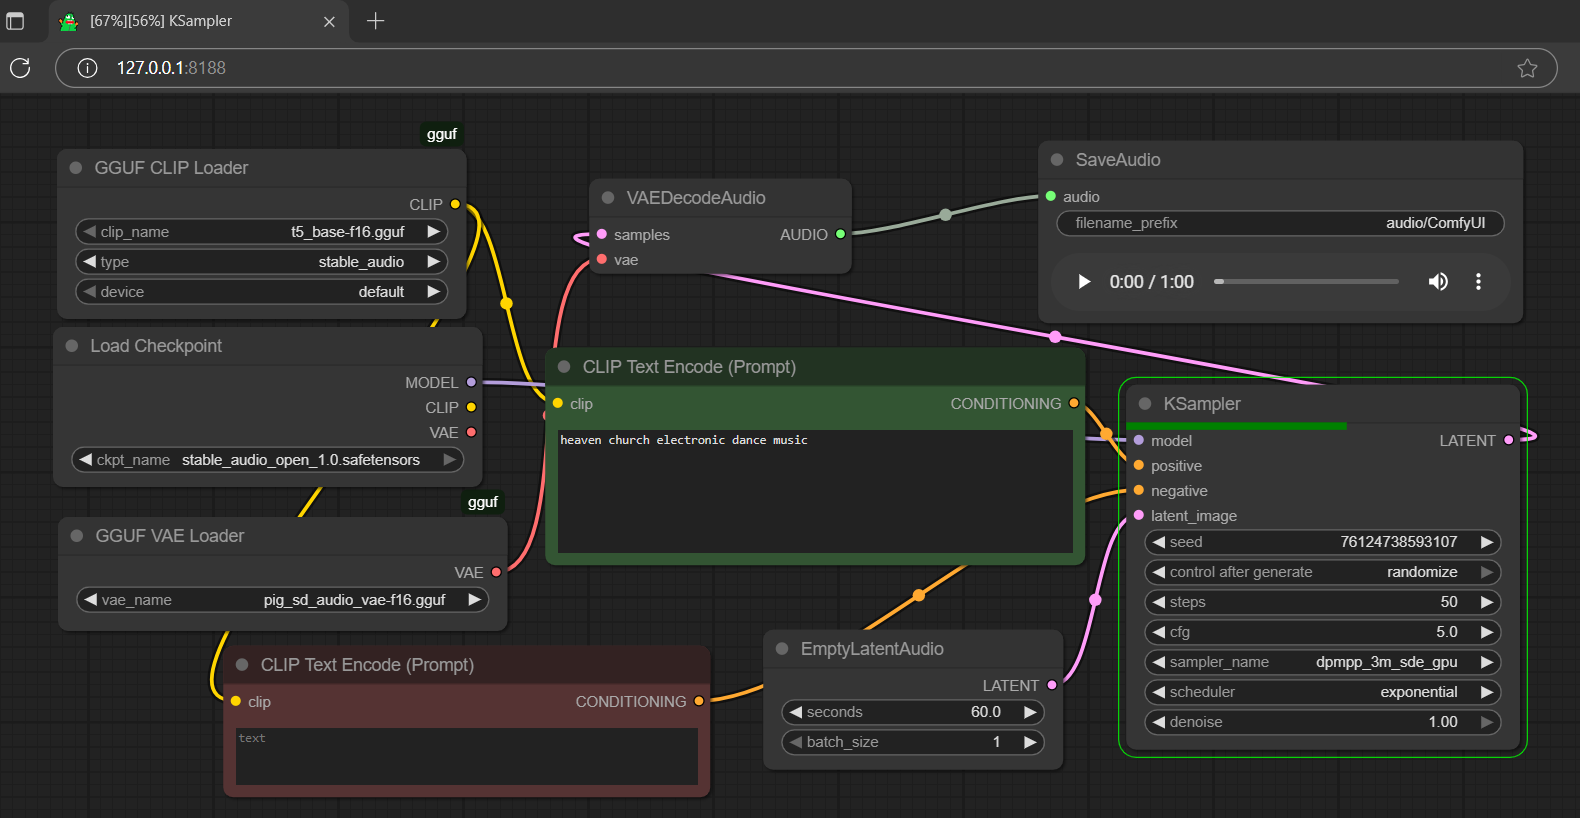
Модель интегрируется с ComfyUI и рассчитана на сценарии text-to-audio, включая создание музыки, вокала, инструментальных партий и звуковых сцен по промптам. В репозитории представлен полный комплект GGUF-файлов: основная модель, текстовый энкодер и VAE.
Известно, что модель основана на ACE-Step v1-3.5B и использует энкодер umt5-base; конкретная архитектура, поддерживаемые языки, размер контекста и точные параметры квантования в README не указаны. Для работы требуются компоненты ace-step, umt5-base и pig, размещённые в соответствующих каталогах ComfyUI. GGUF-формат обычно обеспечивает более быструю загрузку по сравнению с safetensors, однако часть ключевых тензоров сохранена в формате F32, поэтому размер файлов уменьшен незначительно.
Модель удобна для запуска в ComfyUI без отдельного safetensors-чекпойнта и поставляется с примерами аудио. Ограничения включают зависимость от ComfyUI, gguf-node и совместимых узлов, а также необходимость отдельно подготовить компоненты и использовать актуальную версию ComfyUI для поддержки umt5-base. Лицензия — Apache-2.0.