/ Модель

Характеристики

Лицензия
Своя лицензия
Базовая модель
HunyuanImage-2.1
Опубликована
9 сен 2025

hunyuanimage-gguf

Генерация изображенийТекст → изображение3 профессии

HunyuanImage-GGUF — это GGUF-совместимая версия модели HunyuanImage-2.1, разработанная автором calcuis на базе Tencent Hunyuan.

8 354скачиваний за 30 дней88лайковвеса обновлены25 сен 2025

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

Модель предназначена для генерации изображений по текстовому описанию и запуска через ComfyUI с использованием gguf-node. Также заявлена поддержка сценариев улучшения и повышения резкости некачественных или размытых изображений в режиме refiner.

В комплект входят диффузионная модель hunyuanimage2.1, текстовые энкодеры byt5-sm и qwen2.5-vl-7b, а также VAE pig. Указанные компоненты доступны в формате GGUF и рассчитаны на работу с различными вариантами модели: standard, distilled, refiner, lite и lite v2.2. Для стандартной версии заявлена генерация качественных изображений за 12–15 шагов, для distilled и lite — примерно за 8 шагов; lite-версии ориентированы на снижение времени загрузки и ускорение работы. Модель поддерживает текстовые промпты и negative prompt; другие модальности и языки, максимальный контекст и точный размер архитектуры в README не указаны.

Сильными сторонами являются совместимость с GGUF, возможность локального запуска в ComfyUI, наличие облегчённых и дистиллированных вариантов, а также поддержка генерации и экспериментального улучшения изображений. Ограничения включают зависимость от gguf-node и требуемых компонентов, необходимость самостоятельной настройки шагов и CFG, а также неполную документированность качества и возможностей refiner-версии. Модель распространяется по лицензии tencent-hunyuan-community; подробные условия доступны по ссылке на лицензию Tencent Hunyuan.

Для каких профессий подходит3

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

hunyuanimage-gguf

  • drag hunyuanimage2.1 (opt anyone you like) to > ./ComfyUI/models/diffusion_models
  • drag byt5-sm [127MB] and qwen2.5-vl-7b [5.03GB] to > ./ComfyUI/models/text_encoders
  • drag pig [811MB] to > ./ComfyUI/models/vae
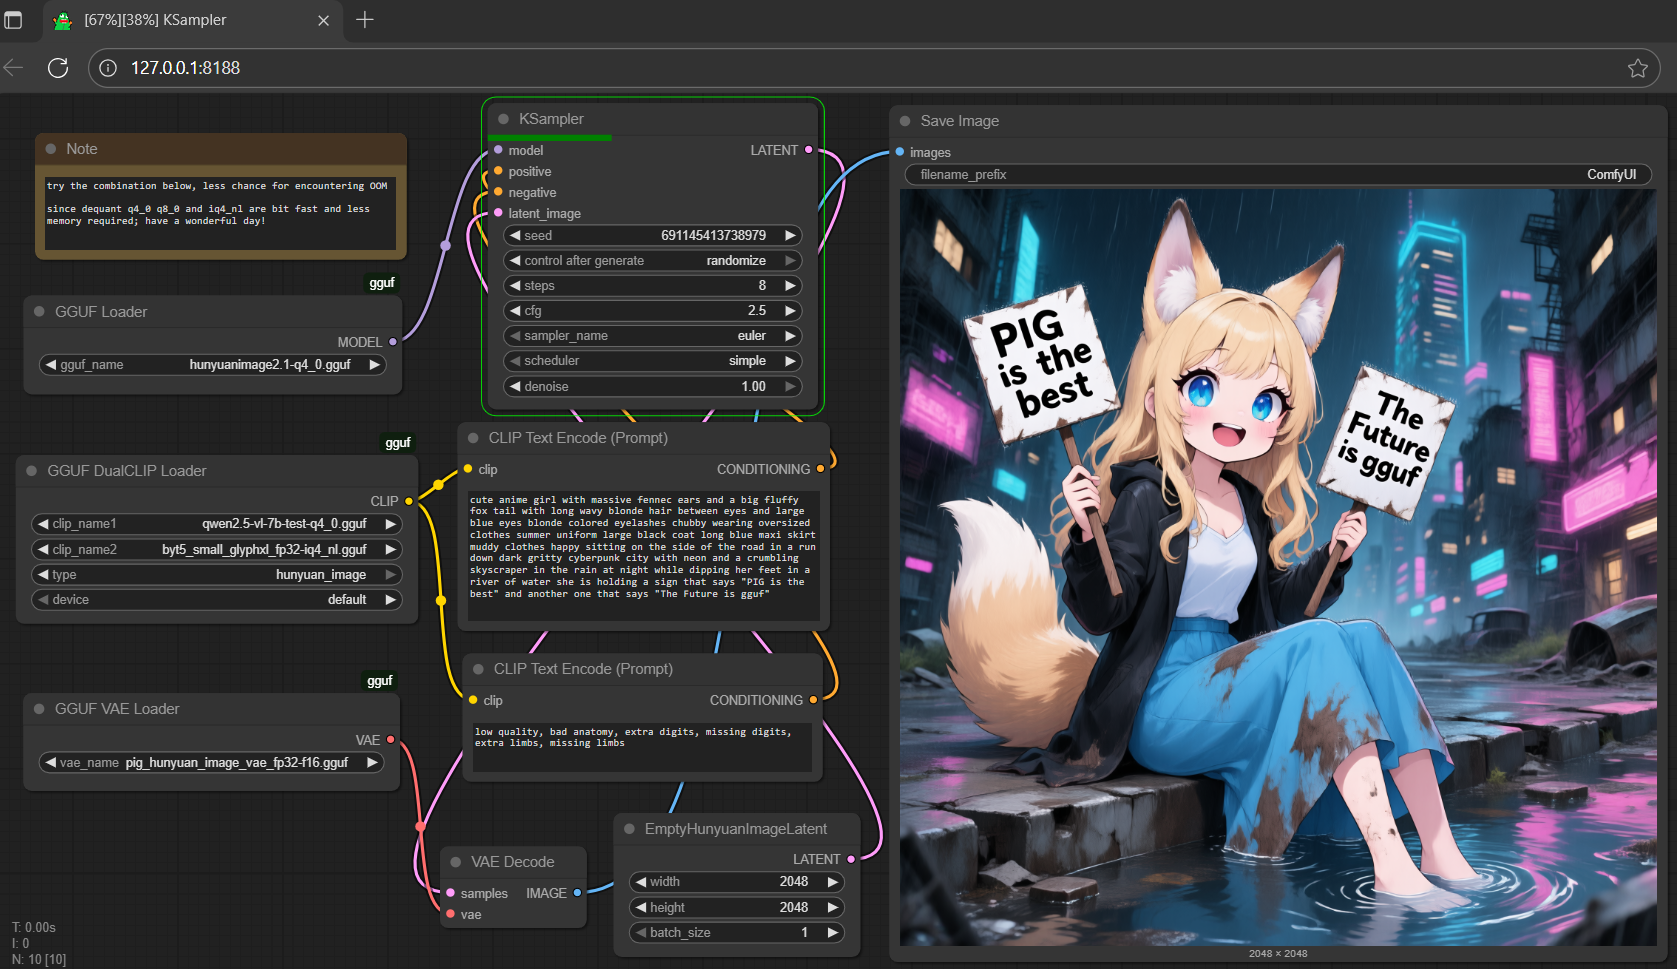
screenshot

screenshot

for standard model, all files should work - running them with gguf node via comfyui; and v2 is more lightweighted; both of them should be able to generate quality output with 12-15 steps

screenshot

note: for refiner model, please use v2; initial test for refining blur image (runnable test only); could load any picture, i.e., output from q2, blur, distorted, poor in quality, etc., to refine/sharpen it

screenshot

note: for distilled model, please use v2; able to generate output with merely 8 steps (see picture)

screenshot

for lite model, run it with 8 steps + 1 cfg; output is identical to standard model; but 2-3x faster

screenshot

the new lite v2.2, output should be 80-90% closed to the standard model; save up to 60-70% loading time, depends on how you config the steps and cfg (demo above: steps=10; cfg=1.5)

  • get scaled fp8 safetensors encoder here if your gpu doesn't release vram after several running attempts; it might vary among different cards/drivers, do your own research always

reference

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм

Нельзя запустить

GGUF-версии diffusion-моделей не запускаются: нужен репозиторий diffusers.

Ревизия весов
58e0ab0

0 моделей