/ Модель

Характеристики

Лицензия
MIT
Базовая модель
HunyuanVideo
Опубликована
26 дек 2024

hyvid

Генерация видеоТекст → видео3 профессии

calcuis/hyvid — это набор GGUF-квантизированной и FP8-масштабированной версии HunyuanVideo с LoRA-адаптером для генерации видео по текстовому описанию.

2 202скачиваний за 30 дней25лайковвеса обновлены1 фев 2025

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

Проект разработан calcuis на базе HunyuanVideo от Tencent и использует LoRA-адаптер AnimeShots от trojblue. Модель ориентирована прежде всего на создание аниме-сцен: персонажей, окружений и коротких сюжетных действий. В качестве рабочего окружения предусмотрен ComfyUI с поддержкой GGUF-узлов и соответствующих workflow.

В состав входят квантизированная diffusion-модель HunyuanVideo T2V 720p, текстовый энкодер LLaVA-Llama 3 в формате GGUF, CLIP-L FP8, VAE HunyuanVideo FP8 и LoRA-адаптер размером около 323 МБ. Заявлены варианты с разрешением 720p, а метаданные указывают английский язык. Адаптер делает результаты более стабильными, а квантизированные и масштабированные компоненты ускоряют загрузку и снижают требования к хранению по сравнению с полноразмерными версиями, однако для работы всё равно требуется несколько гигабайт дискового пространства и совместимая конфигурация ComfyUI. Лицензия указана как MIT с названием tencent-hunyuan-community.
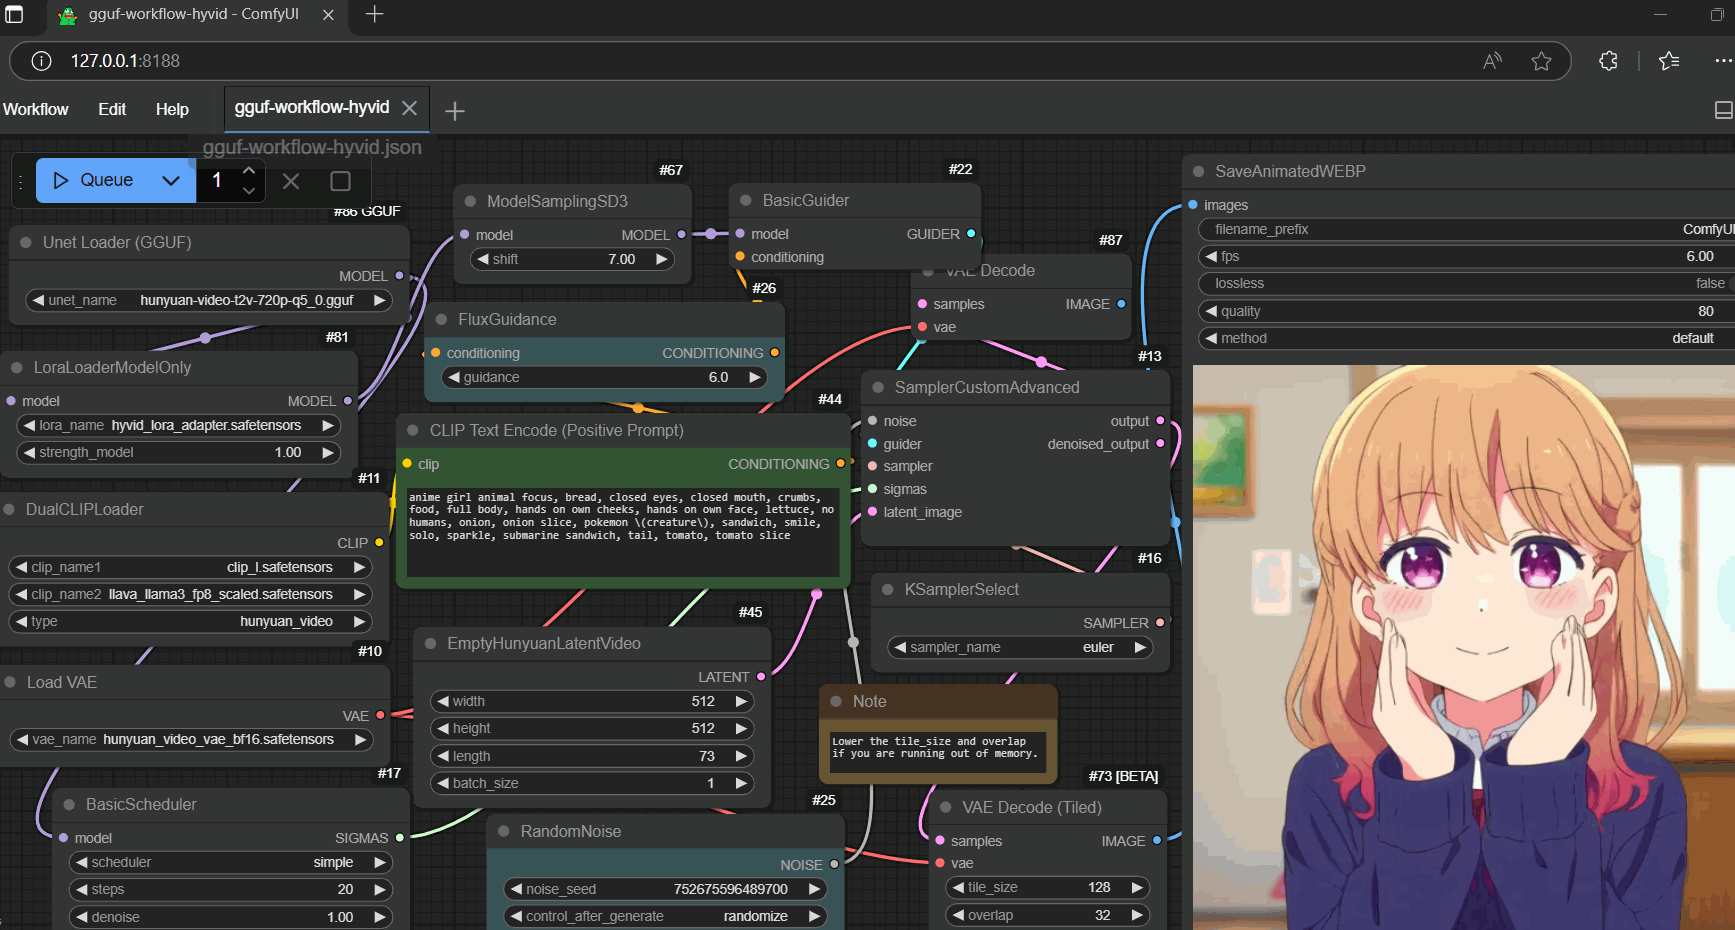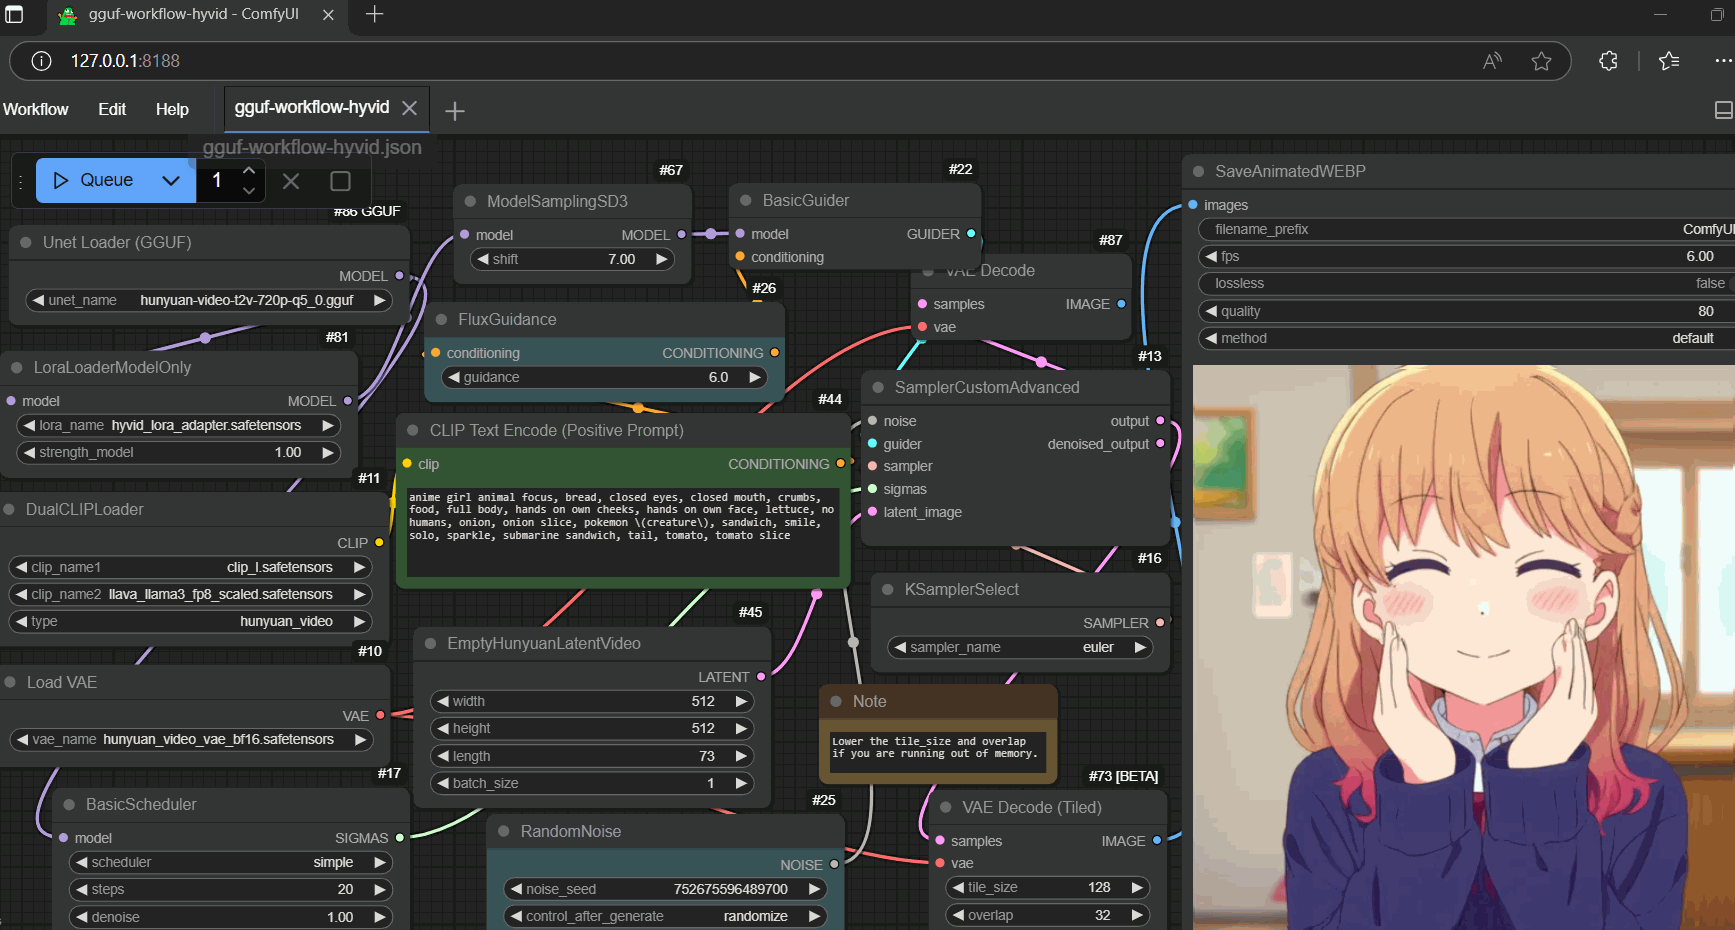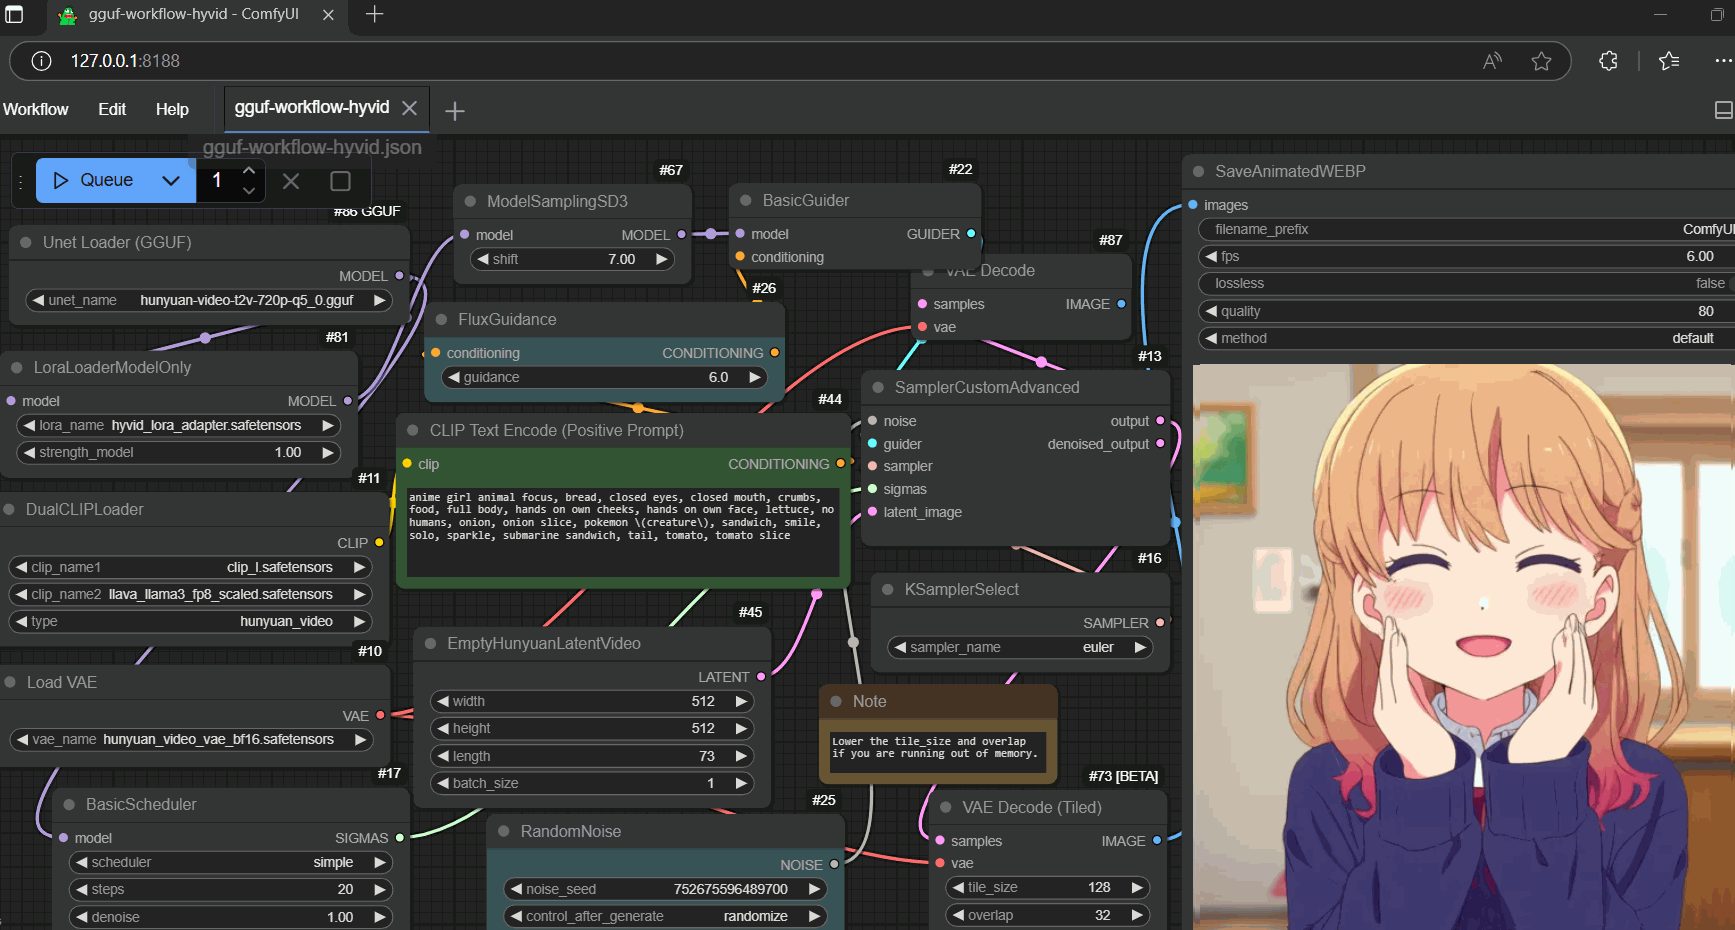
Для каких профессий подходит3

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

GGUF quantized and fp8 scaled version of hyvid with lora anime adapter

screenshot

setup (once)

  • drag hyvid_lora_adapter.safetensors [323MB] to > ./ComfyUI/models/loras
  • drag hunyuan-video-t2v-720p-q4_0.gguf [7.74GB] to > ./ComfyUI/models/diffusion_models
  • drag llava_llama3-q4_0.gguf [4.68GB] to > ./ComfyUI/models/text_encoders
  • drag clip_l_fp8_e4m3fn.safetensors [123MB] to > ./ComfyUI/models/text_encoders
  • drag hunyuan_video_vae_fp8_e4m3fn.safetensors [247MB] to > ./ComfyUI/models/vae

run it straight (no installation needed way)

  • run the .bat file in the main directory (assuming you are using the gguf-node pack below)
  • drag the demo clip or the workflow json file (below) to > your browser

workflows

  • example workflow for gguf (upgrade your node for llava gguf support; more quantized llava-llama3 version here)
  • example workflow for safetensors (fp8 scaled version [13.2GB] is recommended)

review

  • more stable output if adapter applied
  • working good even with fp8_e4m3fn scaled clip and vae
  • significant changes in loading speed while using the new quantized/scaled file(s) with revised workflow (see above)

references

appendices

  • get more test prompt from the training dataset
  • still no ideas? get fresh prompt from our simulator

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм

Нельзя запустить

Базовая модель tencent/HunyuanVideo выложена не в формате diffusers, адаптер не к чему подключить.

Ревизия весов
5992445

0 моделей