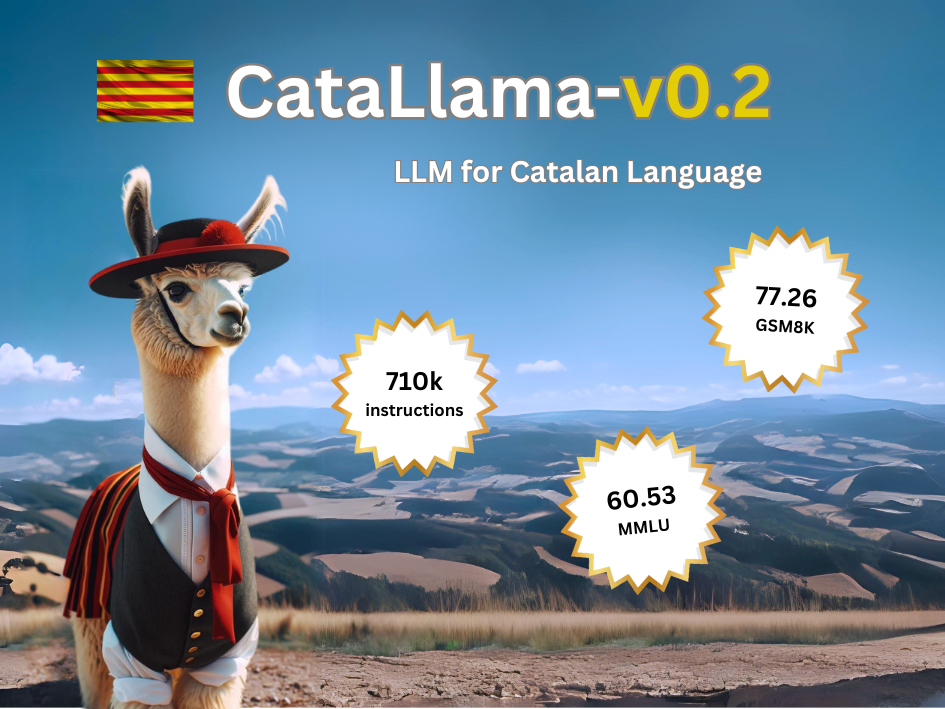
/ Модель

Характеристики

Контекст
8 192 токена
Параметры
7,5 млрд
Размер весов
16,1 ГБ
Лицензия
Llama 3
Архитектура
llama · dense
Базовая модель
CataLlama-v0.2-Instruct-SFT
Опубликована
13 июл 2024

CataLlama-v0.2-Instruct-DPO

Генерация текстаТекст → текст11 профессий

Дообученная методом DPO модель Llama 3 для чата и языковых задач преимущественно на каталанском языке.

16скачиваний за 30 дней0лайковвеса обновлены15 июл 2024

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Тесты пользователейпока нет

Никто ещё не опубликовал тест этой модели. Соберите бенчмарк из своих задач — результат появится здесь.

  1. Добавьте модель в бенчмарк

    Вместе с другими моделями категории «Текст» — сравнение идёт внутри одной категории.

  2. Опишите свои задачи

    Напишите запросы, при необходимости приложите файлы и эталонные ответы.

  3. Запустите и опубликуйте

    Модели ответят на каждую задачу, судья оценит ответы. Опубликованный результат появится на этой странице.

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

CataLlama-v0.2-Instruct-DPO — языковая модель Laurentiu Petrea на архитектуре Llama 3, дообученная методом DPO на наборе catallama/Catalan-DPO-V2 поверх CataLlama-v0.2-Instruct-SFT. Это авторегрессионный трансформер с 7,5 млрд параметров и контекстом до 8192 токенов, предназначенный для диалогов и выполнения инструкций преимущественно на каталанском языке.

Модель подходит для извлечения информации из документов, в том числе в сценариях RAG, распознавания именованных сущностей, перевода между каталанским и английским, краткого и развернутого суммирования, анализа тональности и чата. Карточка сообщает об улучшении владения каталанским языком; также приведены результаты бенчмарков MMLU и GSM8K. Модель использует шаблон запросов Llama 3 Instruct.

Модель распространяется по лицензии Llama 3. Авторы указывают, что она создана для демонстрации методов адаптации LLM к новым языкам и сохранения языков с малым числом ресурсов. В карточке также приведено ограничение лицензии Llama 3 на использование модели в языках, отличных от английского, и отдельно отмечено, что разработчики могут дообучать модели для других языков при соблюдении условий лицензии и Acceptable Use Policy.

Сценарии применения

  • извлечение фактов из каталанских документов для RAG
  • распознавание именованных сущностей в каталанском тексте
  • перевод с английского на каталанский и обратно
  • краткое и развернутое суммирование каталанских текстов
  • анализ тональности каталанских отзывов
  • диалоговый помощник на каталанском языке

Ограничения

Карточка указывает на ограничение условий использования Llama 3 для языков, отличных от английского, и требует соблюдать лицензию и Acceptable Use Policy. Модель преимущественно адаптирована к каталанскому; качество для других языков и сценариев отдельно не подтверждено.

Для каких профессий подходит11

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Также подходит для

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

CataLlama-v0.2-Instruct-DPO

CataLlama-v0.2-Instruct-DPO is a DPO fine-tune of catallama/CataLlama-v0.2-Instruct-SFT on the catallama/Catalan-DPO-V2 dataset.

CataLlama-v0.2 was trained on roughly 620 million new tokens which is almost 40% more than CataLlama-v0.1.

The DPO-V2 dataset has been completely rebuilt and it's almost twice the size of the DPO-V1 dataeset.

The model shows improved proficiency with the Catalan language.

This is an instruction fine-tuned model, optimised with DPO, proficient on the following tasks in Catalan

  • Information extraction (suitable for RAG)
  • Named Entity Recognition (NER)
  • Translation from English to Catalan and Catalan to English
  • Summarization - both short form and long form
  • Sentiment analysis
  • Chat

Model developers Laurentiu Petrea based on Llama-3 from Meta.

Model Architecture CataLlama is an auto-regressive language model that uses an optimized transformer architecture. The tuned versions use supervised fine-tuning (SFT) and direct preference optimisation (DPO) to align with human preferences for helpfulness and safety.

License The model uses the llama-3 license available at: https://llama.meta.com/llama3/license

Benchmarks

ModelCataLlama-v0.1-Instruct-DPOCataLlama-v0.2-Instruct-DPO
MMLU 5 shot47.3458.89
GSM8K CoT 8 shot43.2960.05

Use with transformers

See the snippet below for usage with Transformers:

The model follows the same prompt template as Llama-3 Instruct

import transformers
import torch

model_id = "catallama/CataLlama-v0.2-Instruct-DPO"

pipeline = transformers.pipeline(
    "text-generation",
    model=model_id,
    model_kwargs={"torch_dtype": torch.bfloat16},
    device_map="auto",
)

messages = [
    {"role": "user", "content": "Ei com estàs avui?"},
]

prompt = pipeline.tokenizer.apply_chat_template(
    messages, 
    tokenize=False, 
    add_generation_prompt=True
)

outputs = pipeline(
    prompt,
    max_new_tokens=1024,
    do_sample=True,
    temperature=0.6,
    top_p=0.9,
)

print(outputs[0]["generated_text"][len(prompt):])

Training procedure

The model was trained with the same prompt template of Llama-3 Instruct.

The model was trained for two epochs on 8x A100 80GB GPUs using DeepSpeed ZeRO State-3 without CPU offloading.

Training hyperparameters

The following hyperparameters were used during training:

  • learning_rate: 5e-07
  • train_batch_size: 1
  • eval_batch_size: 1
  • seed: 42
  • distributed_type: multi-GPU
  • num_devices: 8
  • total_train_batch_size: 8
  • total_eval_batch_size: 8
  • optimizer: Adam with betas=(0.9,0.999) and epsilon=1e-08
  • lr_scheduler_type: cosine
  • lr_scheduler_warmup_steps: 200
  • num_epochs: 2

Intended Use

Note: This model is not intended to beat benchmarks, but to demonstrate techniques for augmenting LLMs on new languages and preserve rare languages as part of our world heritage.

Intended Use Cases Llama 3 is intended for commercial and research use in English. Instruction tuned models are intended for assistant-like chat, whereas pretrained models can be adapted for a variety of natural language generation tasks.

Out-of-scope Use in any manner that violates applicable laws or regulations (including trade compliance laws). Use in any other way that is prohibited by the Acceptable Use Policy and Llama 3 Community License. Use in languages other than English**.

**Note: Developers may fine-tune Llama 3 models for languages beyond English provided they comply with the Llama 3 Community License and the Acceptable Use Policy.

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм

Можно запустить

Подбираем GPU…

Класс архитектуры
LlamaForCausalLM
Ревизия весов
7e7bcd5

0 моделей