/ Модель

Характеристики

Контекст
1 024 токена
Архитектура
gpt2 · dense
Опубликована
24 дек 2023

gpt2-turkish-256-token

Генерация текстаТекст → текст3 профессии

Турецкая языковая модель на архитектуре GPT-2 для продолжения текста и генерации фраз по начальному запросу.

51скачиваний за 30 дней3лайкавеса обновлены29 мар 2024

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Тесты пользователейпока нет

Никто ещё не опубликовал тест этой модели. Соберите бенчмарк из своих задач — результат появится здесь.

  1. Добавьте модель в бенчмарк

    Вместе с другими моделями категории «Текст» — сравнение идёт внутри одной категории.

  2. Опишите свои задачи

    Напишите запросы, при необходимости приложите файлы и эталонные ответы.

  3. Запустите и опубликуйте

    Модели ответят на каждую задачу, судья оценит ответы. Опубликованный результат появится на этой странице.

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

cenkersisman разработал GPT-2 для генерации текста на турецком языке. Модель принимает начальный текст и предсказывает продолжение, поэтому подходит для создания черновиков и продолжения турецких фраз. Она основана на архитектуре GPT-2 и обучалась на турецком корпусе Википедии объёмом около 900 миллионов символов; в обучающих предложениях было не более 256 токенов. Контекст модели составляет 1024 токена.

Токенизатор учитывает морфологию турецкого языка. Модель чувствительна к регистру; в README рекомендуется подавать запросы строчными буквами. Обучающие данные могли содержать ненормативную лексику и откровенные материалы, поэтому генерация может быть оскорбительной или нежелательной. Перед публикацией результат следует проверять и при необходимости фильтровать. Условия лицензии в предоставленных данных не указаны.

Сценарии применения

  • продолжение турецкого текста по начальной фразе
  • генерация черновиков на турецком языке
  • создание вариантов турецких предложений

Ограничения

Модель чувствительна к регистру, и в README рекомендуется подавать запросы строчными буквами. Она может генерировать оскорбительный или откровенный текст, а качество и уместность результатов требуют проверки.

Для каких профессий подходит3

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

Model

GPT-2 Türkçe Modeli

Model Açıklaması

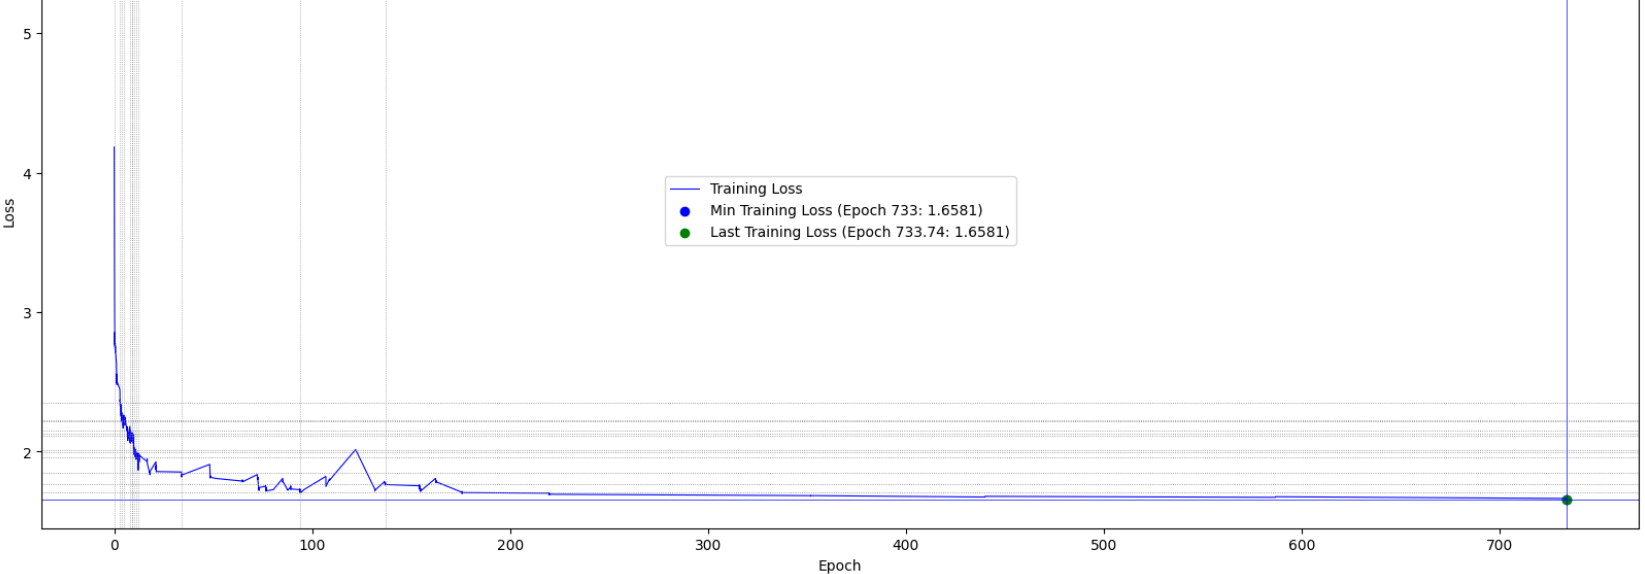
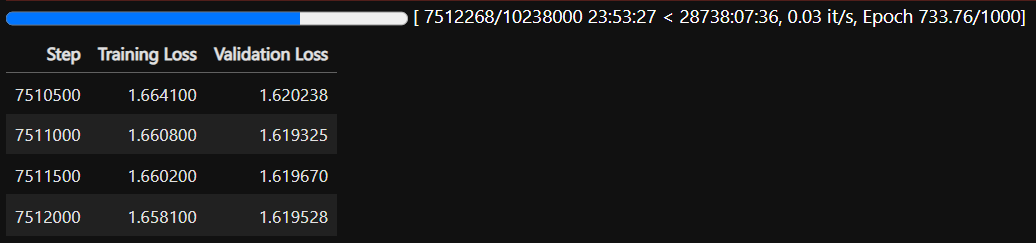
GPT-2 Türkçe Modeli, Türkçe diline özelleştirilmiş olan GPT-2 mimarisi temel alınarak oluşturulmuş bir dil modelidir. Belirli bir başlangıç metni temel alarak insana benzer metinler üretme yeteneğine sahiptir ve geniş bir Türkçe metin veri kümesi üzerinde eğitilmiştir. Modelin eğitimi için 900 milyon karakterli Vikipedi seti kullanılmıştır. Eğitim setindeki cümleler maksimum 256 tokendan (token = kelime kökü ve ekleri) oluşmuştur bu yüzden oluşturacağı cümlelerin boyu sınırlıdır.. Türkçe heceleme yapısına uygun tokenizer kullanılmış ve model 7.5 milyon adımda yaklaşık 733 epoch eğitilmiştir. Eğitim için 4GB hafızası olan Nvidia Geforce RTX 3050 GPU kullanılmaktadır. 16GB Paylaşılan GPU'dan da yararlanılmakta ve eğitimin devamında toplamda 20GB hafıza kullanılmaktadır.

Model Nasıl Kullanılabilir

ÖNEMLİ: model harf büyüklüğüne duyarlı olduğu için, prompt tamamen küçük harflerle yazılmalıdır. Ekranın sağındaki Inference Api ile denemelerinizde Compute butonuna cümlelerin oluşması bitene kadar basmanız gerekmektedir.

# Model ile çıkarım yapmak için örnek kod

from transformers import GPT2Tokenizer, GPT2LMHeadModel

model_name = "cenkersisman/gpt2-turkish-256-token"
tokenizer = GPT2Tokenizer.from_pretrained(model_name)
model = GPT2LMHeadModel.from_pretrained(model_name)

prompt = "okyanusun derinliklerinde bulunan"
input_ids = tokenizer.encode(prompt, return_tensors="pt")
output = model.generate(input_ids, max_length=100, pad_token_id=tokenizer.eos_token_id)
generated_text = tokenizer.decode(output[0], skip_special_tokens=True)
print(generated_text)

Eğitim Süreci Eğrisi
image/png image/png

Sınırlamalar ve Önyargılar

Bu model, bir özyineli dil modeli olarak eğitildi. Bu, temel işlevinin bir metin dizisi alıp bir sonraki belirteci tahmin etmek olduğu anlamına gelir. Dil modelleri bunun dışında birçok görev için yaygın olarak kullanılsa da, bu çalışmayla ilgili birçok bilinmeyen bulunmaktadır.

Model, küfür, açık saçıklık ve aksi davranışlara yol açan metinleri içerdiği bilinen bir veri kümesi üzerinde eğitildi. Kullanım durumunuza bağlı olarak, bu model toplumsal olarak kabul edilemez metinler üretebilir.

Tüm dil modellerinde olduğu gibi, bu modelin belirli bir girişe nasıl yanıt vereceğini önceden tahmin etmek zordur ve uyarı olmaksızın saldırgan içerik ortaya çıkabilir. Sonuçları yayınlamadan önce hem istenmeyen içeriği sansürlemek hem de sonuçların kalitesini iyileştirmek için insanların çıktıları denetlemesini veya filtrelemesi önerilir.

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм

Можно запустить

Подбираем GPU…

Класс архитектуры
GPT2LMHeadModel
Ревизия весов
662f2fa

0 моделей