/ Модель

Характеристики

Контекст
2 048 токенов
Параметры
1,3 млрд
Лицензия
Apache 2.0
Архитектура
llama · dense
Опубликована
30 окт 2023

LLaMA-1B-dj-refine-150B

Генерация текстаТекст → текст4 профессии

Предварительно обученная модель Data-Juicer на базе LLaMA-1.3B для генерации текста и исследований компактных языковых моделей.

300скачиваний за 30 дней3лайкавеса обновлены10 ноя 2023

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Тесты пользователейпока нет

Никто ещё не опубликовал тест этой модели. Соберите бенчмарк из своих задач — результат появится здесь.

  1. Добавьте модель в бенчмарк

    Вместе с другими моделями категории «Текст» — сравнение идёт внутри одной категории.

  2. Опишите свои задачи

    Напишите запросы, при необходимости приложите файлы и эталонные ответы.

  3. Запустите и опубликуйте

    Модели ответят на каждую задачу, судья оценит ответы. Опубликованный результат появится на этой странице.

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

Это базовая языковая модель Data-Juicer семейства LLaMA с архитектурой на 1,3 млрд параметров и реализацией OpenLLaMA. Она предварительно обучена на 150 млрд токенов из очищенных с помощью Data-Juicer наборов RedPajama и Pile, включая веб-тексты, книги, научные материалы, код и другие источники.

Модель предназначена для генерации продолжения текста и исследовательских экспериментов с компактными языковыми моделями. В README сообщается, что она набрала в среднем 34,21 балла на 16 задачах HELM и превзошла указанные модели сравнения по этому показателю. Контекст модели составляет 2048 токенов. Репозиторий содержит веса PyTorch; лицензия — Apache-2.0.

Сценарии применения

  • генерация продолжения текста
  • исследование влияния очистки обучающих данных на качество LLM
  • оценка компактных языковых моделей на задачах HELM

Ограничения

Контекст ограничен 2048 токенами; модель описана как базовая предварительно обученная LLM, поэтому её возможности следования инструкциям и диалога не заявлены.

Для каких профессий подходит4

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

News

Our first data-centric LLM competition begins! Please visit the competition's official websites, FT-Data Ranker (1B Track, 7B Track), for more information.

Introduction

This is a reference LLM from Data-Juicer.

The model architecture is LLaMA-1.3B and we adopt the OpenLLaMA implementation. The model is pre-trained on 150B tokens of Data-Juicer's refined RedPajama and Pile. It achieves an average score of 34.21 over 16 HELM tasks, beating Falcon-1.3B (trained on 350B tokens from RefinedWeb), Pythia-1.4B (trained on 300B tokens from original Pile) and Open-LLaMA-1.3B (trained on 150B tokens from original RedPajama and Pile).

For more details, please refer to our paper.
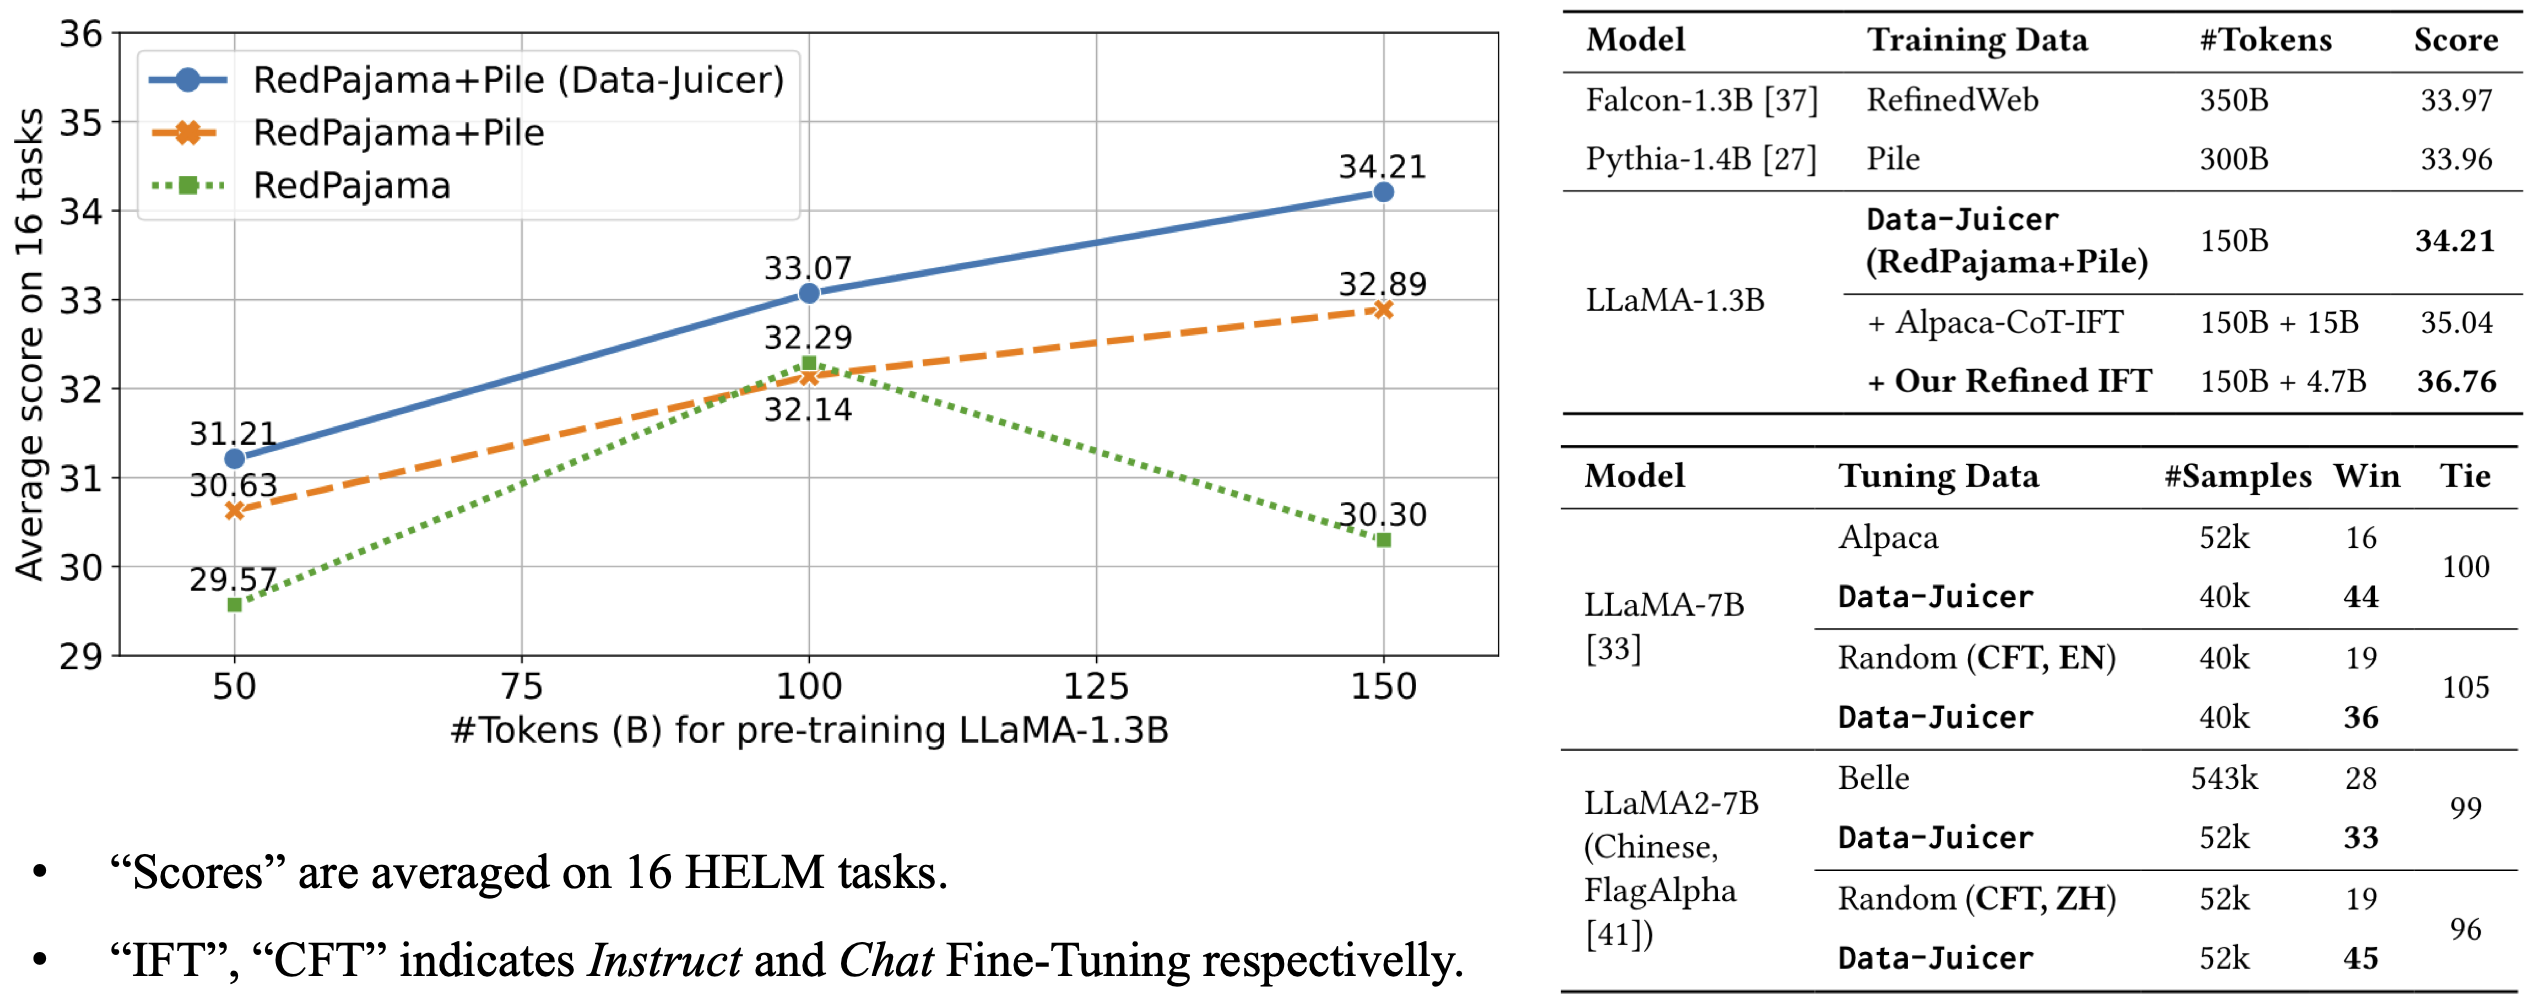
exp_llama

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм

Можно запустить

Подбираем GPU…

Класс архитектуры
LlamaForCausalLM
Ревизия весов
d897aff

0 моделей